
机器翻译
机器翻译(Machine Translation, MT)是将一种语言(源语言)的文本自动翻译成另一种语言(目标语言)的过程。这是NLP中最具挑战性的任务之一,因为它需要深入理解源语言和目标语言的语法、语义和文化背景。
早期方法
基于规则的机器翻译
基于规则的机器翻译是最早的机器翻译方法之一,其核心思想是:
- 使用语言学家编写的规则进行翻译
- 需要大量人工工作来制定规则
- 难以处理例外情况和特殊表达
- 维护成本高,扩展性差
- 对语言变化不敏感
这种方法的主要问题是:
- 规则编写耗时且容易出错
- 难以覆盖所有语言现象
- 规则之间可能存在冲突
- 无法处理新出现的语言现象
统计机器翻译
统计机器翻译(SMT)是机器翻译的一个重要里程碑,它基于概率模型进行翻译:
核心思想
- 使用平行语料库(源语言和目标语言的对应文本)
- 基于概率模型学习翻译规则
- 通过最大似然估计优化模型参数
主要方法
IBM模型系列
- IBM Model 1-5
- 从词对齐到短语对齐
- 逐步引入更复杂的特征
基于短语的翻译
- 将句子分解为短语
- 学习短语级别的翻译规则
- 考虑短语重排序
优势
- 数据驱动,不需要人工规则
- 可以自动学习翻译模式
- 对语言变化有更好的适应性
局限性
- 需要大量平行语料
- 翻译结果可能不流畅
- 难以处理长距离依赖
神经机器翻译NMT
基本概念
神经机器翻译使用神经网络直接将源语言句子映射到目标语言句子,是当前主流的机器翻译方法。
神经网络架构称为sequence-to-sequence (又名seq2seq),它包含两个RNNs。
工作原理
- 将源语言句子编码为向量表示
- 使用解码器生成目标语言句子
- 整个过程端到端训练
核心组件
- 词嵌入层:将词转换为向量
- 编码器:处理源语言序列
- 解码器:生成目标语言序列
- 输出层:预测目标词
优势
端到端训练
- 不需要中间步骤
- 直接优化翻译质量
- 减少错误传播
更好的长距离依赖处理
- 通过循环神经网络捕获长距离关系
- 注意力机制提供全局信息
更好的泛化能力
- 可以处理未见过的词组合
- 对语言变化更敏感
更少的特征工程
- 自动学习特征表示
- 减少人工干预
Seq2Seq
基本架构
Seq2Seq(Sequence to Sequence)模型是神经机器翻译的基础架构,由编码器、解码器两个主要部分组成。
将编码器和解码器连起来,就构成了sequence to sequence的架构。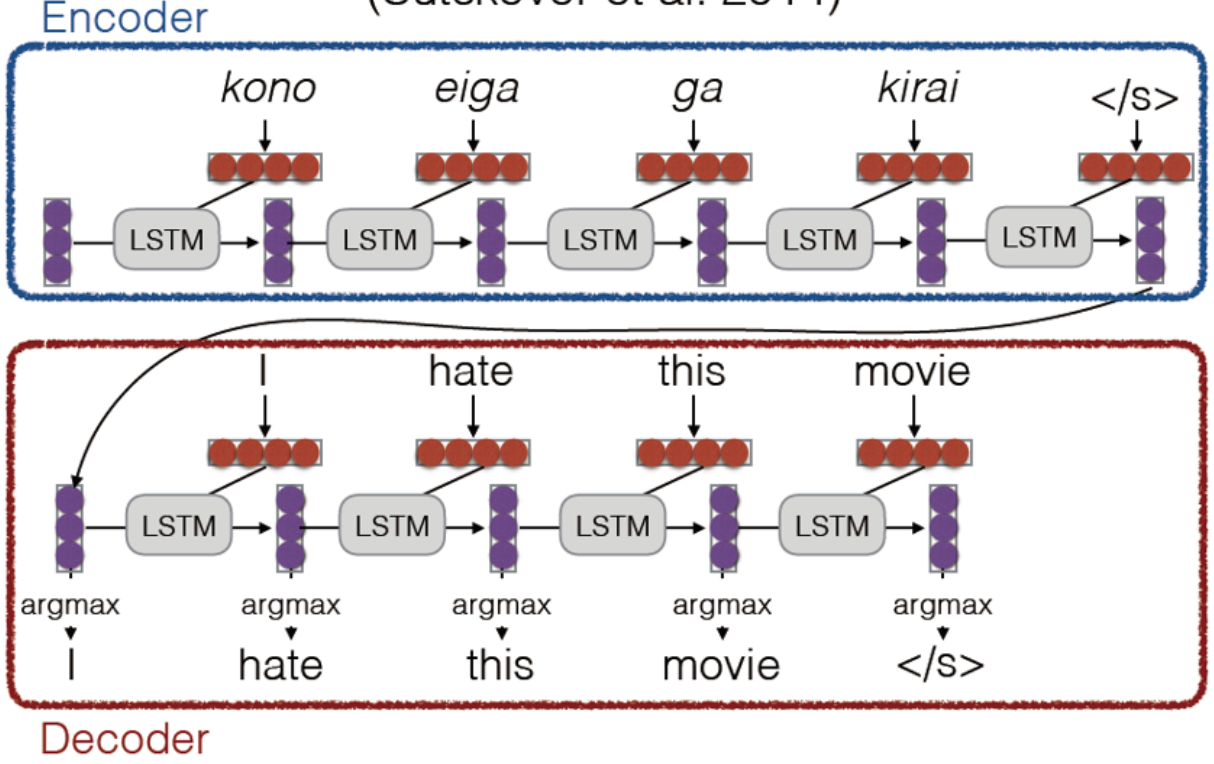
编码器(Encoder)
- 将输入序列编码为固定长度的向量
- 通常使用RNN、LSTM或GRU
- 捕获输入序列的语义信息
- 生成上下文向量
编码器详细结构
词嵌入层
- 将输入词转换为密集向量
- 维度通常为256-512
- 可以预训练或随机初始化
- 使用预训练词向量可以提升性能
- 可以微调或固定词向量
RNN层
- 可以是单向或双向
- 常用LSTM或GRU
- 隐藏状态维度通常为512-1024
- 可以堆叠多层
- 可以使用残差连接
- 可以使用层归一化
输出处理
- 最后一个时间步的隐藏状态作为上下文向量
- 可以连接所有时间步的隐藏状态
- 可以使用注意力机制
- 可以添加额外的投影层
- 可以使用dropout进行正则化
解码器(Decoder)
- 将编码向量解码为目标序列
- 逐词生成输出
- 使用前一个时间步的输出作为当前输入
- 可以访问编码器的信息
解码器详细结构
初始状态
- 使用编码器的最后一个隐藏状态
- 可以添加额外的初始化层
- 可以包含特殊标记(如开始标记)
- 可以使用双向编码器的连接状态
- 可以添加额外的投影层
循环层
- 处理当前输入和前一个状态
- 生成新的隐藏状态
- 可以包含注意力机制
- 可以使用LSTM或GRU
- 可以堆叠多层
- 可以使用残差连接
输出层
- 通常使用softmax
- 预测目标词汇表中的词
- 可以包含额外的投影层
- 可以使用共享权重
- 可以使用温度参数
- 可以使用束搜索
数学表示
对于输入序列 $x = (x_1, ..., x_n)$ 和目标序列 $y = (y_1, ..., y_m)$:
编码器
$$h_t = f_{enc}(x_t, h_{t-1})$$
其中:
- $h_t$ 是时间步 $t$ 的隐藏状态
- $f_{enc}$ 是编码器RNN单元
- $x_t$ 是输入序列的第 $t$ 个词
- $h_{t-1}$ 是前一个时间步的隐藏状态
具体实现
词嵌入:
$$e_t = E[x_t]$$
其中 $E$ 是词嵌入矩阵RNN计算:
$$h_t = \tanh(W_{xh}e_t + W_{hh}h_{t-1} + b_h)$$
对于LSTM:
$$f_t = \sigma(W_f[h_{t-1}, e_t] + b_f)$$
$$i_t = \sigma(W_i[h_{t-1}, e_t] + b_i)$$
$$o_t = \sigma(W_o[h_{t-1}, e_t] + b_o)$$
$$c_t = f_t \odot c_{t-1} + i_t \odot \tanh(W_c[h_{t-1}, e_t] + b_c)$$
$$h_t = o_t \odot \tanh(c_t)$$双向RNN:
$$\overrightarrow{h}_t = f_{enc}(\overrightarrow{h}_{t-1}, x_t)$$
$$\overleftarrow{h}_t = f_{enc}(\overleftarrow{h}_{t+1}, x_t)$$
$$h_t = [\overrightarrow{h}_t; \overleftarrow{h}_t]$$
解码器
$$s_t = f_{dec}(y_{t-1}, s_{t-1}, c)$$ 其中: 初始状态: 解码步骤: 输出概率: 束搜索: 什么是attention?即QKV 模型,transformer 是采用的这种建模方式。 注意力机制解决了Seq2Seq模型中的几个关键问题: 信息压缩问题: 长序列处理: 对齐问题: 对于每个解码时间步 $t$,注意力权重计算如下: $$e_{ti} = a(Q_t, K_i)$$ 其中: 在缩放点积注意力机制中,最后除以根号 k 是为了稳定训练过程中的梯度。解释如下: 问题:点积的大小会随着向量维度增加而增大:因为点积是多个乘积的和,维度越高,求和的项就越多。随着查询向量 q 和键向量 k 的维度增加,它们的点积 $q^Tk$ 的绝对值也会倾向于增大。 因为 softmax 函数对输入值的大小非常敏感,大的点积会导致 softmax 函数的输出值接近0/1。(看softmax函数图像) 小值——梯度消失:如果点积负值极大,softmax 的输出将接近于零。在反向传播过程中,梯度也会接近于零,导致梯度消失。这使得模型难以学习。 大值——梯度爆炸:如果点积正值极大,softmax 的输出对于一个元素将接近于 1,而对于所有其他元素将接近于 0。这可能导致训练不稳定,并可能导致梯度爆炸。 解决方案:除以根号 k。 总之,除以根号k是缩放点积注意力机制中的关键步骤,以防止点积变得太大或太小,这可能导致训练不稳定以及梯度消失/爆炸。它有助于确保 softmax 函数在更稳定的区域中运行,从而使模型能够更有效地学习。 归一化: 多头注意力: $$\alpha_{ti} = \frac{\exp(e_{ti})}{\sum_{j=1}^n \exp(e_{tj})}$$ 其中: 指数化: 归一化: 掩码处理: $$c_t = \sum_{i=1}^n \alpha_{ti}V_i$$ 其中: 与解码器状态结合: 用于预测: 多头注意力: 最简单的注意力计算方式: 优点: 缺点: 计算相似度: 缩放: 掩码和softmax: 应用注意力: 使用前馈神经网络计算注意力: 优点: 缺点: 投影: 相加和激活: 计算分数: 应用注意力: 改进的点积注意力: 优点: 缺点: 计算点积: 缩放: 掩码和softmax: 应用注意力: 多头注意力: 在机器翻译领域,BLEU(Bilingual Evaluation Understudy)是一种常用的自动评价指标,用于衡量机器翻译的质量。BLEU 分数是通过比较机器翻译的输出和人工翻译的参考译文的 n-gram 相似度来计算的。 计算n-gram精确率 应用长度惩罚 ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是一组用于评估文本生成质量(如摘要、翻译等)的指标,主要基于生成文本与参考文本之间的重叠程度计算,核心变体包括ROUGE-N(n-gram重叠)、ROUGE-L(最长公共子序列)、ROUGE-W(加权最长公共子序列)和ROUGE-S(跳跃二元组)。 ROUGE通过量化生成文本与参考文本的相似性来评估质量,其设计初衷是弥补BLEU指标偏重准确率而忽视召回率的缺陷。 主要用于摘要评估,也可用于翻译。 ROUGE-N(n-gram召回率) ROUGE-L(最长公共子序列) ROUGE-W(加权最长公共子序列) ROUGE-S(跳跃二元组) 更全面的评估指标。支持同义词匹配(如 run 和 running)。结合精确率与召回率,更注重语义相关性。 词对齐 计算分数 cs224n里没有,但是都是评估指标一并记录了。 困惑度(Perplexity)是评估语言模型性能的重要指标,用于衡量模型对测试集的预测能力。困惑度越低,表示模型对测试集的预测越准确。 $$PPL = \exp(-\frac{1}{N}\sum_{i=1}^N \log P(w_i|w_{ BERTScore是一种基于BERT的评估指标,通过计算生成文本和参考文本的BERT表示之间的相似度来评估文本生成质量。 获取BERT表示 计算相似度 综合评估 指标选择 注意事项 实际应用 平行语料库稀缺: 领域适应: 低资源语言: 长序列处理: 罕见词处理: 多语言支持: 数据增强: 迁移学习: 多任务学习: 预训练模型:
$$P(y_t|y_{
具体实现
$$s_0 = \tanh(W_{init}h_n + b_{init})$$
$$s_t = \tanh(W_{ys}y_{t-1} + W_{ss}s_{t-1} + W_{cs}c + b_s)$$
$$P(y_t|y_{
$$y_t = \argmax_{y \in V} P(y|y_{
注意力机制
具体看Transformer笔记为什么需要
注意力计算
计算注意力分数
具体过程
$$e_{ti}^h = a^h(Q_t, K_i)$$
$$e_{ti} = \sum_{h=1}^H W^h e_{ti}^h$$计算注意力权重
权重计算细节
计算上下文向量
上下文向量应用
$$s_t = f_{dec}(y_{t-1}, s_{t-1}, c_t)$$
$$P(y_t|y_{
$$c_t^h = \sum_{i=1}^n \alpha_{ti}^h V_i$$
$$c_t = \sum_{h=1}^H W^h c_t^h$$类型
点积注意力
$$a(Q, K) = Q^TK$$
实现细节
1
scores = torch.matmul(query, key.transpose(-2, -1))
1
scores = scores / math.sqrt(d_k)
1
2
3
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
attn_weights = F.softmax(scores, dim=-1)1
context = torch.matmul(attn_weights, value)
加性注意力
$$a(Q, K) = v^T\tanh(W_1Q + W_2K)$$
实现细节
1
2
W1_q = self.W1(query) # [batch_size, 1, d_k]
W2_k = self.W2(key) # [batch_size, seq_len, d_k]1
tanh_output = torch.tanh(W1_q + W2_k)
1
scores = self.v(tanh_output).squeeze(-1)
1
2
attn_weights = F.softmax(scores, dim=-1)
context = torch.matmul(attn_weights.unsqueeze(1), value)缩放点积注意力
$$a(Q, K) = \frac{Q^TK}{\sqrt{d_k}}$$
实现细节
1
scores = torch.matmul(query, key.transpose(-2, -1))
1
scores = scores / math.sqrt(d_k)
1
2
3
if mask is not None:
scores = scores.masked_fill(mask == 0, -1e9)
attn_weights = F.softmax(scores, dim=-1)1
context = torch.matmul(attn_weights, value)
多头注意力(Multi-Head Attention)是一种在Transformer模型中被广泛采用的注意力机制扩展形式,它通过并行地运行多个独立的注意力模块(称为”头”)来获取输入序列的不同子空间的注意力分布,从而更全面地捕获序列中潜在的多种语义关联。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17def multi_head_attention(query, key, value, num_heads):
batch_size = query.size(0)
d_k = query.size(-1) // num_heads
# 线性投影
q = self.q_linear(query).view(batch_size, -1, num_heads, d_k)
k = self.k_linear(key).view(batch_size, -1, num_heads, d_k)
v = self.v_linear(value).view(batch_size, -1, num_heads, d_k)
# 计算注意力
scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(d_k)
attn_weights = F.softmax(scores, dim=-1)
context = torch.matmul(attn_weights, v)
# 合并多头
context = context.view(batch_size, -1, num_heads * d_k)
return self.out_linear(context)
评估指标
机器翻译
BLEU
概念
参数说明
计算方式
$$P_n = \frac{\sum_{C \in \text{Candidates}} \sum_{n\text{-gram} \in C} \text{Count}_{\text{clip}}(n\text{-gram})}{\sum_{C' \in \text{Candidates}} \sum_{n\text{-gram}' \in C'} \text{Count}(n\text{-gram}')}$$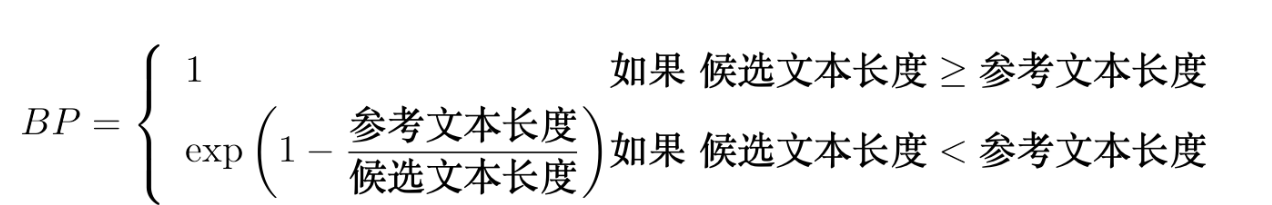
$$BLEU = BP \cdot \exp(\sum_{n=1}^N w_n \log P_n)$$特点
局限性
改进版本
具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29def compute_bleu(reference, candidate, max_n=4):
# 计算n-gram精确率
precisions = []
for n in range(1, max_n + 1):
# 计算候选文本的n-gram
candidate_ngrams = get_ngrams(candidate, n)
# 计算参考文本的n-gram
reference_ngrams = get_ngrams(reference, n)
# 计算精确率
precision = len(candidate_ngrams & reference_ngrams) / len(candidate_ngrams)
precisions.append(precision)
# 计算长度惩罚
if len(candidate) < len(reference):
bp = math.exp(1 - len(reference) / len(candidate))
else:
bp = 1
# 计算最终得分
bleu = bp * math.exp(sum(math.log(p) for p in precisions) / len(precisions))
return bleu * 100
def get_ngrams(text, n):
"""获取文本的n-gram集合"""
ngrams = set()
for i in range(len(text) - n + 1):
ngram = tuple(text[i:i+n])
ngrams.add(ngram)
return ngramsROUGE
概念
参数说明
计算方式
$$ROUGE\text{-}N = \frac{\sum_{S \in \text{References}} \sum_{n\text{-gram} \in S} \text{Count}_{\text{match}}(n\text{-gram})}{\sum_{S \in \text{References}} \sum_{n\text{-gram} \in S} \text{Count}(n\text{-gram})}$$
$$ROUGE\text{-}L = \frac{LCS(X,Y)}{m}$$
其中:
$$ROUGE\text{-}W = \frac{WLCS(X,Y)}{m}$$
$$ROUGE\text{-}S = \frac{\sum_{k=1}^{n} \text{Count}_{\text{match}}(k\text{-skip-bigram})}{\sum_{k=1}^{n} \text{Count}(k\text{-skip-bigram})}$$
指标
核心概念
适用场景
特点
ROUGE-N
n-gram 匹配
翻译、摘要生成
强调词汇和短语的覆盖性
ROUGE-L
最长公共子序列
自动摘要、对话生成
允许跳跃,注重顺序和语义的相似性
ROUGE-W
加权最长公共子序列
文档摘要、内容生成
强调连续匹配,提升流畅性和连贯性
ROUGE-S
跳跃 n-gram 匹配
长文本生成、多文档摘要
捕捉长距离依赖,灵活但保持顺序
应用场景
特点
优势
局限性
具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48def compute_rouge_n(reference, candidate, n=2):
# 获取n-gram
ref_ngrams = get_ngrams(reference, n)
cand_ngrams = get_ngrams(candidate, n)
# 计算匹配的n-gram数量
matches = len(ref_ngrams & cand_ngrams)
# 计算召回率
if len(ref_ngrams) == 0:
return 0
return matches / len(ref_ngrams)
def compute_rouge_l(reference, candidate):
# 计算最长公共子序列
lcs = longest_common_subsequence(reference, candidate)
# 计算ROUGE-L分数
if len(reference) == 0:
return 0
return len(lcs) / len(reference)
def longest_common_subsequence(s1, s2):
"""计算最长公共子序列"""
m, n = len(s1), len(s2)
dp = [[0] * (n + 1) for _ in range(m + 1)]
for i in range(1, m + 1):
for j in range(1, n + 1):
if s1[i-1] == s2[j-1]:
dp[i][j] = dp[i-1][j-1] + 1
else:
dp[i][j] = max(dp[i-1][j], dp[i][j-1])
# 重建最长公共子序列
lcs = []
i, j = m, n
while i > 0 and j > 0:
if s1[i-1] == s2[j-1]:
lcs.append(s1[i-1])
i -= 1
j -= 1
elif dp[i-1][j] > dp[i][j-1]:
i -= 1
else:
j -= 1
return lcs[::-1]
METEOR
特点
优势
参数说明
计算方式
$$METEOR = (1 - \gamma \cdot \text{Fragmentation}) \cdot \frac{P \cdot R}{\alpha \cdot P + (1-\alpha) \cdot R}$$具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56def compute_meteor(reference, candidate, alpha=0.9, beta=3.0, gamma=0.5):
# 词对齐
alignments = align_words(reference, candidate)
# 计算精确率和召回率
precision = len(alignments) / len(candidate)
recall = len(alignments) / len(reference)
# 计算F分数
f_score = (precision * recall) / (alpha * precision + (1 - alpha) * recall)
# 计算碎片惩罚
chunks = count_chunks(alignments)
fragmentation = (chunks - 1) / (len(alignments) - 1) if len(alignments) > 1 else 0
# 计算最终分数
meteor = (1 - gamma * fragmentation) * f_score
return meteor
def align_words(reference, candidate):
"""使用WordNet进行词对齐"""
alignments = []
for i, ref_word in enumerate(reference):
for j, cand_word in enumerate(candidate):
if is_match(ref_word, cand_word):
alignments.append((i, j))
return alignments
def is_match(word1, word2):
"""检查两个词是否匹配(精确匹配、词形变化、同义词)"""
# 精确匹配
if word1 == word2:
return True
# 词形变化匹配
if word1.lower() == word2.lower():
return True
# 同义词匹配
if word1 in wordnet.synsets(word2) or word2 in wordnet.synsets(word1):
return True
return False
def count_chunks(alignments):
"""计算对齐中的连续块数量"""
if not alignments:
return 0
chunks = 1
for i in range(1, len(alignments)):
if alignments[i][0] != alignments[i-1][0] + 1 or \
alignments[i][1] != alignments[i-1][1] + 1:
chunks += 1
return chunks
文本生成
PPL (Perplexity)
概念
参数说明
计算方式
特点
优势
局限性
应用场景
具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
def compute_perplexity(model, test_data):
total_log_prob = 0
total_words = 0
for sentence in test_data:
# 获取模型预测的概率分布
log_probs = model.get_log_probs(sentence)
total_log_prob += sum(log_probs)
total_words += len(sentence)
# 计算困惑度
perplexity = math.exp(-total_log_prob / total_words)
return perplexity
BERTScore
概念
参数说明
计算方式
$$R = \frac{1}{|y|} \sum_{i=1}^{|y|} \max_{j=1}^{|x|} \cos(x_j, y_i)$$
$$P = \frac{1}{|x|} \sum_{j=1}^{|x|} \max_{i=1}^{|y|} \cos(x_j, y_i)$$
$$F = \frac{2PR}{P+R}$$特点
优势
局限性
应用场景
具体实现
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
def compute_bertscore(candidate, reference, model_name='bert-base-uncased'):
# 加载BERT模型
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertModel.from_pretrained(model_name)
# 获取BERT表示
def get_bert_embeddings(text):
tokens = tokenizer(text, return_tensors='pt', padding=True, truncation=True)
with torch.no_grad():
outputs = model(**tokens)
return outputs.last_hidden_state
# 计算相似度
def compute_similarity(emb1, emb2):
return torch.nn.functional.cosine_similarity(emb1, emb2, dim=-1)
# 获取候选文本和参考文本的BERT表示
cand_emb = get_bert_embeddings(candidate)
ref_emb = get_bert_embeddings(reference)
# 计算精确率和召回率
precision = compute_similarity(cand_emb, ref_emb).mean()
recall = compute_similarity(ref_emb, cand_emb).mean()
# 计算F1分数
f1 = 2 * precision * recall / (precision + recall)
return f1.item()
对比
特点
BLEU
ROUGE
METEOR
PPL
BERTScore
考虑语义
❌
❌
✅
❌
✅
考虑同义词
❌
❌
✅
❌
✅
考虑词序
❌
✅
✅
✅
✅
需要参考文本
✅
✅
✅
❌
✅
计算效率
高
高
中
高
低
多语言支持
✅
✅
✅
✅
✅
人工相关性
中
中
高
低
高
使用建议
实际应用的挑战
数据问题
模型问题
解决方案