
参考:
设计总览
操作系统位于应用程序与硬件之间,职责是抽象、隔离、复用、管理硬件资源。
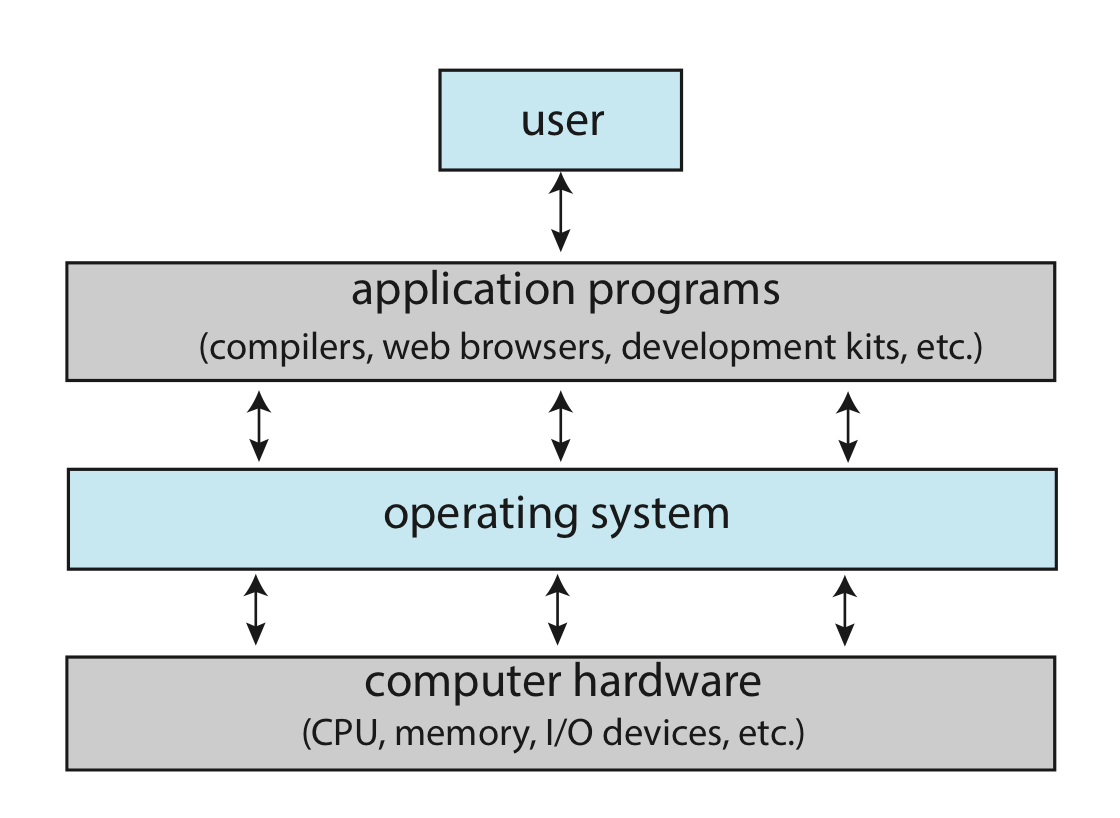
【OS可以看做是一种特殊的软件】
- 硬件底座:CPU、内存、磁盘/SSD、RAID、分区/分卷、外设
- 五大管理:进程、内存、文件、设备、网络
- 内核机制:中断/异常、调度、同步、虚拟内存、I/O、死锁处理
- 用户视角:进程、线程、文件、网络、Shell
- 唯一合法入口:系统调用(用户态 ↔ 内核态)
核心矛盾:硬件有限、程序众多
- 程序希望独占、系统必须共享
- OS 用时间片切分 CPU、用虚拟地址切分内存、用文件系统统一存储,在隔离与效率之间做权衡。
由此,我认为的核心设计原则:公平、高效、稳定、权限
全文脉络
按“先舞台 → 再入口 → 再资源管理 → 再存储与 I/O → 最后串联”阅读:
| 顺序 | 章节 | 回答的问题 |
|---|---|---|
| 1 | 设计总览 | OS 做什么?如何从单道演进到分时?内核宏/微如何组织? |
| 2 | 硬件基础 | CPU/CPI、进程地址空间、磁盘几何与访问时间、RAID、分区/格式化/分卷 |
| 3 | 中断与异常 | 硬件如何打断 CPU?系统调用如何陷入内核? |
| 4 | 进程 → 调度 → 同步 → 死锁 | 谁在跑、怎么排队、如何协作、如何避免卡住 |
| 5 | 内存管理 | 连续分配与碎片 → 分页/TLB/缺页/置换 → 分段 |
| 6 | 文件系统 | 磁盘/内存结构、VFS、常见 FS、open/read/write… |
| 7 | I/O 与设备 | 控制方式、驱动、磁盘调度(访问时间公式与硬件章互补) |
| 8 | 总结 | 用 cat 故事把各章串成一条执行路径 |
▸磁盘相关内容如何分布
- 硬件基础:CHS、访问时间计算、RAID、分区与格式化(物理/逻辑准备)
- 文件系统:在分区上建超级块/inode、VFS、文件操作
- I/O 与设备:控制方式、驱动、磁盘调度算法与例题
公式与例题可重复出现于硬件章与 I/O 章,前者偏容量/单次访问,后者偏调度动机与队列例题。
设计的演进
OS 本质是“自动化地让计算机完成一系列任务”。随着需求扩大,任务的组织方式经历两个阶段、三种设计:单道批处理 → 多道批处理 → 分时系统。
单道批处理
(Batch Processing,单道)
- 批处理:任务成批交付,OS 自动按顺序串行执行
- 单道:同一时刻内存中只有一道程序,当前任务结束前不切换
- 意义:实现初步自动化,摆脱纯人工干预对效率的限制
- 缺陷:任务发起 I/O 时 CPU 只能空等;尤其等键盘等人工 I/O,CPU 长期空闲,不可接受
多道批处理
(multiprogramming,多道)
- 多道:内存中同时驻留多个进程
- 核心策略:当前任务发起 I/O 时,CPU 转去执行其他任务,尽量不空闲
- 宏观并发、微观串行:宏观看多个任务同时推进(A 未完 B 已始);微观仍是单 CPU 串行,只是以“按 I/O 切分后的子任务”为调度单元
- 收益:提高 CPU 利用率与吞吐量
- 代价:引入进程调度问题,实现更复杂(详见进程/调度章)
▸并发 ≠ 并行
并发(concurrency)指一段时间内多个任务交替推进,单核即可实现;并行(parallelism)指同一时刻多个任务真正同时运行,需多核/多处理器。多道批处理与分时系统靠切换实现并发,而非并行。
▸甘特图:单道 vs 多道 CPU 利用率
单 CPU,独立设备 X、Y。
- A 顺序需求:CPU 10s → X 5s → CPU 5s → Y 10s → CPU 10s(CPU 共 25s)
- B 顺序需求:X 10s → CPU 10s → Y 5s → CPU 5s → Y 10s(CPU 共 15s)
单道(先 A 后 B):总时长 = 40 + 40 = 80s,CPU 忙 = 25 + 15 = 40s,利用率 = 40/80 = 50%。
多道(I/O 时切换 CPU):
1
2
3
4
5
时刻 0 10 15 20 25 30 35 45
CPU |A |B |A |B | |A |
| 10 | 10 |5 |5 | (空5) | 10 |
X |B(0-10)|A(10-15)|
Y | |B(20-25)|A(25-35)|B(35-45)|
A 结束于 45,B 结束于 45;总时长 = 45s,CPU 忙 = 40s,仅 30–35 空闲。利用率 = 40/45 ≈ 88.9%。分母(总时长)从 80 降到 45,也直观体现吞吐量的提升。
▸批处理为何不适合现代系统
无论单道多道,批处理交互性极差:一批任务提交后用户无法插手、无法同时做别的事。例如边跑程序边看视频,二者会互相抢 I/O 与 CPU、彼此阻塞,体验无法接受。因此需要“体感并行”的分时系统。
分时系统
(time sharing systems)
- 定位:多任务(multitasking)的具体实现;multitasking 是 multiprogramming 的逻辑扩展,同样满足“内存多进程、一段时间多任务并进”
- 机制:按**时间片(time slice)**轮流把 CPU 分给各进程;时间片足够短则体感近似并行(非真并行,真并行需多核)
- 收益:多用户可同时使用同一台机器,任务相互独立、及时响应,缩短最长周转时间,支持人机对话
内核结构设计
随着功能膨胀,OS 软件的结构设计愈发关键,主要有以下思路。
宏内核
(monolithic kernel,单内核/大内核)
- 思想:所有主要功能紧密耦合为一个整体,全部运行在内核态
- 优点:模块间直接调用,效率极高;主流 OS 多由此发展而来
- 缺点:功能高度耦合,维护困难;任一部分严重出错可能拖垮整个系统
- 代表:Linux
分层设计
- 思想:把内核划分为若干层,每层只依赖其下层、只为其上层提供服务
- 优点:结构清晰、便于调试与验证
- 缺点:层次划分困难,跨层调用带来性能开销
微内核
(microkernel)
- 思想:与宏内核相反,仅把最基本功能(通信、内存管理、进程管理)留在内核态,其余(文件系统、驱动等)移到用户态作为“服务器”,经消息传递与内核交互
- 优点:内核体积小、易维护易扩展、自身效率高;模块解耦且运行于用户态,单个服务崩溃不影响整体,可靠性高
- 缺点:频繁消息传递/上下文切换带来性能损耗
模块化设计
- 思想:内核由可动态加载/卸载的模块组成(如 Linux 的内核模块 LKM)
- 优点:兼顾宏内核的效率与一定的可扩展性,按需加载
- 本质:仍属宏内核范畴,是其工程化改良
混合系统
- 思想:折中宏内核与微内核——保留微内核的分层与模块化组织,同时把性能敏感的服务放回内核态以保效率
- 现状:当今主流桌面 OS 多为混合内核
- 代表:Windows NT、macOS(XNU)
▸对比
宏内核求快(全在内核态),微内核求稳/可维护(多在用户态、消息通信),混合内核在两者间折中,是现代主流。
硬件基础
CPU
1 | ┌─────────────────┐ |
- 寄存器:PC(下一条指令)、SP(栈顶)、通用寄存器、状态寄存器
- ALU:算术与逻辑运算
- 控制单元:取指 → 译码 → 执行 → 访存 → 写回
- 缓存:L1(最快最小)→ L2 → L3(最慢较大,多核共享)
- 时钟周期:CPU 最小时间单位;指令通常跨多个周期
- 特权级:Ring 0(内核)可执行特权指令;Ring 3(用户)受限
CPI 与 CPU 时间
性能分析常用三要素:指令数 IC、CPI、时钟频率 $f$(或时钟周期 $T=1/f$)。
- CPI(Cycles Per Instruction):平均每条指令消耗的时钟周期数
- IPC(Instructions Per Cycle):$ \mathrm{IPC} = 1/\mathrm{CPI} $,流水线理想情况接近 1,超标量可 $>1$
基本公式:
$$ T_{\mathrm{CPU}} = IC \times CPI \times T = \frac{IC \times CPI}{f} $$
按指令类加权平均 CPI($F_i$ 为第 $i$ 类指令占比,$CPI_i$ 为其单类 CPI):
$$ CPI = \sum_i \bigl( F_i \times CPI_i \bigr),\quad \sum_i F_i = 1 $$
吞吐指标 MIPS(百万条指令/秒):
$$ \mathrm{MIPS} = \frac{f}{CPI \times 10^{6}} = \frac{IC}{T_{\mathrm{CPU}} \times 10^{6}} $$
加速比(同一程序、优化前后):
$$ S = \frac{T_{\mathrm{old}}}{T_{\mathrm{new}}} $$
▸使用注意
- 主频高不等于更快:$T_{\mathrm{CPU}}$ 由 $IC$、$CPI$、$f$ 三者共同决定。
- MIPS 跨 ISA/编译器时不宜直接比:指令“条”的语义不同。
- 优化可作用在不同因子上:编译器降 $IC$,缓存/流水线降 $CPI$,工艺升 $f$。
▸计算题:多类指令 + 缓存优化 + 编译优化
某程序 $IC = 5 \times 10^{8}$,时钟频率 $f = 2.5\,\mathrm{GHz}$,指令构成如下:
| 类型 | 占比 $F_i$ | $CPI_i$ |
|---|---|---|
| ALU | 40% | 1 |
| Load | 25% | 4 |
| Store | 15% | 3 |
| Branch | 20% | 2 |
(1) 求平均 CPI、CPU 时间、MIPS
$$ CPI = 0.4\times 1 + 0.25\times 4 + 0.15\times 3 + 0.2\times 2 = 0.4 + 1.0 + 0.45 + 0.4 = 2.25 $$
$$ T_{\mathrm{CPU}} = \frac{5\times 10^{8} \times 2.25}{2.5\times 10^{9}} = \frac{1.125\times 10^{9}}{2.5\times 10^{9}} = 0.45\,\mathrm{s} $$
$$ \mathrm{MIPS} = \frac{2.5\times 10^{9}}{2.25\times 10^{6}} = \frac{2500}{2.25} \approx 1111.11 $$
(2) 改进缓存使 Load 的 $CPI$ 降为 2,其余不变,求加速比
$$ CPI' = 0.4\times 1 + 0.25\times 2 + 0.15\times 3 + 0.2\times 2 = 1.75 $$
$$ T' = \frac{5\times 10^{8} \times 1.75}{2.5\times 10^{9}} = 0.35\,\mathrm{s},\quad S = \frac{0.45}{0.35} \approx 1.286\times $$
(3) 优化编译器使指令数减少 15%(各类占比不变),且 Branch 的 $CPI$ 因更好预测变为 1.5,$f$ 不变;相对原系统的加速比
$$ IC'' = 5\times 10^{8} \times 0.85 = 4.25\times 10^{8} $$
$$ CPI'' = 0.4\times 1 + 0.25\times 4 + 0.15\times 3 + 0.2\times 1.5 = 2.15 $$
$$ T'' = \frac{4.25\times 10^{8} \times 2.15}{2.5\times 10^{9}} = \frac{9.1375\times 10^{8}}{2.5\times 10^{9}} = 0.3655\,\mathrm{s} $$
$$ S = \frac{0.45}{0.3655} \approx 1.231\times $$
可见:(2) 只降 Load 的 CPI,加速约 28.6%;(3) 同时降 IC 与 Branch CPI,加速约 23.1%。两者优化路径不同,不能单看主频或单一因子。
内存布局
1 | 物理内存布局: |
典型用户进程虚拟地址空间(低 → 高):
- 代码段:只读指令
- 数据段:已初始化全局/静态变量
- BSS:未初始化全局/静态变量
- 堆:
malloc/new向上增长 - 栈:局部变量、函数调用帧,向下增长
- 内核空间:高地址,用户程序不可直接访问
▸栈与堆
栈由编译器/调用约定自动管理,速度快、生命周期随函数;堆由程序员或运行时显式申请释放,灵活但易碎片与泄漏。两者相向增长,中间为未映射空洞。
磁盘与 SSD
单次访问时间(机械盘,408 常考):
$$ T_{\mathrm{access}} = T_{\mathrm{seek}} + T_{\mathrm{rotate}} + T_{\mathrm{transfer}} $$
- 寻道时间 $T_{\mathrm{seek}}$:磁头移到目标柱面;与移动柱面数相关,题面常直接给平均寻道时间
- 旋转延迟 $T_{\mathrm{rotate}}$:等目标扇区转到磁头下;平均取半圈 $\dfrac{60}{2r}\,\mathrm{ms}$($r$ 为转速 rpm)
- 传输时间 $T_{\mathrm{transfer}}$:读/写数据;$\dfrac{b}{v}$,$b$ 为字节数,$v$ 为磁盘数据传输速率
柱面-磁头-扇区(CHS)与容量:
$$ \text{容量} = \text{柱面数} \times \text{每柱面磁道数(盘面数)} \times \text{每磁道扇区数} \times \text{扇区大小} $$
同一柱面、不同盘面的磁道构成柱面(Cylinder);磁道(Track) 是单盘上一圈;扇区(Sector) 是磁道上最小读写单位。详细结构与 I/O 时间分解见 I/O 与设备 → 磁盘调度。
- SSD:无机械寻道,随机读快;仍有写入放大、磨损均衡、GC;调度重心转向合并请求与多队列(NVMe)
▸磁盘访问时间(跨柱面 + 同柱面连续扇区)
磁盘:7200 rpm,平均寻道 $T_{\mathrm{seek}}=8\,\mathrm{ms}$,600 扇区/磁道,扇区 512 B。
(1) 读 1 个扇区(随机柱面)
$$ T_{\mathrm{rotate,avg}} = \frac{60}{2 \times 7200} \times 10^{3} = 4.17\,\mathrm{ms} $$
$$ T_{\mathrm{transfer,1}} = \frac{1}{600} \times \frac{60}{7200} \times 10^{3} \approx 0.0139\,\mathrm{ms} $$
$$ T_{\mathrm{access}} \approx 8 + 4.17 + 0.014 \approx 12.18\,\mathrm{ms} $$
(2) 寻道已到目标柱面后,连续读 20 个扇区(同磁道)
寻道只做一次,旋转延迟平均仍约 4.17 ms;传输按 20 扇区计:
$$ T = 4.17 + 20 \times 0.0139 \approx 4.45\,\mathrm{ms} $$
(3) 读 3 个扇区,分属 3 个不同柱面(最坏需 3 次寻道)
$$ T \approx 3 \times (8 + 4.17 + 0.014) \approx 36.55\,\mathrm{ms} $$
同柱面连续读可合并寻道;跨柱面则寻道主导延迟。
▸CHS 与容量
5 盘面、666 柱面、16 扇区/磁道、512 B/扇区。
(1) 总容量
$$ 666 \times 5 \times 16 \times 512 = 27{,}320{,}256\,\mathrm{B} \approx 26.05\,\mathrm{MiB} $$
(2) 逻辑块号 LBA 与柱面
设柱面 $C$、磁头 $H$(0–4)、扇区 $S$(1–16,部分教材从 0 起编,题面以给定为准)。每柱面扇区数 = $5 \times 16 = 80$。
文件占 250 KB = 512000 B → 需 $\lceil 512000 / 512 \rceil = 1000$ 扇区 → 至少 $\lceil 1000/80 \rceil = 13$ 柱面(连续存放、无碎片时)。
RAID
(Redundant Array of Independent Disks,独立磁盘冗余阵列)
多块物理盘组合为一个逻辑卷,通过数据分布与冗余同时改善容量、速度或容错。单盘故障时数据可能全丢;RAID 用额外空间换 survivability。
▸单盘 vs RAID
单盘 1TB、150 MB/s:容量、速度、可靠性都绑在一项硬件上。RAID 把问题拆成三个维度:容量(多盘叠加)、速度(并行 I/O)、可靠性(镜像或校验)。
三项核心技术
条带化(Striping)
文件切成固定大小条带(Stripe,常见 64KB–1MB),轮流写到不同磁盘。N 盘条带化后,顺序读写理论带宽约 N 倍。
▸条带化类比
一份 9 页报告,3 块盘:页 1–3 放盘 A,页 4–6 放盘 B,页 7–9 放盘 C。三人同时搬,比一人串行快。代价:任一盘损坏,整份报告缺页,无法读(RAID 0 无冗余)。
镜像(Mirroring)
同一份数据写入两块(或多块)盘。容量利用率 50%(2 盘镜像),但一块盘坏,另一块仍有完整副本。
▸镜像类比
重要合同复印两份,分别锁在两个柜子。丢一把钥匙(坏一块盘)仍能取出另一份。写操作需同时写两份,写速度通常不超过单盘。
奇偶校验(Parity)
用 XOR(异或) 在多块数据盘之外维护校验信息;坏一块盘时,对其余盘与校验做 XOR 可重建丢失数据。
性质:$A \oplus B \oplus B = A$;故 $B_{\mathrm{lost}} = A \oplus C \oplus P$(其中 $P = A \oplus B \oplus C$)。
▸XOR 恢复(4 位示意)
| 盘 A | 盘 B | 盘 C | 校验 P |
|---|---|---|---|
| 1011 | 1100 | 0111 | 0000 |
盘 B 损坏:$B = A \oplus C \oplus P = 1011 \oplus 0111 \oplus 0000 = 1100$,与原始 B 一致。
RAID 级别
| 级别 | 最少盘 | 容量率 | 读 | 写 | 容错 | 写惩罚 | 要点 |
|---|---|---|---|---|---|---|---|
| RAID 0 | 2 | 100% | N× | N× | 0 | 1 | 纯条带,无冗余 |
| RAID 1 | 2 | 50% | N× | 1× | N−1 | 2 | 纯镜像 |
| RAID 5 | 3 | (N−1)/N | ≈N× | 较慢 | 1 | 4 | 分布式校验,最常用 |
| RAID 6 | 4 | (N−2)/N | ≈N× | 慢 | 2 | 6 | 双校验 P+Q |
| RAID 10 | 4 | 50% | N× | N/2× | 每组坏 1 | 2 | 先镜像再条带 |
RAID 0
- 仅条带,无冗余;任一盘坏则全部数据不可用
- 适用:可重建的临时数据(渲染缓存、编译中间文件)
RAID 1
- 镜像;读可从任一盘并行,写需双写
- 适用:系统盘、小容量高可靠场景(双盘 NAS)
RAID 2 / 3 / 4
- RAID 2:位级条带 + 汉明码 → 已淘汰
- RAID 3:字节级条带 + 专用校验盘 → 校验盘成瓶颈
- RAID 4:块级条带 + 专用校验盘 → 小文件略好,校验盘仍是热点
现代系统基本被 RAID 5/6 取代。
RAID 5
- 块级条带 + 校验分散到各盘(无单独校验盘)
- 4×1TB → 可用约 3TB;允许 坏 1 块 后重建
- 写惩罚 = 4:改一个条带需“读旧数据 + 读旧校验 → 算新校验 → 写数据 + 写校验”,一次逻辑写 ≈ 4 次磁盘 I/O
▸RAID 5 写惩罚
把 RAID 5 想成“三人合写笔记 + 第四人记校验和”。改 A 页一个字时,必须先看 A 旧内容、看校验页旧值,重算校验,再写回 A 和校验页——改一行,动四遍纸。所以 RAID 5 读多写少(文件服务器、备份盘)更合适,数据库随机写多常选 RAID 10。
RAID 6
- 在 RAID 5 基础上增加第二套校验 Q(Reed-Solomon),与 XOR 的 P 独立
- 4×1TB → 可用约 2TB;允许 同时坏 2 块
- 写惩罚 6;大容量盘重建需十数小时,重建期间再坏一块的风险使 RAID 6 在大盘时代更常见
▸重建窗口
8TB RAID 5 重建可能需读取其余全盘数据,持续数小时。此间磁盘高负载,第二块盘故障概率上升。RAID 6 允许多坏一块,为重建争取时间。
RAID 10 与 RAID 01
- RAID 10(1+0):先镜像成对,再条带 — 推荐
- RAID 01(0+1):先条带成组,再镜像
▸10 vs 01(4 盘)
盘 1–2 为一对镜像,盘 3–4 为另一对,再条带 → RAID 10。坏盘 1 和盘 3(不同对)系统仍存活。
RAID 01 若坏在同一原条带组内的两块,可能整组失效。关键业务(数据库)优先 RAID 10。
实现方式
| 方式 | 实现 | 优点 | 缺点 |
|---|---|---|---|
| 软件 RAID | OS 驱动(Linux mdadm、Windows Storage Spaces) |
免费、灵活 | 占 CPU,性能随负载波动 |
| 硬件 RAID | 独立 RAID 卡 + 缓存(BBU) | 不占主机 CPU,性能稳定 | 成本高,卡故障可能难恢复 |
| Fake RAID | 主板 BIOS 模拟,实际靠 OS 驱动 | 成本低 | 兼容性差,不如真硬件 RAID |
局限与误区
RAID ≠ 备份
RAID 防单盘硬件故障,不防:误删(rm -rf)、病毒加密、文件系统损坏、火灾盗窃。重要数据仍需 3-2-1 备份(3 份、2 种介质、1 份异地)。
▸容错 vs 备份
RAID 像给仓库加备用货架——一个货架塌了还能从另一货架取货;备份像把货物再复印一份存到另一栋建筑。前者防硬件,后者防人为与灾难。
其他注意
- 重建风险:见 RAID 6 说明;大盘时代 RAID 5 争议增多
- SSD + RAID 5/6:SSD 自身有写入放大,叠加 RAID 写惩罚会加速磨损;SSD 阵列常用 RAID 1 或 10
选型参考
| 场景 | 推荐 | 理由 |
|---|---|---|
| 双盘 NAS | RAID 1 | 简单可靠 |
| 四盘 NAS | RAID 5 或 6 | 容量与容错平衡 |
| 数据库 / 高并发随机 I/O | RAID 10 | 读写性能 + 容错 |
| 视频缓存 / 可重建临时数据 | RAID 0 + 外部备份 | 速度优先 |
| 冷归档 / 大容量 | RAID 6 | 允许重建期间再坏一盘 |
| 系统盘 | RAID 1 | 实现简单 |
▸权衡本质
RAID 是在容量、速度、可靠性三者间取舍:RAID 0 换速度丢安全,RAID 1 换空间换安全,RAID 5/6 用一块(或两块)盘的空间换容错,RAID 10 用一半容量换性能与容错。无万能方案,只有匹配场景的选择。
分区与格式化
从物理盘到用户可见的“C: / D: / /home”,中间经过三层抽象:
1 | 硬件层:物理磁盘(HDD / SSD) |
▸一句话区分
分区 = 切蛋糕(物理划定起止扇区);格式化 = 在蛋糕上画格子(建文件系统元数据);分卷 = 把几块蛋糕拼成更大一块(逻辑聚合,可跨盘)。
格式化
格式化 = 在存储介质上建立文件系统,使 OS 能按文件读写。并非“擦除数据”,而是重写管理结构;旧数据通常仍在,仅被标为可覆盖。
低级 vs 高级
| 低级格式化(Low-level) | 高级格式化(High-level) | |
|---|---|---|
| 作用 | 划分磁道/扇区、写扇区头与 ECC、标记出厂坏块 | 建立 FS 结构(超级块、位图、inode 表等) |
| 谁做 | 出厂或维修;用户几乎不做 | 日常“格式化”即此 |
| 速度 | 极慢(可达数小时) | 快(秒级) |
快速 vs 完全
| 快速格式化 | 完全格式化 | |
|---|---|---|
| 操作 | 只重建 FS 元数据 | 重建元数据 + 扫描扇区 |
| 坏块检测 | 无 | 有,可标记坏块 |
| 旧数据恢复 | 较易 | 较难 |
| 时间 | 几秒 | 可达数小时 |
高级格式化写入的结构(超级块、inode、位图等)见 文件系统 → 实现结构。
分区
整块盘若不切分,系统区、数据区、备份区混在一起难以管理。分区把连续扇区划成若干固定区域,每区可独立格式化、装不同 FS。
MBR
(Master Boot Record,1983)
磁盘第 0 扇区共 512 B:引导代码(446 B)+ 分区表(64 B)+ 签名 0x55AA。
- 最多 4 个主分区;可改为 3 主 + 1 扩展分区,扩展内再建逻辑分区以突破 4 个限制
- 32 位寻址 × 512 B 扇区 → 单盘/单分区最大约 2 TB
GPT
(GUID Partition Table,UEFI 时代标准)
- 最多约 128 个分区;每分区用 64 位 GUID 标识
- 容量上限约 18 EB;分区表有备份,损坏可恢复
- 前部保留保护性 MBR,兼容只认 MBR 的旧工具
▸新买 1TB 盘怎么用
- 分区:建 GPT;划 200GB 系统区 + 800GB 数据区
- 格式化:两区分别 format 为 NTFS 或 ext4(写超级块、inode 等)
- 挂载:Windows 分配盘符;Linux
mount /dev/sda1 /… - (可选)多块盘时再建跨区卷 / 带区卷 / 镜像卷
分卷
分区 vs 分卷
| 分区 Partition | 分卷 Volume | |
|---|---|---|
| 层级 | 物理切分(绑定单盘) | 逻辑抽象 |
| 跨盘 | 否 | 可以(跨区、带区、镜像等) |
| 灵活性 | 改大小通常需停机/重划 | 可在线扩展(尤以 LVM) |
| 代表 | MBR/GPT 分区项 | Windows 动态磁盘;Linux LVM |
▸何时需要分卷
单盘单用途 → 分区 + 格式化即可。需要“多盘拼成一个大盘符”“在线扩容”“软件层 RAID”时,才上分卷(LVM / 动态磁盘)。
Windows 动态磁盘
| 类型 | 含义 | 对应 |
|---|---|---|
| 简单卷 | 单盘单区域 | ≈ 普通分区 |
| 跨区卷 | 多盘空间顺序拼接 | 先写满盘 1 再写盘 2;无加速、无冗余 |
| 带区卷 | 条带并行 | ≈ RAID 0 |
| 镜像卷 | 双写备份 | ≈ RAID 1 |
| RAID-5 卷 | 分布式校验 | ≈ RAID 5 |
带区/镜像/RAID-5 细节见上文 RAID。
Linux LVM
层次:物理盘 → PV(Physical Volume)→ VG(Volume Group,容量池)→ LV(Logical Volume)→ 再格式化、挂载。
| 能力 | 说明 |
|---|---|
| 在线扩容 | 加盘入 VG,再扩展 LV,无需重分区停机 |
| 快照 | 瞬时创建某时刻副本,便于备份 |
| 条带/镜像 | 软件层类似 RAID 0/1 |
| 迁移 | 数据可在新旧盘间搬迁,用户路径不变 |
▸LVM 扩容
/home 所在 LV 满了:插入新盘 → pvcreate → 加入 VG → lvextend 扩大 LV → resize2fs 扩大文件系统。用户仍访问 /home,无需改分区表。
中断与异常
区分
| 中断(Interrupt) | 异常(Exception) | |
|---|---|---|
| 来源 | 外部设备异步打断 | 当前指令执行中同步发生 |
| 例子 | 时钟、网卡、磁盘完成、键盘 | 除零、缺页、非法指令、系统调用 |
| 返回 | 通常返回下一条指令 | 可能重执当前指令(如缺页) |
外部中断
- 时钟中断:周期性触发,驱动时间片调度与定时器
- I/O 中断:磁盘/网卡完成传输后通知 CPU
- 输入设备中断:键盘、鼠标事件
内部异常
- 故障(Fault):可纠正后重执,如缺页
- 陷阱(Trap):主动陷入,如系统调用、断点
- 中止(Abort):严重错误,进程或系统难以继续
处理流程
- 硬件保存关键现场(PC、寄存器、特权级)
- 查中断向量表 / IDT,定位处理例程
- 进入内核执行处理函数
- 恢复现场,返回用户程序(或调度其他进程)
系统调用
用户程序不能直接访问硬件或修改页表,必须经系统调用请求内核服务。系统调用是用户态与内核态之间的稳定契约;libc 再封装为更友好的 API。
典型路径(x86 示意):
- 用户把调用号放入寄存器(如
eax) - 执行
int 0x80或syscall - CPU 切到 Ring 0,查
sys_call_table - 执行内核函数(如
sys_read) - 结果写回寄存器,返回 Ring 3
| 类别 | 典型调用 | 作用 |
|---|---|---|
| 信息维护 | getpid, gettimeofday, uname |
读进程/系统元信息 |
▸打开文件
用户代码调用 open("/tmp/a.txt", O_RDONLY) → libc 封装系统调用 → 内核路径解析、权限检查、分配文件描述符 fd → 返回 fd 或错误码。此后 read(fd, ...) 再经同类路径进入内核。
进程
定义
进程 = 程序的一次执行实例 = 代码 + 数据 + 打开文件 + 寄存器状态 + 独立地址空间。
PCB(进程控制块)记录:PID、状态、PC、寄存器现场、地址空间信息、打开文件表、优先级、父子关系等。PCB 是内核调度与切换的依据。
状态转换
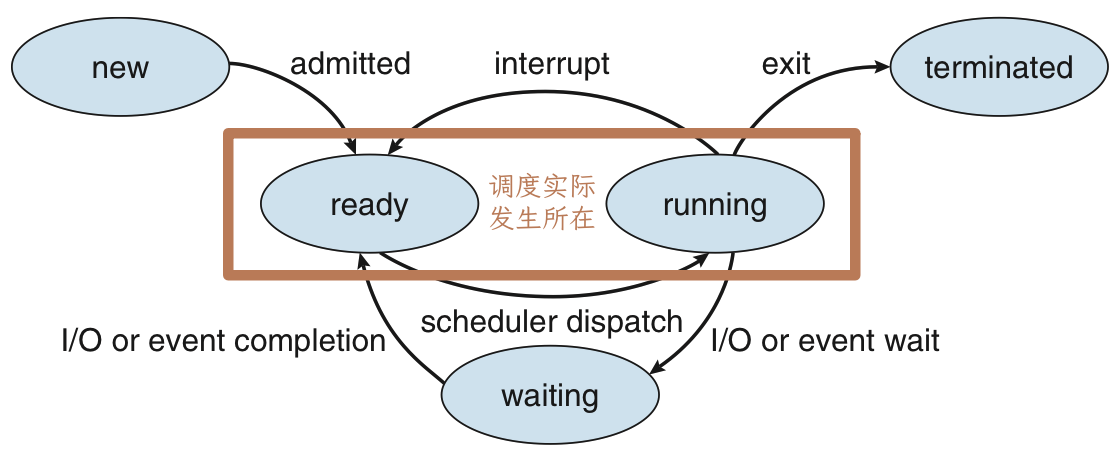
- 创建:分配 PCB 与资源,进入就绪
- 就绪 → 运行:调度器选中
- 运行 → 就绪:时间片用尽或被抢占
- 运行 → 阻塞:等待 I/O、锁、信号等
- 阻塞 → 就绪:等待事件完成
- 运行 → 终止:
exit或被杀;父进程wait回收
进程与线程
| 进程 | 线程 | |
|---|---|---|
| 地址空间 | 独立 | 同进程内共享 |
| 切换开销 | 大(页表、TLB) | 小(主要换寄存器) |
| 通信 | IPC | 共享变量(需同步) |
| 故障隔离 | 强 | 一线程崩溃可拖垮进程 |
进程是资源分配单位;线程是 CPU 调度的基本单位(现代 OS 常见模型)。
创建与回收
fork:复制当前进程;子进程返回 0,父进程返回子 PID;写时复制(COW)延迟物理页复制exec:用新程序镜像替换当前地址空间exit:释放用户资源,变为僵尸,等待父进程回收wait/waitpid:父进程回收子进程退出状态,消除僵尸
| 相关系统调用 | 作用 |
|---|---|
fork |
创建子进程,复制地址空间(COW) |
execve |
加载新程序镜像,替换当前进程代码与数据 |
exit |
终止进程,释放用户资源,保留 PCB 待回收 |
wait / waitpid |
父进程等待子进程结束并回收 |
kill |
向进程发信号(如 SIGTERM 终止) |
▸Shell 执行命令
Shell fork 出子进程 → 子进程 exec("ls") 加载可执行文件 → 父 Shell wait 等待结束 → 打印提示符。若父进程先退出且未处理,子进程可由 init(PID 1)收养。
调度
目标
吞吐、周转时间、等待时间、响应时间、公平性;交互式偏响应,批处理偏吞吐。
调度算法
FCFS
先来先服务,非抢占。实现简单;长作业会阻塞短作业(护航效应)。
▸FCFS
到达顺序 P1(24)、P2(3)、P3(3)。平均等待 = (0+24+27)/3 = 17。若短作业先到,等待会明显下降。
SJF / SRTF
短作业优先;SRTF 为抢占版(剩余时间最短)。平均等待优,但需预估运行时间,长作业可能饥饿。
▸SJF
同上三作业若按 3、3、24 执行:等待分别为 0、3、6,平均 = 3。显著优于 FCFS。
优先级调度
高优先级先运行;可静态或动态。低优先级可能饥饿,可用老化(等待越久优先级越高)缓解。
时间片轮转 RR
就绪队列轮流各跑一个时间片 q。q 过小切换开销大,过大近似 FCFS。交互系统常用。
▸RR(q=4)
P1(24)、P2(3)、P3(3)。执行序:P1(4)→P2(3)→P3(3)→P1(4)… P2、P3 很快完成,交互响应好;P1 分段完成。
多级反馈队列 MLFQ
- 新进程进高优先级队列,时间片短
- 用尽时间片未完成则降级,低队列时间片更长
- 高优先级可抢占低优先级
- 效果:短交互快响应,长 CPU 密集任务在低队列获吞吐
▸现实系统
Linux CFS 用红黑树按虚拟运行时间选“最亏欠”的任务,追求公平;实时任务另有 FIFO/RR 策略。考试常考经典算法,实现细节因内核而异。
同步
竞态
多线程并发读写共享变量,执行交错导致结果不确定,称为竞态条件。
▸count++ 丢失更新
初值 count=5。线程 A、B 均执行 count++(读→加→写)。若交错为:A 读 5,B 读 5,A 写 6,B 写 6,则最终为 6 而非 7。临界区需互斥保护。
临界区原则
- 互斥:同时至多一个进程在临界区
- 前进:无人在临界区时,想进入者不应无限等待
- 有限等待:从请求进入到获准,等待次数有上界
锁
- 自旋锁:忙等循环;适合临界区极短、多核不愿睡眠
- 互斥锁(Mutex):获取失败则睡眠,让出 CPU;适合较长临界区
- 读写锁:多读者并发,写者独占;读多写少场景高效
信号量
整型 S,原子操作:
- P(wait):S>0 则 S–,否则阻塞
- V(signal):若有等待者则唤醒,否则 S++
二元信号量可当锁;计数信号量可表示 N 个同类资源。
▸停车场
车位 10 个,初始 S=10。车辆入场 P,出场 V。S=0 时再来车阻塞,直到有车离开 V 唤醒。
条件变量
与互斥锁配合:线程在持锁下发现条件不满足则 wait(原子释放锁并睡眠);条件成立时 signal/broadcast 唤醒。用于“等事件”而非仅互斥。
管程
将共享数据与操作封装,语言/运行时保证同一时刻仅一个线程执行管程内过程。Java synchronized、部分语言的 monitor 即此类思想。
经典问题
生产者-消费者
有界缓冲区。空则消费者等,满则生产者等;常用两个信号量(empty/full)+ 互斥锁。
读者-写者
读者共享、写者互斥;需防止写者饥饿或读者饥饿(策略不同)。
哲学家就餐
五人五筷,各需左右两筷。全员先拿左筷会死锁。
▸哲学家破死锁
- 限制同时就餐人数 ≤ 4;或
- 奇偶哲学家拿筷顺序相反;或
- 按筷子全局编号,始终先低号后高号(破坏循环等待)。
| 相关系统调用 | 作用 |
|---|---|
pipe |
半双工字节流管道,父子/兄弟进程通信 |
shmget / shmat |
创建/挂载共享内存段 |
semget / semop |
信号量集,P/V 同步 |
msgget / msgsnd / msgrcv |
System V 消息队列 |
死锁
四个必要条件
须同时满足才可能死锁:
- 互斥:资源不可共享
- 占有且等待:持有资源同时等待其他资源
- 不可抢占:不能强行夺走已分配资源
- 循环等待:存在进程等待环
处理策略
预防
破坏四条件之一:一次性申请全部资源、允许抢占、按序申请等。
避免
分配前检查安全性,典型为银行家算法。
检测与恢复
允许死锁发生,定期检测等待图环,撤销或抢占解除。
鸵鸟策略
忽略(概率极低且代价可接受时;部分场景实际采用)。
银行家算法
把 OS 当银行家:仅当分配后系统仍处于安全状态(存在一个让所有进程都能完成的序列)才批准。
▸安全序列
总量 Available = (3, 3, 2)。三进程剩余需求:
- P0 Need=(7,4,3) 目前不可满足
- P1 Need=(1,2,2) 可满足 → 分配后 P1 完成后释放,Available 增大
- 再满足 P2、P0
若存在序列如 ⟨P1, P2, P0⟩ 使全部完成,则当前为安全态,可按该思路审批新请求;否则拒绝,令进程等待。
内存管理
为何虚拟内存
直接用物理地址:多程序易冲突,且程序依赖固定加载地址。虚拟内存让每进程以为独占从 0 开始的连续空间,由 MMU + 页表映射到物理页框。
连续分配与碎片
早期内存管理常把进程装入一段连续物理内存。问题是进程大小不一、创建和结束顺序不确定,空闲区会被切成很多大小不同的洞(hole),于是需要动态分配策略。
动态分配策略
设空闲块依地址顺序为:100KB, 50KB, 200KB, 30KB,新进程需要 60KB。
| 策略 | 规则 | 本例选择 | 优点 | 问题 |
|---|---|---|---|---|
| First Fit | 从低地址开始,找到第一个够大的块 | 100KB,剩 40KB | 查找快 | 低地址处易留下碎片 |
| Best Fit | 遍历所有块,选能放下且剩余最小者 | 100KB,剩 40KB | 单次浪费看似最小 | 容易制造大量 tiny 碎片 |
| Worst Fit | 选最大的块 | 200KB,剩 140KB | 剩余块仍较大 | 大块被不断切碎,实际效果常差 |
▸换一个例子看差异
空闲块:70KB, 90KB, 200KB, 80KB,请求 75KB。
- First Fit:跳过 70KB,选 90KB,剩 15KB。
- Best Fit:能放的有 90/200/80KB,选 80KB,剩 5KB。
- Worst Fit:选 200KB,剩 125KB。
Best Fit 剩得最少,但 5KB 很可能以后用不上;Worst Fit 保留 125KB 大块,但持续使用会消耗大空闲区。
外部碎片
外部碎片:空闲空间总量足够,但分散在已分配块之间,无法形成所需的连续大块。
▸总空闲够,但放不下
空闲块为 6KB, 6KB, 21KB, 7KB,总空闲 40KB。若新进程需要连续 25KB,则分配失败,因为最大连续空闲块只有 21KB。
这类碎片在已分配块之外,所以称为外部碎片。
常见缓解方式:
- 紧凑(Compaction):移动进程,把小洞合成大洞;代价高,且要求可重定位
- 分页:不再要求进程物理上连续,直接消除外部碎片
- 分段:按逻辑段分配,仍可能有外部碎片
固定分区与内部碎片
固定分区把内存预先切成固定大小块,分配单位固定。例如块大小为 4KB,进程需要 3KB,仍占一整块,剩余 1KB 已被分配给该进程,其他进程不能用。
这就是内部碎片:浪费发生在已分配块内部。
| 外部碎片 | 内部碎片 | |
|---|---|---|
| 位置 | 已分配块之外,空闲但分散 | 已分配块之内,分配了但未用 |
| 典型原因 | 动态连续分配、分段 | 固定分区、分页 |
| 危害 | 总空闲够但无连续大块 | 实际可用内存减少 |
| 缓解 | 紧凑、分页 | 减小分配单位,但页表开销增加 |
分页中的内部碎片
分页把虚拟地址空间和物理内存都切成固定大小页/页框。它不要求进程在物理内存中连续,因此没有外部碎片;但最后一页通常填不满,因此仍有内部碎片。
▸分页内部碎片
页大小 4KB,进程大小 10.5KB。
- 需要页数:$\lceil 10.5/4 \rceil = 3$ 页
- 实际分配:
12KB - 内部碎片:
12KB - 10.5KB = 1.5KB
若进程大小在页内均匀分布,平均每个进程最后一页浪费约半页。
▸记忆
外部碎片:仓库里还有很多空位,但都被切成小隔间,大箱子放不进。内部碎片:已经给了一个大箱子,箱内没装满,剩余空间被锁在箱里。
分页
- 虚拟地址 = 页号 + 页内偏移
- 页表:页号 → 页框号(及存在位、读写权限、脏位等)
- 物理地址 = 页框号 + 页内偏移
- 页大小常见 4KB;大页可减少页表项、降低 TLB 压力
TLB:页表缓存;命中则快速翻译,缺失则查页表并填入。
多级页表:稀疏地址空间下节省页表内存(如 x86-64 四级)。
有效访问时间 EAT
记内存访问时间 $t$,TLB 访问 $t_{\mathrm{TLB}}$,命中率 $h$。
单级页表 + TLB(缺失时:查页表 1 次 + 取数 1 次):
$$ EAT = h(t_{\mathrm{TLB}}+t) + (1-h)(t_{\mathrm{TLB}}+2t) = t_{\mathrm{TLB}} + (2-h)t $$
二级页表 + TLB(缺失时:外层 + 内层 + 取数,共 3 次访存):
$$ EAT = t_{\mathrm{TLB}} + (3-2h)t $$
含缺页(缺页率 $p$,缺页处理 $t_{\mathrm{pf}}$,通常 $\gg t$):
$$ EAT_{\mathrm{total}} = (1-p)\,EAT + p\,t_{\mathrm{pf}} $$
▸TLB + 二级页表 EAT
$t=200\,\mathrm{ns}$,$t_{\mathrm{TLB}}=20\,\mathrm{ns}$,$h=96\%$。
$$ EAT = 20 + (3 - 2 \times 0.96) \times 200 = 20 + 1.08 \times 200 = 236\,\mathrm{ns} $$
若 $h$ 降到 90%:$EAT = 20 + 1.2 \times 200 = 260\,\mathrm{ns}$。TLB 命中率对 EAT 影响显著。
▸TLB + 缺页(408 综合)
接上一题 $EAT=236\,\mathrm{ns}$。设缺页率 $p=0.5\%$,一次缺页 $t_{\mathrm{pf}}=8\,\mathrm{ms}=8\times 10^{6}\,\mathrm{ns}$。
$$ EAT_{\mathrm{total}} = 0.995 \times 236 + 0.005 \times 8{,}000{,}000 = 234.82 + 40{,}000 \approx 40{,}235\,\mathrm{ns} $$
缺页虽仅 0.5%,仍使平均访问时间上升约 170 倍——说明降低缺页率比微调 TLB 更关键。
▸多级页表占用空间
32 位虚拟地址,4 KB 页(12 位偏移),二级页表:页目录 10 位 + 页表 10 位。页表项 4 B。
某进程映射 1030 个页面,分布在两个连续的 1024 页区域内(需 2 张页表页)。
- 页目录:恒 1 页 = 4 KB(1024 项,仅用 2 项指向内层)
- 内层页表:2 页 = 8 KB
- 合计 12 KB
对比单级:$2^{20}$ 项 × 4 B = 4 MB 页表。多级用“按需分配内层”节省大量内核内存。
(2) 地址翻译:虚拟地址 0x1234_5678(32 位,4 KB 页)
- 页目录号 = 位 [31:22] =
0x12345678 >> 22= 0x48 = 72 - 页表号 = 位 [21:12] =
(0x12345678 >> 12) & 0x3FF= 0x345 = 837 - 页内偏移 = 位 [11:0] = 0x678
先查页目录第 72 项 → 得页表基址 → 查页表第 837 项 → 得页框号 → 拼接偏移 0x678 得物理地址。
缺页
访问不在内存的页 → 缺页异常:
- 内核确认合法映射(否则 SIGSEGV)
- 选一页框(可能需换出)
- 从磁盘/交换区读入
- 更新页表存在位
- 重新执行导致缺页的指令
页面置换
内存满时选牺牲页换出。
FIFO
最早进入的先换出。可能出现 Belady 异常:页框增多,缺页反而增多。
▸FIFO 与 Belady
访问序列:1,2,3,4,1,2,5,1,2,3,4,5。
- 3 个页框:缺页 9 次
- 4 个页框:缺页 10 次
页框变多,缺页次数上升,即 Belady 异常。LRU 等栈算法无此现象。
LRU
换出最久未访问的页,局部性好,接近最优;精确实现需硬件时间戳或栈,开销大。
▸LRU
页框 3,序列 7,0,1,2,0,3,0。
- 装入 7,0,1
- 2 替换最久未用的 7 → [0,1,2]
- 0 命中
- 3 替换最久未用的 1 → [0,2,3]
- 0 命中
时钟算法
页框排成环,每页一个引用位。指针扫到引用位 1 则清 0 并跳过(二次机会);扫到 0 则换出。近似 LRU,实现廉价。
工作集与抖动
工作集:进程在最近 Δ 时间内访问的页集合。物理页不足以容纳工作集 → 频繁缺页 抖动(Thrashing)。对策:降低多道程度、工作集/缺页频率调节、换出整个进程等。
分段与段页
- 分段:按逻辑(代码/数据/栈)划分,段长可变,便于保护与共享,易外部碎片
- 分页:定长,无外部碎片,有内部碎片
- 段页式:地址 = 段号 + 页号 + 偏移;先查段表再查页表,兼具逻辑清晰与碎片可控
| 相关系统调用 | 作用 |
|---|---|
brk |
调整堆顶,扩展/收缩数据段 |
mmap |
把文件或匿名内存映射进虚拟地址空间 |
munmap |
解除映射,释放对应虚拟页 |
文件系统
文件系统是在裸块设备上组织数据的规则。实现上分两层:磁盘存真相(断电不丢),内存做缓存(加速访问);VFS 再为 ext4/NTFS/XFS 等套上统一接口。
前置步骤(分区、格式化、分卷)见 硬件基础 → 分区与格式化。数据流转:用户程序 → 系统调用 → VFS → 具体 FS → 页缓存 → 块层 → 驱动 → 磁盘。
实现结构
设计思想
| 磁盘(On-Disk) | 内存(In-Memory) | |
|---|---|---|
| 持久性 | 断电保留 | 断电消失 |
| 速度 | 慢(ms 级) | 快(ns 级) |
| 角色 | 真相来源 | 缓存与运行时状态 |
| 典型结构 | 超级块、inode 表、数据块、位图 | dentry/inode/页缓存、打开文件表、挂载表 |
修改先在内存完成,再批量写回磁盘(延迟写),以减少慢速 I/O。
磁盘上的结构
引导块
分区最前若干扇区,存放引导代码;BIOS/UEFI 开机后读取,跳转到 OS 加载程序。
超级块
整个 FS 的全局元数据,挂载时首先读取:
- FS 类型(ext4 等)、魔数(识别 FS)
- 总块数、空闲块数、块大小
- 总 inode 数、空闲 inode 数
- 挂载/写入时间、错误状态(clean / 需 fsck)
超级块损坏会导致分区无法识别;ext 等 FS 常在多个块组保留副本。
inode
每个文件/目录对应一个 inode,存元数据(不含文件名;文件名在目录项中):
- 类型(普通文件/目录/符号链接等)、权限、uid/gid
- 大小、atime/mtime/ctime、硬链接计数
- 数据块指针(ext2 经典布局)或 extent(ext4)
ext2 块指针布局(块 4KB、指针 4B 时):
- 12 个直接块:小文件(≤48KB)一次 inode 读 + 一次数据块读
- 一级间接:间接块存 1024 个块号 → 约 +4MB
- 二级 / 三级间接:逐级套娃,支持更大文件
目录的 inode 指向的数据块内容是 “文件名 → inode 号” 列表(含 . / ..),目录本质是特殊文件。
数据块
存放文件实际内容;目录块存放目录项表。
空闲空间管理
- 位图(Bitmap):每位对应一块,0=空闲、1=已用;分配/释放即 flip 位
- 空闲链表:空闲块内存下一空闲块号,链式串联
- 现代 FS(XFS/Btrfs)亦可用 B+ 树管理空闲空间
内存中的结构
挂载表
记录块设备与挂载点对应关系,如 /dev/sda1 → /、/dev/sdb1 → /mnt/usb。路径解析时先确定请求落在哪个 FS。
dentry 缓存
缓存路径分量解析结果(如 /home/user → inode)。命中则跳过读盘上的目录块;VFS 的 dentry 对象即此缓存的载体。
inode 缓存
缓存最近使用的 inode 元数据(大小、权限、块指针/extent)。命中则不必读磁盘 inode 表。
页缓存
文件内容在内存中的副本(Linux 2.4 后与缓冲区缓存统一)。读优先查页缓存;写先改页缓存并标脏页(dirty),异步刷回磁盘。干净页与磁盘一致;脏页待 writeback。
打开文件表与 fd
1 | 进程 fd 表 struct file(系统级打开文件表项) |
- 每次 open 创建 struct file,分配进程 fd
- 不同进程 open 同一文件 → 通常各自 file,f_pos 独立
- dup/dup2 → 多 fd 共享同一 file,f_pos 也共享
- 多进程同时 O_WRONLY 写可能互相覆盖 → fcntl/flock 文件锁
▸路径解析 /a/b/c.txt
查挂载表 → dentry 缓存找 a→b→c.txt → 得 inode → 按块指针/extent 读数据块(先查页缓存)。
读写的完整流程
读文件
以 cat /home/user/file.txt 为例:
- 挂载表:确定
/home/user/所在分区(如/dev/sda2) - dentry 缓存:解析路径得
file.txt的 inode 号;未命中则读磁盘目录块并填入缓存 - inode 缓存:取 inode 得数据块号/extent;未命中则读磁盘 inode 区
- 页缓存:按块号取内容;未命中则块层读盘填入页缓存
- 拷贝到用户缓冲,经 VFS 返回
写文件
以 echo "new" >> file.txt 为例:
- 解析路径得 inode(同上,走缓存或读盘)
- 分配数据块:查位图/空闲结构找空闲块,标记已用
- 写页缓存:数据写入对应页,标脏
- 更新 inode(内存中):追加块指针、增大文件大小、更新 mtime,inode 亦可能标脏
- 异步刷盘:flusher 定期或
sync/fsync时将脏页与脏 inode 写回磁盘
VFS
作用
抽象层:应用只调用统一的 open/read/write/close,不必关心底层是 ext4 还是 XFS。
四类核心对象
| 对象 | 对应实现结构 | 职责 |
|---|---|---|
| superblock | 挂载的 FS 实例 | 全局信息、s_op 操作表 |
| inode | 文件/目录元数据 | 权限、大小、块映射;i_mapping → 页缓存 |
| file | 打开文件表项 | f_pos、打开模式、引用计数 |
| dentry | dentry 缓存节点 | 路径分量 → inode,加速 lookup |
调用链
read(fd, buf, n):fd → file → f_inode → FS 专用 read → 页缓存 / 块 I/O → 拷贝到 buf,f_pos += n。
常见文件系统
| FS | 特点 | 典型场景 |
|---|---|---|
| FAT32 | 簇链(FAT 表)管理空间;无 Unix 权限/日志;单文件 ≤4GB | U 盘、SD 卡(兼容性强) |
| NTFS | MFT 存元数据;日志、ACL、压缩/加密、硬/软链接 | Windows 默认 |
| ext2 | 块组 + inode 表;无日志,崩溃后 fsck 慢 | 已较少使用 |
| ext3 | ext2 + 日志;Journal / Ordered / Writeback 三模式 | 旧 Linux |
| ext4 | extent 代替逐块映射;延迟分配、多块分配、在线 defrag;Linux 默认 | 现代 Linux |
| XFS | 分配组并行、B+ 树管空闲空间与 inode;大文件/高并发 | 数据库、大文件服务器 |
| Btrfs / ZFS | COW、快照、校验和、池化存储 | 实验/企业级数据完整性 |
FAT 与 ext 的差异
- FAT:最小分配单位是簇(常 4KB),小文件也占整簇 → 内部碎片;FAT 表记录簇链
- ext:inode 存元数据,数据块指针/extent 存内容;目录是特殊文件
日志
写前先记日志(事务步骤),崩溃后 redo/undo,避免长时间 fsck。ext3/4、NTFS、XFS 均支持;FAT 无日志。
文件操作
open
- 路径解析(dentry 缓存)→ 权限检查 → 创建 struct file(
f_pos=0)→ 分配 fd(0/1/2 为 stdin/stdout/stderr,新 fd 通常从 3 起) - 常见标志:
O_RDONLY/O_WRONLY/O_RDWR;O_CREAT创建;O_TRUNC截断;O_APPEND追加(内核保证 seek 到末尾 + write 原子);O_EXCL与O_CREAT联用防覆盖;O_SYNC同步写
read
- 查 file → inode → FS read → 页缓存命中则直接拷贝到用户 buf
- 未命中:块层读盘 → 填入页缓存 → 拷贝到 buf →
f_pos += n - 预读(read-ahead):顺序读时内核异步预读后续块
write
- 改页缓存 → 标脏页 → 更新 inode 大小/时间(内存)
- 默认延迟写:
write返回仅表示数据进页缓存;flusher 异步刷盘 O_SYNC/ fsync / fdatasync:强制落盘(fsync 含元数据,fdatasync 仅数据)
▸延迟写与一致性
write 成功 ≠ 数据已在磁盘。断电可能丢未刷脏页。数据库等场景须在关键步骤后 fsync;FS 日志保证元数据/事务一致性。
close
- 释放 fd;
file引用计数减 1;若为 0 则刷脏页、释放页缓存关联、释放 file
lseek
- 只修改内存中 f_pos,不访问磁盘
SEEK_SET/SEEK_CUR/SEEK_END- 可产生稀疏文件:
lseek到很远再写 1 字节 → 逻辑大小很大,中间空洞(ext4/XFS 不实际分配数据块)
元数据
- stat:读 inode 信息(大小、权限、时间、硬链接数、块占用等)
- chmod / chown:改权限与所有者(如
0644= rw-r–r–) - link(硬链接):同 inode 多名字,不可跨 FS,删一留一仍有效
- symlink(软链接):存路径字符串,可跨 FS,原文件删则悬空
目录
- opendir / readdir(或
getdents)逐条读目录项 - mkdir / rmdir:创建目录 / 删除空目录
mmap
| read/write | mmap | |
|---|---|---|
| 数据路径 | 用户 buf ↔ 页缓存 ↔ 磁盘 | 用户虚拟地址直接映射页缓存 |
| 拷贝 | 需一次内核到用户拷贝 | 少一次拷贝 |
| 随机访问 | lseek + read | 直接 addr[offset] |
| 共享 | 需额外机制 | MAP_SHARED 多进程共享映射 |
并发与 dup
- fcntl 建议锁:
F_RDLCK共享读锁;F_WRLCK独占写锁;须进程自觉配合(Linux 默认非强制锁) - dup / dup2:复制 fd;
dup2(fd, 1)可重定向 stdout
其他
- O_APPEND 写是原子的;手动
lseek(SEEK_END)+write非原子,多进程可能覆盖 - sendfile:文件 → socket 零拷贝,跳过用户态缓冲
- 崩溃一致性:日志 FS 先写日志再提交数据/元数据更新,未完成则 redo/undo
▸操作本质
文件 I/O 核心是位置管理:open 建立 file 与 inode 关联,read/write 在 f_pos 处读写,lseek 改位置,close 释放。磁盘结构存真相,内存缓存加速,延迟写提吞吐,日志/fsync 保耐久。
| 相关系统调用 | 作用 |
|---|---|
open / close |
打开/关闭文件,分配/释放 fd |
read / write |
按 fd 读写(VFS → 页缓存) |
lseek |
移动 f_pos |
fsync / fdatasync |
强制刷盘 |
stat / fchmod / fchown |
元数据 |
link / symlink / unlink |
硬/软链接与删除 |
mkdir / rmdir / chdir / getdents |
目录操作 |
mmap / munmap |
文件映射(亦属内存管理) |
dup / dup2 / fcntl |
fd 复制与文件锁 |
sendfile |
零拷贝发送文件 |
I/O 与设备
I/O 子系统负责在 CPU/内存(快) 与 外设(慢) 之间搬运数据。磁盘比内存慢几个数量级,因此 OS 用缓冲、缓存、调度、DMA 等手段尽量让 CPU 少等 I/O。
层次结构
自顶向下,一次读盘请求大致经过:
1 | 用户程序 read() |
- 设备无关层:统一接口,屏蔽磁盘/SSD/打印机差异;含缓冲、错误处理、调度
- 设备驱动层:厂商编写,管理寄存器、中断、DMA 描述符
- 硬件层:实际执行寻道、旋转、传输
▸与文件系统的关系
读文件时路径为:系统调用 → VFS → 具体 FS → 页缓存 → 块层 → 驱动 → 磁盘。读裸设备(如 /dev/sda)跳过 FS,但仍经块层与驱动。二者在 I/O 下半段汇合。
控制方式
CPU 与外设速度不匹配,如何发起并等待 I/O 是核心问题。
| 方式 | 工作过程 | 优点 | 缺点 | 典型场景 |
|---|---|---|---|---|
| 程序控制 I/O | CPU 发命令后轮询状态寄存器,直到设备就绪 | 实现简单 | CPU 100% 忙等,浪费算力 | 早期嵌入式、极简单设备 |
| 中断驱动 I/O | CPU 发命令后转做别的事;设备就绪时发中断,CPU 进 ISR 处理 | CPU 利用率高于轮询 | 每字节/小块一次中断,上下文切换开销大 | 键盘、低速串口 |
| DMA | CPU 设好内存地址与长度,DMA 控制器直接搬数据;完成后中断一次 | 适合大批量,CPU 介入少 | 需连续物理内存、描述符管理 | 磁盘读写、网卡收包 |
| 通道 I/O | 专用 I/O 处理器(通道) 执行通道程序,独立完成一串 I/O | CPU 几乎不参与传输过程 | 硬件成本高 | 大型机 |
▸与进程调度的联系
中断驱动下,进程发起 I/O 后通常阻塞(状态 Running→Blocked),调度器切换其他进程——这正是多道批处理提高 CPU 利用率的基础。I/O 完成中断到来时,进程 Blocked→Ready,重新参与调度。
缓冲与 Spooling
- 单缓冲:用户 → 内核缓冲 → 设备;简单但设备与 CPU 仍可能互相等
- 双缓冲:一块供 CPU 写、一块供设备读,流水线化
- Spooling(假脱机):把慢速设备(打印机)的 I/O 先写入磁盘队列,后台慢慢打印;用户感觉“立刻打完”
设备分类
| 类型 | 访问方式 | 是否可缓存 | 例子 | 内核抽象 |
|---|---|---|---|---|
| 块设备 | 按固定大小块(512B/4KB)随机读写 | 是(页缓存、块缓冲) | HDD、SSD、U 盘 | /dev/sda,支持 mmap |
| 字符设备 | 按字节流顺序读写 | 通常不缓存 | 键盘、鼠标、串口 | /dev/tty,不可随机 seek |
| 网络设备 | 数据报/流 | 协议栈缓冲 | 网卡 | socket 接口,非传统 /dev |
块设备与字符设备在 Linux 中通过主/次设备号区分;驱动注册后用户态经 VFS 或 socket 访问。
设备驱动
驱动是 OS 与硬件之间的翻译层,职责包括:
- 初始化:探测硬件、分配 IRQ、映射 MMIO 寄存器
- 命令翻译:把
read/write/ioctl转为具体寄存器操作或 DMA 提交 - 中断处理:传输完成、错误时唤醒阻塞进程、更新缓冲
- 电源/热插拔:现代驱动还需处理休眠、设备移除
用户程序不直接读写硬件端口;统一经系统调用 → VFS/块层 → 驱动。
| 相关系统调用 | 作用 |
|---|---|
read / write |
读写块/字符设备(与文件共用接口) |
ioctl |
设备特有控制(如网卡配置、终端模式) |
mmap |
把设备内存或帧缓冲映射进用户空间 |
socket / bind / connect |
网络 I/O,创建与操作套接字 |
磁盘调度
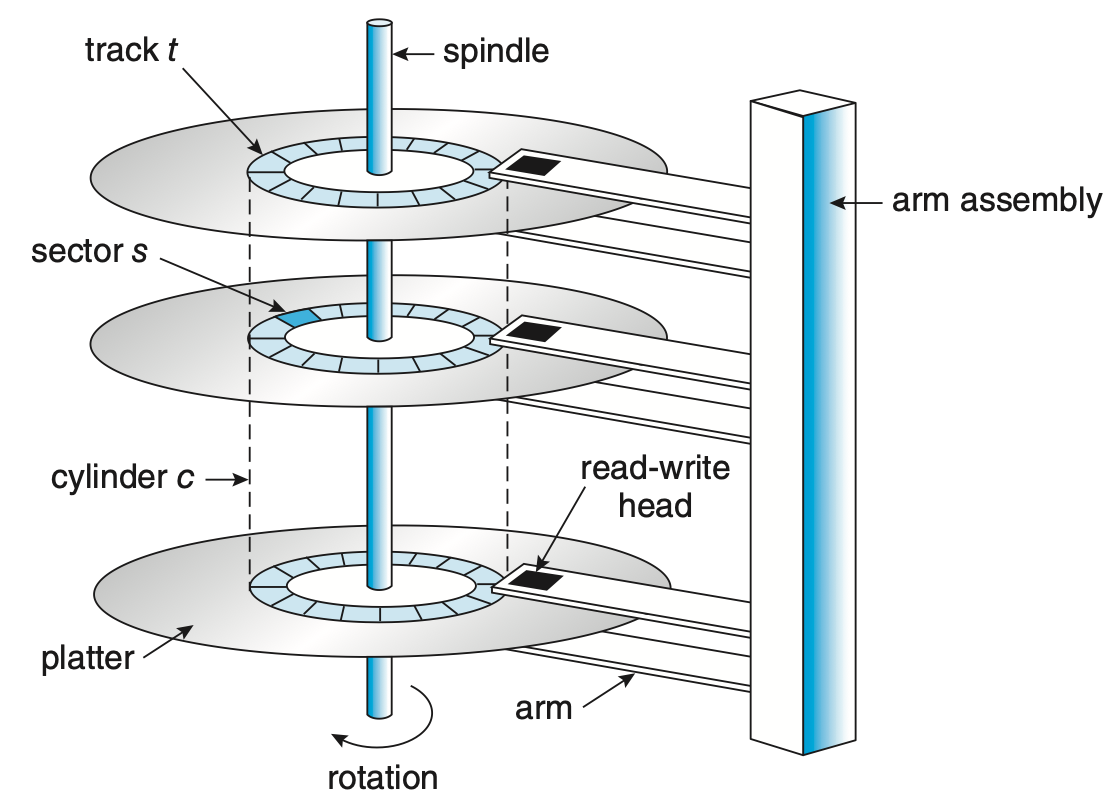
目标:减少磁头移动(寻道距离),降低定位时间在总 I/O 时间中的占比。CHS、单次访问时间公式与例题亦见 硬件基础 → 磁盘与 SSD;多盘冗余见 RAID;分区与格式化见 分区与格式化。
硬盘结构
硬盘(HDD)是常见二级存储,几何结构自小到大:
- 扇区(Sector):磁道上最小读写单位(常见 512 B / 4 KB)
- 磁道(Track):单盘片上一圈同心圆
- 柱面(Cylinder):各盘片同一半径上的磁道集合
- 磁臂(Arm):带动所有读写磁头整体径向移动;同一时刻仅一个磁头激活
容量(与硬件基础章 CHS 公式一致):
$$ \text{容量} = \text{柱面数} \times \text{盘面数} \times \text{每磁道扇区数} \times \text{扇区大小} $$
读写过程
一次磁盘读写的机械步骤:
- 寻道:磁臂移到目标柱面
- 选头:激活对应盘面的磁头(目标磁道已在柱面上)
- 旋转等待:盘片旋转,目标扇区转到磁头下
- 传输:磁头读写扇区数据到内存(常经 DMA)
I/O 时间构成
单次 I/O 平均耗时:
$$ T_{\mathrm{IO}} = \underbrace{T_{\mathrm{seek}} + T_{\mathrm{rotate}}}_{T_{\mathrm{access}}\ \text{(定位时间)}} + T_{\mathrm{transfer}} + T_{\mathrm{controller}} $$
| 分量 | 含义 | 典型量级 |
|---|---|---|
| 寻道时间 $T_{\mathrm{seek}}$ | 磁头移到目标柱面 | ms 级,最大头 |
| 旋转延迟 $T_{\mathrm{rotate}}$ | 等扇区转到磁头下;平均半圈 | ms 级 |
| 传输时间 $T_{\mathrm{transfer}}$ | 数据在磁盘与内存间传输 | $\dfrac{\text{数据量(bit)}}{\text{传输速率(b/s)}}$ |
| 控制器开销 $T_{\mathrm{controller}}$ | 控制器处理命令 | 通常很小 |
平均旋转延迟(转速 $r$ rpm):
$$ T_{\mathrm{rotate,avg}} = \frac{1}{2} \times \frac{60}{r}\ \mathrm{s} = \frac{30}{r}\ \mathrm{s} $$
▸读 4 KB 慢在哪
7200 rpm 硬盘,平均寻道 5 ms,传输速率 1 Gb/s,控制器开销 0.1 ms,读 4 KB。
$$ T_{\mathrm{rotate,avg}} = \frac{30}{7200} \times 10^{3} \approx 4.17\,\mathrm{ms} $$
$$ T_{\mathrm{transfer}} = \frac{4 \times 1000 \times 8}{1 \times 10^{9}} \times 10^{3} \approx 0.032\,\mathrm{ms} $$
$$ T_{\mathrm{IO}} = 5 + 4.17 + 0.032 + 0.1 = \mathbf{9.302\,\mathrm{ms}} $$
定位时间(寻道 + 旋转)≈ 9.17 ms,占 99% 以上;传输仅 0.032 ms。瓶颈在机械定位,不在带宽。
▸结论与调度动机
- 定位时间是 I/O 开销大头;目标柱面离磁头越远,寻道越久。
- 顺序访问同一柱面/相邻柱面可合并寻道,显著降平均 I/O 时间。
- OS 在块层对未完成的读写在柱面号队列上重排序 → 磁盘调度算法。
调度算法
FCFS
按请求到达顺序服务。公平、实现简单;磁头可能频繁来回,平均寻道大。
SSTF
(Shortest Seek Time First)每次选离当前磁头最近的柱面。平均寻道小;远端请求可能饥饿。
SCAN
(电梯算法)沿当前方向移动,服务路径上所有请求,到物理端点后反向。比 FCFS 优,较公平;刚被扫过的区域需等下一轮。
C-SCAN
(循环 SCAN)只沿一个方向服务,到端点后快速回到起点再扫。等待时间比 SCAN 更均匀;回程不服务请求(408 计距常不计回程)。
LOOK
与 SCAN 类似,但折返于当前队列中最远请求,不必到物理端点 0/199。
C-LOOK
与 C-SCAN 类似,单向服务后快速回到队列最小请求处再扫;折返距离通常不计入寻道距离。
▸408 计距约定
- SCAN:先沿当前方向服务,到最大/最小柱面再折返。
- LOOK:折返于最后一个请求,不到物理端点。
- C-SCAN / C-LOOK:单向服务后快速回程;回程柱面数通常不计入寻道距离(以题面为准)。
例题
▸多算法寻道距离对比(408 经典)
柱面 0–199,当前磁头 53,刚完成向大号方向的移动,请求队列:98, 183, 37, 122, 14, 124, 65, 67(8 个)。
| 算法 | 服务顺序 | 寻道距离 |
|---|---|---|
| FCFS | 98→183→37→122→14→124→65→67 | 45+85+146+85+108+110+59+2 = 640 |
| SSTF | 65→67→37→14→98→122→124→183 | 12+2+30+23+84+24+2+59 = 236 |
| SCAN↑ | 65→67→98→122→124→183→199→37→14 | 130+16+162+23 = 331 |
| LOOK↑ | 65→67→98→122→124→183→37→14 | 130+146+23 = 299 |
| C-SCAN↑ | 65→67→98→122→124→183→199,回 0→14→37 | 130+16+(回程不计)+14+23 = 183 |
| C-LOOK↑ | 65→67→98→122→124→183,回 14→37 | 130+(回程不计)+23 = 153 |
SSTF 验算:53→65(12)→67(2)→37(30)→14(23)→98(84)→122(24)→124(2)→183(59)。
SCAN 验算:向上 53→183 共 130;183→199(16);折返 199→37(162);37→14(23)。
C-LOOK 验算:向上同 LOOK 的 130;从 183 快速回到 14,再 14→37(23)。SSTF 寻道最短但可能饥饿;SCAN/LOOK 更公平。
▸调度 + 访问时间(综合)
接“磁盘与 SSD”例题参数:$T_{\mathrm{seek,avg}}=8\,\mathrm{ms}$,7200 rpm,600 扇区/磁道。磁头在柱面 53,SSTF 依次服务 65、67、37(每个柱面各读 1 扇区)。
- 寻道:$|65-53|+|67-65|+|37-67| = 12+2+30 = 44$ 柱面。若 1 柱面寻道 = 0.1 ms,则 $T_{\mathrm{seek,sum}}=4.4\,\mathrm{ms}$。
- 每次读 1 扇区:旋转平均 4.17 ms + 传输 0.014 ms ≈ 4.18 ms;3 次 ≈ 12.54 ms。
- 总时间 ≈ $4.4 + 12.54 \approx 16.9\,\mathrm{ms}$。
若 FCFS 顺序 65→37→67:寻道 $12+30+30=72$ 柱面 → 7.2 ms,总时间更长。
SSD:无机械寻道,随机读快;调度重心转向请求合并、NVMe 多队列与 wear leveling。
总结
全文脉络回顾
| 模块 | 核心知识点(自检清单) |
|---|---|
| 设计总览 | 单道/多道/分时;宏内核/微内核/混合;公平·高效·稳定·权限 |
| 硬件 | CPI 三要素;地址空间布局;磁盘访问时间;RAID 0/1/5/6/10;分区 MBR/GPT;格式化;分卷/LVM |
| 中断与系统调用 | 中断 vs 异常;处理流程;系统调用陷入路径 |
| 进程与调度 | PCB、状态转换、进程 vs 线程、fork/exec/wait;FCFS/SJF/RR/MLFQ |
| 同步与死锁 | 竞态、锁/信号量/管程、经典问题;四条件、银行家、预防/避免/检测 |
| 内存 | FF/BF/WF;内/外碎片;分页、TLB、EAT、缺页、FIFO/LRU/Clock、工作集;分段/段页 |
| 文件系统 | 磁盘/内存结构、VFS 四对象、FAT/NTFS/ext/XFS、open/read/write/mmap/fsync |
| I/O | 程序控制/中断/DMA/通道;设备分类与驱动;磁盘调度 FCFS–C-LOOK |
知识串联
以在 Shell 输入 cat hello.txt 为例,贯穿前文各章知识点。
1. 开机与初始化
固件(BIOS/UEFI)→ 读 MBR/GPT 分区表与引导块 → 加载内核到内存 → 内核初始化:
- 内核结构:Linux 等多为宏内核/混合内核,驱动与 FS 可在内核态直接调用
- 进程管理:创建
init(PID 1),就绪队列与调度器就绪 - 内存管理:建立内核页表,初始化物理页分配器、TLB(分页消除外部碎片,仍有内部碎片)
- 存储准备:根分区已格式化(如 ext4),可有 RAID 阵列作为底层块设备
- 文件系统:挂载 rootfs,初始化 VFS、dentry/inode 缓存、页缓存
- I/O 与设备:注册块/字符驱动,配置 DMA、中断向量表
- 中断:时钟中断启动,驱动时间片调度(分时系统基础)
2. 登录 Shell
init按运行级别 fork 子进程,exec 启动 getty/Shell- Shell 成为普通用户态进程,拥有独立虚拟地址空间(代码/数据/堆/栈)
- 终端键盘输入经字符设备驱动,中断驱动 I/O 把按键放入缓冲
3. 解析并启动 cat
用户敲回车 → Shell read 终端(系统调用 → 字符驱动 → 中断)→ 内部分析命令:
- Shell 再 fork:子进程复制 PCB 与地址空间(COW 延迟复制物理页)
- 子进程 execve(“cat”):替换为 cat 的代码段,加载 ELF,内核分配页表项
- 父 Shell wait 阻塞,等子进程结束(进程状态:Running→Blocked→Ready)
4. CPU 调度与并发
- 就绪队列中 Shell、cat 等按 时间片轮转 或 CFS 共享 CPU(分时系统;多道思想的扩展)
- 时钟中断周期性触发:时间片到 → 保存 cat 的 PC/寄存器(上下文切换)→ 调度另一进程
- 若 cat 为多线程实现,线程共享地址空间,切换开销小于进程切换(无需换页表)
- 多线程共享变量时需锁/信号量;不当申请资源可能死锁(四条件 / 银行家算法)
5. 打开文件 open("hello.txt")
cat 调用 open → 系统调用陷入内核(异常/陷阱)→ 路径解析:
- VFS 统一接口 → 具体 FS(如 ext4)查 inode、权限
- dentry 缓存 命中则跳过磁盘目录读;未命中则读盘填缓存
- 分配 fd,写入 cat 进程的打开文件表(
struct file,f_pos=0)
6. 读文件 read(fd, buf, n)
- 先查 页缓存:命中则直接从内存拷贝到用户 buf,无磁盘 I/O
- 未命中 → 块层发起读请求 → 磁盘调度(SSTF/SCAN 等)排序 → 驱动 发 DMA 命令
- 若底层是 RAID 5/10 等,块层之下还有条带/校验逻辑(对应用透明)
- cat 进程在 I/O 等待时 Blocked;DMA 完成后磁盘发 I/O 中断 → 驱动唤醒 cat → Ready → 再次被调度 Running
- 数据经页缓存填入;若物理页框不足,可能触发页面置换(LRU/Clock)
- 顺序读可触发预读;写路径则标脏页,靠 flusher / fsync 落盘(日志 FS 保证崩溃一致性)
7. 内存访问与缺页
cat 执行期间访问代码/栈/堆:
- 虚拟地址经 MMU 查 TLB → 命中则直接得物理地址
- TLB 缺失 → 查多级页表(二级/三级)→ 回填 TLB;EAT 由命中率与访存次数决定
- 页表项存在位为 0 → 缺页异常 → 内核从磁盘/交换区换入 → 更新页表 → 重执指令
- malloc 扩堆时
brk/mmap系统调用,内核分配虚拟区,首次访问时才按需分配物理页 - 对比早期:连续分配用 FF/BF/WF,易生外部碎片;分页解决外部碎片,末页仍有内部碎片
8. 输出到终端
cat 把读到的内容 write 到 stdout(fd=1,指向终端):
- 经字符设备驱动 → 终端显示;若输出量大,可能经缓冲/Spooling 思想批量刷新
- 亦可用 mmap 映射文件后直接按地址访问,减少一次拷贝
9. 进程结束与回收
- cat exit → 释放用户态资源,PCB 变僵尸;父 Shell 被唤醒,wait 回收退出码
- 关闭 fd,页缓存中脏页由后台 flusher 或 fsync 刷盘
10. 关机
- sync 把页缓存脏数据、元数据写回磁盘(文件系统一致性;有日志则按 journal 提交)
- 卸载文件系统,驱动关闭设备;若为 LVM/动态卷,先处理逻辑卷再卸底层分区
- 内核停机
▸一条线串起来
系统调用是入口 → 进程/调度决定谁跑 → 同步/死锁机制保证并发正确 → 虚拟内存/TLB/缺页决定数据在哪(分页解决碎片) → 分区/格式化/FS/VFS/页缓存组织持久存储 → RAID 可选地增强块设备 → I/O/驱动/DMA/中断/磁盘调度完成慢速设备访问。
设计思想
| 思想 | 含义 | 在笔记中的体现 |
|---|---|---|
| 抽象 | 用统一模型隐藏硬件细节 | 进程抽象 CPU;虚拟内存抽象物理 RAM;文件抽象磁盘块;VFS 抽象多种 FS;分卷抽象多盘 |
| 隔离 | 防止进程互相干扰 | 用户态/内核态(Ring 3/0);独立地址空间;文件权限与 uid/gid;宏/微内核可靠性权衡 |
| 复用 | 有限资源供多用户/多任务共享 | 多道/分时;多线程共享进程资源;虚拟内存超配;SPOOLing;RAID 条带并行 |
| 缓存 | 用局部性加速访问 | CPU Cache;TLB;页缓存;dentry/inode 缓存;磁盘预读 |
| 延迟 | 推迟昂贵操作到最后必要时刻 | 写回式页缓存;COW;按需分页;延迟分配;高级格式化只重建元数据 |
| 统一 | 一套接口覆盖多种实现 | 系统调用;VFS;块/字符设备 read/write;socket 统一网络 I/O |
| 冗余 | 用额外空间换可靠性 | RAID 1/5/6/10;GPT 备份分区表;日志 FS;备份 ≠ RAID |
| 权衡 | 无全能方案,只选场景 | CPI 三要素;FF/BF/WF;RAID 容量·速度·可靠;内核宏 vs 微 |
复习抓手
每个模块按四问自检:
- 管什么资源?(CPU 时间 / 内存页框 / 磁盘块 / 设备 / 阵列冗余)
- 如何抽象?(进程、虚拟地址、文件、fd、分区、卷)
- 并发下如何同步?(锁、信号量、管程;CPU 调度;磁盘调度)
- 故障如何处理?(缺页、I/O 中断、死锁检测/避免、RAID 重建、fsck/日志)
补充自检:
- 性能:CPI、EAT、磁盘访问时间、RAID 写惩罚、磁盘调度寻道距离
- 碎片:外部 vs 内部;分页为何仍有内部碎片
- 存储栈:分区 → 格式化 → FS → 页缓存 → 块层 → 驱动 →(可选 RAID)→ 磁盘
按此四问与清单串联,比孤立背定义更稳固。