
- 全名
- Deep Learning。
- 主讲
- Andrew Ng;
- Kian Katanforoosh。
- 形式
- 翻转课堂(flipped classroom);
- 课前:deeplearning.ai Deep Learning Specialization 的视频、测验与编程作业;
- 课上:项目周期、对抗稳健性(adversarial robustness)、生成模型(generative model)、深度强化学习(deep reinforcement learning)、LLM 应用、可解释性(interpretability);
- 期末为开放项目。
- 入口
- Stanford Bulletin:CS230
- 课程主页
- Syllabus
- CS230 Cheatsheets(Afshine & Shervine Amidi,Winter 2019 TA 整理):三份图解速查(CNN / RNN / Tips),对应 Coursera C2–C5 应用部分;非 Stanford 官方讲义,GitHub 镜像与 PDF。
- 参考书
- 斋藤康毅《深度学习入门:基于 Python 的理论与实现》(Deep Learning from Scratch),下文简称“鱼书”。
全文的主线是:先说明一个神经网络算什么(前向传播),再说明它怎么学(损失函数、梯度、反向传播),然后说明怎样学得好(初始化、正则化、优化器、BatchNorm、项目策略),最后进入特定数据的结构(图像用卷积,序列用循环网络与注意力)。
预备知识
数学
KL 散度的定义、非负证明、数值例子,以及蒸馏、VAE、RLHF 与最大似然四种用法,见 信息论基础 · 相对熵。
记号
监督学习的设定
监督学习(supervised learning)给定成对的数据 $(x,y)$,希望学到一个映射 $x\mapsto\hat{y}$,使预测 $\hat{y}$ 尽量接近标签 $y$。深度网络把这个映射写成“一串仿射变换 + 逐点非线性”的复合:每一层先做 $Wa+b$,再套一个激活函数 $g$。衡量 $\hat{y}$ 与 $y$ 差距的标量称为损失 $J$,训练就是调整所有 $W,b$ 让 $J$ 变小。
三种上标
一个量可能同时属于“第几个样本”“第几层”“第几个时间步”,CS230 用三种括号区分:
$$ x^{(i)}\ \text{(第 }i\text{ 个样本,圆括号)},\qquad W^{[l]}\ \text{(第 }l\text{ 层,方括号)},\qquad a^{\langle t\rangle}\ \text{(第 }t\text{ 个时间步,尖括号)}. $$
层与样本同时出现时常合并为一个上标,中间加逗号,写成 $a^{[l],(i)}$(层号 [l] 与样本号 (i) 之间必须有逗号,否则渲染后样本下标常会丢失)。例如 $l=2$、$i=5$ 时,即第 5 个样本在第 2 层的激活。
维度符号
- $m$:训练样本数。
- $n_x=n^{[0]}$:输入特征维数。
- $n^{[l]}$:第 $l$ 层神经元个数。
- $L$:网络层数,输出层是第 $L$ 层;输入层记作第 0 层,不计入层数。
- $X\in\mathbb{R}^{n_x\times m}$:设计矩阵,每一列是一个样本。
- $Y\in\mathbb{R}^{n_y\times m}$:标签矩阵;二分类时 $n_y=1$。
- $W^{[l]}\in\mathbb{R}^{n^{[l]}\times n^{[l-1]}}$,$b^{[l]}\in\mathbb{R}^{n^{[l]}\times 1}$。
- $Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]}$ 是线性部分,$A^{[l]}=g^{[l]}(Z^{[l]})$ 是激活,$A^{[0]}=X$。
- $\hat{Y}=A^{[L]}$。
$W^{[l]}$ 的形状之所以是“本层 × 上一层”,是因为它要左乘上一层的激活:$(n^{[l]},n^{[l-1]})\times(n^{[l-1]},m)=(n^{[l]},m)$。
单样本与整批
对单个样本,第 $l$ 层的计算是
$$ z^{[l],(i)}=W^{[l]}a^{[l-1],(i)}+b^{[l]},\qquad a^{[l],(i)}=g^{[l]}\big(z^{[l],(i)}\big). $$
把 $m$ 个样本的列向量并排放成矩阵,同一个式子就能一次算完整批:
$$ Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]}. $$
这里 $W^{[l]}A^{[l-1]}$ 的形状是 $(n^{[l]},m)$,而 $b^{[l]}$ 只有 $(n^{[l]},1)$。两者能相加,靠的是 NumPy 的广播(broadcasting):形状不同的数组做逐元素运算时,长度为 1 的维度会被自动复制,直到两边形状一致。所以 $b^{[l]}$ 会沿列复制 $m$ 份,每个样本加上同一个偏置。
▸例0 广播与矩阵乘法的形状规则
广播:标量与数组运算时,标量会与每个元素运算;$(2,2)$ 的矩阵与 $(2,)$ 的向量相加时,向量被复制成两行。
1
2
3
4
5
import numpy as np
A = np.array([[1, 2], [3, 4]])
B = np.array([10, 20])
A * B # array([[10, 40], [30, 80]])
1.0 / np.array([1.0, 2.0, 3.0]) # array([1., 0.5, 0.33333333])
矩阵乘法要求左矩阵的列数等于右矩阵的行数,结果的形状是“左行数 × 右列数”:
1
2
3
4
5
A = np.array([[1, 2, 3], [4, 5, 6]]) # (2, 3)
B = np.array([[1, 2], [3, 4], [5, 6]]) # (3, 2)
np.dot(A, B) # array([[22, 28], [49, 64]]),形状 (2, 2)
C = np.array([[1, 2], [3, 4]]) # (2, 2)
np.dot(A, C) # ValueError: shapes (2,3) and (2,2) not aligned
正因为形状不对就会直接报错(或者更糟,被广播成错误的形状却不报错),实现时应在注释里写明每个数组的 shape。
逐层形状表
二分类($n_y=1$)时各量的形状如下。梯度与对应的量同形,这是检查实现最便宜的办法。
| 量 | shape |
|---|---|
| $X=A^{[0]}$ | $(n^{[0]}, m)$ |
| $W^{[l]}$ | $(n^{[l]}, n^{[l-1]})$ |
| $b^{[l]}$ | $(n^{[l]}, 1)$ |
| $Z^{[l]}, A^{[l]}$ | $(n^{[l]}, m)$ |
| $\mathrm{d}Z^{[l]}, \mathrm{d}A^{[l]}$ | 与 $Z^{[l]}$ 相同 |
| $\mathrm{d}W^{[l]}, \mathrm{d}b^{[l]}$ | 与对应参数相同 |
▸形状表实例:$3\to2\to1$ 网络、$m=4$ 列样本(矩阵长什么样)
取 $n^{[0]}=3$ 个输入特征、第 1 隐藏层 $n^{[1]}=2$ 个神经元、输出层 $n^{[2]}=1$(二分类 logits),批量大小 $m=4$。列是样本(与上表一致)。
第 0 层:输入 $X=A^{[0]}$,shape $(3,4)$——3 行是特征,4 列是 4 张图/4 条记录:
1
2
3
4
5
6
7
样本1 样本2 样本3 样本4
┌──────┬──────┬──────┬──────┐
特征1 │ x11 │ x12 │ x13 │ x14 │
特征2 │ x21 │ x22 │ x23 │ x24 │
特征3 │ x31 │ x32 │ x33 │ x34 │
└──────┴──────┴──────┴──────┘
(3 × 4)
第 1 层 $W^{[1]}$ 为 $(2,3)$,$b^{[1]}$ 为 $(2,1)$:
1
2
3
4
5
6
7
8
W^[1] (2×3):2 个隐藏单元,每个连 3 个输入
┌─────────────────┐
h1 │ w11 w12 w13 │
h2 │ w21 w22 w23 │
└─────────────────┘
b^[1] (2×1):┌ b1 ┐ 广播后加到 Z^[1] 的每一列
└ b2 ┘
前向:$Z^{[1]}=W^{[1]}X+b^{[1]}$ → $(2,3)(3,4)+(2,1)=(2,4)$;$A^{[1]}=g^{[1]}(Z^{[1]})$ 仍是 $(2,4)$。含义:2 行 = 2 个隐藏神经元,4 列 = 4 个样本各自的前向结果。
1
2
3
4
5
6
Z^[1]、A^[1] (2×4):
样本1 样本2 样本3 样本4
┌──────┬──────┬──────┬──────┐
隐藏单元1 │ · │ · │ · │ · │
隐藏单元2 │ · │ · │ · │ · │
└──────┴──────┴──────┴──────┘
第 2 层(输出) $W^{[2]}$ 为 $(1,2)$,$b^{[2]}$ 为 $(1,1)$:
$Z^{[2]}=W^{[2]}A^{[1]}+b^{[2]}$ → $(1,2)(2,4)+(1,1)=(1,4)$;$\hat Y=A^{[2]}$(sigmoid 或 softmax 前为 logits)shape $(1,4)$,一行、四列 = 四个样本的分数。
反向(只看第 1 层):设上游 $\mathrm{d}Z^{[1]}$ 为 $(2,4)$,与 $Z^{[1]}$ 同形。
- $\mathrm{d}W^{[1]}=\mathrm{d}Z^{[1]}X^{\top}/m$ → $(2,4)(4,3)/4=(2,3)$,与 $W^{[1]}$ 同形;
- $\mathrm{d}b^{[1]}=\mathrm{mean}(\mathrm{d}Z^{[1]},\ \text{axis=1,\ keepdims=True})$ → $(2,1)$;
- $\mathrm{d}A^{[0]}=W^{[1]\top}\mathrm{d}Z^{[1]}$ → $(3,2)(2,4)=(3,4)$,与 $X$ 同形,继续往更浅层传。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import numpy as np
n0, n1, n2, m = 3, 2, 1, 4
X = np.random.randn(n0, m) # (3, 4)
W1, b1 = np.random.randn(n1, n0), np.random.randn(n1, 1)
W2, b2 = np.random.randn(n2, n1), np.random.randn(n2, 1)
Z1 = W1 @ X + b1 # (2,4);b1 沿列广播
A1 = np.maximum(0, Z1) # ReLU,(2,4)
Z2 = W2 @ A1 + b2 # (1,4)
assert Z1.shape == (n1, m) and W1.shape == (n1, n0)
assert Z2.shape == (n2, m) and W2.shape == (n2, n1)
dZ1 = np.random.randn(n1, m)
dW1 = dZ1 @ X.T / m # (2,3)
db1 = dZ1.mean(axis=1, keepdims=True) # (2,1)
dX = W1.T @ dZ1 # (3,4)
assert dW1.shape == W1.shape and db1.shape == b1.shape and dX.shape == X.shape
记忆口诀:$W^{[l]}$ 的行数 = 本层宽度 $n^{[l]}$,列数 = 上一层宽度 $n^{[l-1]}$;$Z^{[l]},A^{[l]}$ 永远是 $(n^{[l]}, m)$。
- 命名
- 代码里的
dW表示 $\partial J/\partial W$,不是数学上的微分 $\mathrm{d}W$; - 每算完一个梯度就
assert dW.shape == W.shape,可以卡住绝大多数转置错误; - 若 $W^{[l]}$ 被误写成 $(n^{[l-1]}, n^{[l]})$,后续每条梯度公式都会差一个转置。
- 代码里的
- 额外维度
- 时间序列另加一维 $T$;
- 图像另加 $H,W,C$(高、宽、通道);
- 全连接作业:batch 维在最后一维;
- 卷积作业:batch 维在第一维
(m, n_H, n_W, n_C)(NHWC); - 两套约定不能混用。
▸两种排布:列样本与行样本
CS230 把样本排成列,所以写 $Z=WA+b$,$W$ 的形状是(输出, 输入)。鱼书与 PyTorch 的 nn.Linear 把样本排成行,写 $Y=XW+b$,$W$ 的形状是(输入, 输出)。两者只差一个整体转置,但反向公式的写法会跟着变:
- 列样本:$\mathrm{d}W=\frac{1}{m}\,\mathrm{d}Z\,A^{\top}$,$\mathrm{d}A_{\text{prev}}=W^{\top}\mathrm{d}Z$;
- 行样本:$\mathrm{d}W=X^{\top}\,\mathrm{d}Y$,$\mathrm{d}X=\mathrm{d}Y\,W^{\top}$。
对照两边资料时,先确认样本放在行还是列。
两个常用的矩阵求导恒等式
反向传播反复用到下面两条:
$$ \frac{\partial}{\partial W}(WA)\ \leadsto\ \text{右乘 } A^{\top},\qquad \frac{\partial}{\partial A}(WA)\ \leadsto\ \text{左乘 } W^{\top}. $$
精确的含义是:若 $Z=WA$ 且已知上游梯度 $\mathrm{d}Z=\partial J/\partial Z$,则
$$ \frac{\partial J}{\partial W}=\mathrm{d}Z\,A^{\top},\qquad \frac{\partial J}{\partial A}=W^{\top}\mathrm{d}Z. $$
验证方法是逐元素写出来:$Z_{kj}=\sum_{r}W_{kr}A_{rj}$,所以 $\partial Z_{kj}/\partial W_{kr}=A_{rj}$,对所有 $j$ 求和得 $\partial J/\partial W_{kr}=\sum_j \mathrm{d}Z_{kj}A_{rj}=(\mathrm{d}Z\,A^{\top})_{kr}$。写不出转置放哪边时,用形状反推最快:$\mathrm{d}W$ 必须是 $(n^{[l]},n^{[l-1]})$,而 $\mathrm{d}Z$ 是 $(n^{[l]},m)$、$A$ 是 $(n^{[l-1]},m)$,唯一能拼出来的就是 $\mathrm{d}Z\,A^{\top}$。
外积视角:$\mathrm{d}W=\mathrm{d}Z A^{\top}/m$ 等于把 $m$ 个样本各自的外积 $(n^{[l]},1)\times(1,n^{[l-1]})$ 加起来再平均。矩阵乘法只是把这个求和交给 BLAS 一次做完。
代码
Coursera C1M2(Python Basics with NumPy)与后续所有作业都假设:会用 NumPy 向量化代替 Python 循环,并能在写 mean / sum 时选对 axis,必要时加上 keepdims=True(PyTorch 里同名参数写作 keepdim=True)。本节约定与上文一致:样本在列,矩阵 $X\in\mathbb{R}^{n_x\times m}$ 的第 $j$ 列是第 $j$ 个样本。
广播(broadcasting)
定义:两个数组做 +、*、/ 等逐元素运算时,NumPy 从最后一维开始对齐形状;某一维长度为 $1$ 时,该维会被复制到与另一边相同;若某维既不相等、又不是 $1$,则报错 operands could not be broadcast together。
| 左 shape | 右 shape | 结果 shape | 含义(列样本) |
|---|---|---|---|
| $(n,m)$ | $(n,1)$ | $(n,m)$ | 偏置 $b$(正确):$(n,1)$ 先变成 $(n,m)$,每一列(每个样本)加上同一组 $n$ 个偏置 |
| $(n,m)$ | $(1,m)$ | $(n,m)$ | 长度为 $m$ 的向量贴在一行,沿行方向复制 $n$ 次(每行相同) |
| $(n,m)$ | $(m,)$ | $(n,m)$ | 与上一行同类:$(m,)\to(1,m)$,每一列一个数,该列内 $n$ 行相同(像「按样本」的缩放,不是 $(n,1)$ 偏置) |
| $(n,m)$ | $(n,)$ | 常错 | $n\neq m$ 时末维对不齐,直接 ValueError;勿与第一行混淆 |
前向 $Z=W A+b$ 中 $W A$ 是 $(n^{[l]},m)$,$b$ 必须是 $(n^{[l]},1)$(第二维为 1),对应表格第一行:不是把长度为 $n$ 的一维数组 (n,) 丢进去。此shape 在 $n^{[l]}\neq m$ 时不能相加,即便 $n=m$ 凑巧能加,语义也不是「每个神经元一份偏置、复制到 $m$ 个样本」。
▸「沿列复制」在说什么
- 第一行 $(n,1)$:$b$ 只有一列,NumPy 把它横向复制 $m$ 次,对齐 $(n,m)$ 的 $m$ 个样本列;同一神经元(同一行) 在所有样本上共享一个偏置。口语里常说「沿列方向复制 $m$ 份」。
- 第四行 $(n,)$:这是一维、长度为 $n$,没有
(n,1)那个「列长为 1」的轴。和 $(n,m)$ 相加时,NumPy 从最后一维对齐:要比的是 $m$ 与 $n$,通常 $n^{[l]}\neq m$ → 报错。所以第四行写「常错」,不是说它和第一行做同一件事;正确偏置是第一行,不是第四行。 - 更易混的是
(m,)(第三行):能合法加到 $(n,m)$,但是「每个样本列一个标量、列内各行相同」,与「每个神经元一行一个偏置、整列复制」的 $(n,1)$ 不同。
▸广播:合法、非法与「静默错位」
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import numpy as np
n, m = 3, 4
Z = np.arange(n * m, dtype=float).reshape(n, m) # (3, 4),行=特征/神经元,列=样本
b = np.array([[10.0], [20.0], [30.0]]) # (3, 1)
assert (Z + b).shape == (n, m)
row_scale = np.array([1.0, 0.0, -1.0, 2.0]) # (m,)→(1,m):每列(样本)一个因子
assert (Z * row_scale).shape == (n, m)
# 非法: (3,4) 与 (3,) 逐元素加 —— NumPy 会把 (3,) 当成 (1,3) 对齐,无法与 4 列对齐
# Z + np.array([1.0, 2.0, 3.0]) # ValueError
# 危险: (2,3) 与 (3,) 能广播成 (2,3),但语义是「每一行加上同一个长度-3 向量」
A = np.zeros((2, 3))
A + np.array([1.0, 2.0, 3.0]) # 不报错;与「给每个样本加偏置」不是同一回事
▸广播不会代替矩阵乘法
A * B是逐元素乘,不是线性代数里的矩阵积。- 前向:$Z=WA+b$ 必须写
Z = W @ A + b(或np.dot(W, A)),不能写W * A。 - 反向(列样本):$\mathrm{d}W=\mathrm{d}Z\,A^{\top}/m$ 必须写
dW = dZ @ A.T / m。若写成dW = dZ * A.T,NumPy 可能按广播规则凑出与W相同 shape 的数组,但每个元素不是 $\partial J/\partial W$。
1
2
3
# 形状 (n, m) 与 (m, p):矩阵乘 vs 逐元素(后者常因广播不报错)
dW_ok = dZ @ A.T / m # (n, p),正确
dW_bad = dZ * A.T # 勿用;广播后 shape 可能仍是 (n, p),数值错误
axis:沿哪一维聚合
对二维数组 arr,axis=0 表示竖着切:固定列、在行方向合并(对 CS230 的 $(n_x,m)$,沿 axis=0 是在所有特征/神经元行上聚合,得到长度为 $m$ 的向量)。axis=1 表示横着切:固定行、在列方向合并(对 $(n_x,m)$,沿 axis=1 是在样本列上聚合,得到长度为 $n_x$ 的向量)。
| 数组 | 操作 | 结果 shape | 典型用途 |
|---|---|---|---|
| $X$ $(n_x,m)$ | X.mean(axis=0) |
$(m,)$ | 每个样本在特征维上的均值(少用) |
| $X$ $(n_x,m)$ | X.mean(axis=1) |
$(n_x,)$ | 每个特征跨样本的均值(BatchNorm 统计常沿「非 batch 维」) |
| $\mathrm{d}Z$ $(n,m)$ | dZ.sum(axis=1) |
$(n,)$ | 对 $m$ 个样本的梯度求和 → $\mathrm{d}b$ 的向量形式 |
| $\mathrm{d}Z$ $(n,m)$ | dZ.sum(axis=1, keepdims=True) |
$(n,1)$ | 与 $b$ 同形,可直接写回参数 |
记忆(列样本):偏置 $b$ 的每个分量被所有样本共用,反向时要把 $\mathrm{d}Z$ 在样本维上累加,即 axis=1($m$ 在 axis=1)。若误用 axis=0,会把不同神经元/特征上的梯度混在一起。
▸数值对照
1
2
3
4
5
6
7
8
9
10
11
12
import numpy as np
X = np.array([[1.0, 2.0, 3.0], # 特征 0,3 个样本
[10.0, 20.0, 30.0]]) # 特征 1
# shape (2, 3):行=特征,列=样本
X.mean(axis=0) # array([ 5.5, 11. , 16.5]) 每个样本上两特征的均值
X.mean(axis=1) # array([ 2., 20.]) 每个特征跨 3 个样本的均值
dZ = np.array([[0.1, 0.2, 0.3],
[1.0, 2.0, 3.0]]) # (2, 3),与 Z 同形
dZ.sum(axis=1) # array([0.6, 6. ]) shape (2,)
dZ.sum(axis=1, keepdims=True) # [[0.6], [6. ]] shape (2, 1)
高维时 axis 可以是元组:例如 NHWC 的 img 为 (m, H, W, C),对 batch 求均值用 axis=0;对空间求均值用 axis=(1,2)。CS230 全连接段以二维 $(n,m)$ 为主,先把二维写对再推广。
keepdims=True:聚合后保留长度为 1 的维
mean / sum / max 默认会删掉被聚合的那一维:$(n,m)$ 上 axis=1 → $(n,)$。参数 $b$ 与 $\mathrm{d}b$ 在 CS230 里形状是 $(n,1)$,不是 $(n,)$。加上 keepdims=True 后,被聚合的维保留为 $1$,结果 $(n,1)$,可与 $b$、$\mathrm{d}Z$ 直接相加或赋值给 b.grad 形状检查。
| 写法 | shape | 能否与 $(n,m)$ 的 $\mathrm{d}Z$ 逐元素加后再广播 |
|---|---|---|
dZ.mean(axis=1) |
$(n,)$ | 能广播,但 db.shape != b.shape,assert 失败 |
dZ.mean(axis=1, keepdims=True) |
$(n,1)$ | 与 $b$ 一致 |
dZ.mean(axis=1)[:, None] |
$(n,1)$ | 与 keepdims=True 等价 |
dZ.mean(axis=1, keepdims=True) / m |
$(n,1)$ | mini-batch 上 $\mathrm{d}b=\frac{1}{m}\sum_j \mathrm{d}Z_{\cdot j}$ |
▸Coursera C1M2 · Python Basics with NumPy(assignment wording)
With keepdims=True the result will broadcast correctly against the original x.
axis=1 means you are going to get the norm in a row-wise manner. If you need the norm in a column-wise way, you would need to set axis=0.
numpy.linalg.norm has another parameter ord where we specify the type of normalization to be done (in the exercise below you’ll do 2-norm). To get familiar with the types of normalization you can visit numpy.linalg.norm.
与上文列样本 $(n_x,m)$ 对照:x 的每一行是一条特征在 $m$ 个样本上的取值;np.linalg.norm(x, axis=1, keepdims=True) 对每一行做 2-范数(row-wise),结果 shape $(n_x,1)$,可与 x 做逐元素除法(L2 归一化每行)。若要对每个样本列求范数,用 axis=0。作业里的 ord=2 即欧几里得范数 $\lVert\cdot\rVert_2$;ord=1 为 L1,ord=np.inf 为最大绝对值等,见文档。
▸`mean` 与 `sum`:作业里两种写法
对 $\mathrm{d}b$,有的 notebook 写 dZ.sum(axis=1, keepdims=True) / m,有的写 dZ.mean(axis=1, keepdims=True);在除以 $m$ 的损失定义下,两者对应同一偏置梯度。关键是 axis=1 与 keepdims 同时正确,而不是混用 axis=0。
▸逻辑回归与一层 Affine:完整形状链
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import numpy as np
n_x, m = 5, 8
X = np.random.randn(n_x, m) # (5, 8)
w = np.random.randn(n_x, 1) # (5, 1)
b = 0.1
Z = w.T @ X + b # (1, 8);标量 b 广播到整行
A = 1 / (1 + np.exp(-Z)) # (1, 8)
Y = np.random.randint(0, 2, size=(1, m))
dZ = A - Y # (1, 8)
dw = (X @ dZ.T) / m # (5, 1),与 w 同形;等价于 dZ @ X.T 再转置
db = float(dZ.mean()) # 标量 b 的梯度
W = np.random.randn(4, n_x) # (4, 5)
b_vec = np.random.randn(4, 1) # (4, 1)
Z2 = W @ X + b_vec # (4, 8)
dZ2 = np.random.randn(4, m)
dW = dZ2 @ X.T / m # (4, 5)
db_vec = dZ2.sum(axis=1, keepdims=True) / m # (4, 1)
assert db_vec.shape == b_vec.shape
PyTorch 对照
| NumPy | PyTorch | 说明 |
|---|---|---|
keepdims=True |
keepdim=True |
拼写差一个 s |
| 样本在列 $(n,m)$ | 样本在行 $(m,n)$ | nn.Linear 默认 x 为 (batch, in_features) |
dZ.mean(axis=1, keepdims=True) |
dZ.mean(dim=1, keepdim=True) |
dim 与 axis 同义 |
从 NumPy 作业迁到 PyTorch 时,先改样本维位置,再改 axis→dim;广播规则相同。
▸与上文「例0 / 形状表实例」的关系
「单样本与整批」与形状表里的 db1 = dZ1.mean(axis=1, keepdims=True) 是本节在 $(n^{[l]},m)$ 上的具体实例。实现每层反向时,应对每个 mean/sum 写一行注释:# axis=1: sum over m samples; keepdims -> (n,1).
零数组:np.zeros
作业里到处要“先造一个全 0 的数组再往里填”:初始化偏置 $b$、Adam 的动量 $v$ 和 $s$、累加梯度用的容器。下面先讲这几个函数怎么用,再讲最常踩的坑。权重为什么不能全 0、应当怎样随机初始化(随机、He、Xavier 的完整代码),见后文“初始化”一节。
四个函数
| 函数 | 作用 | 例子 | 结果 |
|---|---|---|---|
np.zeros(shape) |
按给定形状造全 0 数组 | np.zeros((3, 1)) |
3 行 1 列,float64 |
np.zeros_like(a) |
造一个和 a 形状、类型都一样的全 0 数组 |
np.zeros_like(W) |
与 W 同形 |
np.ones(shape) / np.full(shape, c) |
全 1 / 全填常数 c |
np.full((2, 2), 0.5) |
每个元素都是 0.5 |
np.empty(shape) |
只分配内存,不清零 | np.empty((2, 2)) |
里面是内存里的旧数据,不能当 0 用 |
典型用法
1 | import numpy as np |
zeros_like 的好处是不用自己再写一遍形状:以后 W 改了大小,v_dW 跟着变,不会出现形状对不上。
易错点
- 形状要写成元组。
np.zeros(3, 4)会报TypeError: Cannot interpret '3' as a data type,因为第二个位置参数是dtype。正确写法是np.zeros((3, 4)),外面多一层括号。 (n,)和(n, 1)不是一回事。np.zeros(3)得到一维的(3,);偏置要用np.zeros((3, 1))。用(3,)做偏置,加到(3, m)上时会按“最后一维”去对齐,结果要么报错,要么加错方向(见上文广播一节)。作业的assert b.shape == (n, 1)就是在查这个。zeros_like会继承类型。 如果a是整数数组,np.zeros_like(a)也是整数数组:需要小数时写1
2
3
4a = np.array([1, 2, 3])
z = np.zeros_like(a)
z[0] = 0.7 # 存进去的是 0,小数被截掉
z += 0.7 # 直接报错:float 不能原地写进 int 数组np.zeros_like(a, dtype=float)。W = b = np.zeros(...)是同一个数组。 这样写只造了一个数组,W和b两个名字都指向它:W += 1之后b也变成了 1。要两个独立的数组,就分开写两次np.zeros。np.empty不是 0。 它更快,但里面是随机残留值,只能在“马上会把每个位置都覆盖掉”时使用。拿它当累加器,结果是错的。- 层号对齐。
layers_dims = [n_x, n1, n2, n3]时,第l层的权重形状是(layers_dims[l], layers_dims[l-1]),循环从l = 1开始:从1
2
3for l in range(1, len(layers_dims)):
parameters["W" + str(l)] = np.zeros((layers_dims[l], layers_dims[l - 1]))
parameters["b" + str(l)] = np.zeros((layers_dims[l], 1))l = 0开始会去读layers_dims[-1],也就是最后一层的宽度,不报错但形状全错。字典的键要用"W" + str(l),不能写"W" + l(字符串不能直接加整数)。
逐元素平方:np.square
C2M1 Regularization 作业里,$L_2$ 正则的代价项要算“每一层权重矩阵所有元素的平方和”,也就是 Frobenius 范数的平方 $\lVert W\rVert_F^2=\sum_{i,j}W_{ij}^2$。写成代码分两步:np.square(W) 把每个元素各自平方,形状不变;np.sum(...) 再把所有元素加起来,得到一个标量。公式与推导见后文“正则化”一节的 $L_2$ 部分,这里只讲函数怎么用。
用法
1 | import numpy as np |
下面几种写法结果相同,都等于 14.25:
| 写法 | 说明 |
|---|---|
np.sum(np.square(W)) |
作业的写法 |
np.sum(W ** 2) / (W ** 2).sum() |
** 也是逐元素运算 |
np.sum(W * W) |
* 是逐元素乘,不是矩阵乘 |
np.linalg.norm(W) ** 2 |
矩阵默认取 Frobenius 范数,再平方 |
在作业里的两处用法
一是正则化的代价。作业的三层网络有 $W^{[1]},W^{[2]},W^{[3]}$,代价写成交叉熵加上
$\frac{1}{m}\cdot\frac{\lambda}{2}\sum_{l}\lVert W^{[l]}\rVert_F^2$:
1 | def compute_cost_with_regularization(A3, Y, parameters, lambd): |
二是反向传播。$\frac{\partial}{\partial W}\frac{\lambda}{2m}\lVert W\rVert_F^2=\frac{\lambda}{m}W$,平方求导后只剩 $W$ 本身,所以反向里不再出现 np.square,只在每个 $\mathrm{d}W$ 上加一项:
1 | dW3 = 1. / m * np.dot(dZ3, A2.T) + (lambd / m) * W3 # 每层同理;db 不加 |
易错点
- 只惩罚 $W$,不惩罚 $b$。 求和里只放
W1、W2、W3。若用循环遍历parameters,要先判断键名以"W"开头(后文正则化一节的l2_cost就是这样写的)。 - 不要写
axis。np.sum默认对所有元素求和,正好是需要的标量。写成np.sum(np.square(W), axis=1)得到的是每一行的平方和,形状 $(n^{[l]},)$,再和交叉熵相加会变成数组,代价不再是一个数。 ^不是乘方。 Python 里3 ^ 2是按位异或,结果是1;乘方要写3 ** 2或np.square(3)。- 整数数组会溢出。
np.square(np.array([50000], dtype=np.int32))得到-1794967296,因为结果超出了 int32 的范围,而且不报错。权重本来就是 float64,不会遇到;自己造测试数据时注意用浮点数。 - 变量名用
lambd。lambda是 Python 关键字,不能当变量名,作业因此写成lambd。 - 系数不要漏。 代价里是 $\frac{\lambda}{2m}$,梯度里是 $\frac{\lambda}{m}$:那个 $\frac12$ 正是为了让平方求导后的 2 消掉。两处任何一处系数写错,梯度检查都会对不上。
复杂度
训练一个网络之前,应当能粗略估计它要算多久、占多少显存。估算的原则是:只看随规模增长的那几个维度,常数忽略。
- 时间复杂度
- 全连接层 $n^{[l-1]}\rightarrow n^{[l]}$、batch 大小 $m$:一次矩阵乘 $O(m\, n^{[l]} n^{[l-1]})$;
- 深度 $L$ 的网络:前向与反向同阶,反向的常数更大(每层要做两次矩阵乘:一次求 $\mathrm{d}W$,一次求 $\mathrm{d}A$),一般估为前向的 2 倍;
- 卷积层:输入 $H\times W$,通道 $C_{\mathrm{in}}\rightarrow C_{\mathrm{out}}$,核 $f\times f$,约 $O(m H W C_{\mathrm{out}} C_{\mathrm{in}} f^{2})$;
- 自注意力:长度 $T$、宽度 $d$,为 $O(T^{2}d)$,这是长序列的主要瓶颈。
- 空间复杂度
- 反向传播需要前向时的中间结果,所以必须保存各层 $A^{[l]}$,以及 BatchNorm 的均值方差、Dropout 的掩码;
- 因此激活往往比权重更占显存;
- batch 从 32 增到 256,显存近似线性上升(激活随 $m$ 线性增长),参数量不变。
▸衔接
记号已经固定:$X$ 为 $(n_x,m)$、$W^{[l]}$ 为 $(n^{[l]},n^{[l-1]})$,梯度与原量同形。下一部分从最简单的“神经元”——感知机——出发,一步步加上可学习的参数、平滑的激活和隐藏层。
浅层网络
这一部分的路线是:
- 感知机:一个神经元能表示什么、不能表示什么(XOR);
- 逻辑回归:把阶跃换成 sigmoid,让参数可以用梯度自动学习,并引出损失函数与梯度下降;
- 浅层网络:插入一层隐藏层,使决策边界可以弯曲;
- 反向传播:用计算图把梯度的计算拆成局部步骤,得到两层网络的完整训练算法。
为什么是现在
神经网络的基本想法在 1980 年代就有了,C1M1 用一张图解释为什么到 2010 年代才突然好用:横轴是带标签数据量,纵轴是模型表现。
- 传统算法(逻辑回归、SVM 等):数据少时表现不错,但数据再多,曲线很快变平,多出的数据用不上;
- 小型神经网络:曲线比传统算法稍高、平得稍晚;
- 大型神经网络:数据越多表现越好,在很大的数据量范围内仍不饱和。
所以要拿到最好的表现,需要同时具备两件事:足够大的网络和足够多的数据。数据少时,各种算法的排序主要取决于特征工程和细节,大网络未必占优;只有在大数据区间,大网络的优势才稳定地体现出来。
推动这件事的三股力量,课上称为“规模驱动深度学习的进步”(scale drives deep learning progress):
- 数据:手机、传感器、互联网让带标签的数据量暴增;
- 算力:GPU 和专用硬件让训练大网络变得可行;
- 算法:很多算法改进的目的就是让计算更快。例如把 sigmoid 换成 ReLU,消除了饱和区的梯度消失,梯度下降快得多。
算力还有一层间接作用:深度学习是高度经验化的迭代过程,“想法 → 写代码 → 实验 → 再改想法”。一次实验从一个月缩短到十分钟,同样时间内能试的想法就多了上百倍,进步因此加快。后面“项目策略”部分的很多建议,都是为了让这个循环转得更快。
C1M1 还按输入类型对应常见结构:房价、广告点击这类表格数据用标准全连接网络;图像用卷积网络;音频、文本这类序列用循环网络或 Transformer;自动驾驶这类多模态输入用定制的混合结构。前者称为结构化数据(每个特征有明确含义),后者称为非结构化数据(像素、音频采样、单词),深度学习最大的突破在非结构化数据上。
感知机(Perceptron)
定义
感知机由 Frank Rosenblatt 于 1957 年提出,是神经网络的起点。它接收多个输入信号 $x_1,x_2,\dots$,每个输入乘以各自的权重 $w_i$,求和后与阈值 $\theta$ 比较,超过阈值就输出 1(称为神经元“被激活”),否则输出 0:
$$ y=\begin{cases}0 & w_1x_1+w_2x_2\le\theta\\ 1 & w_1x_1+w_2x_2>\theta\end{cases} $$
把 $\theta$ 移到左边并记 $b=-\theta$,就得到更常用的形式:
$$ y=\begin{cases}0 & b+w_1x_1+w_2x_2\le 0\\ 1 & b+w_1x_1+w_2x_2>0\end{cases} $$
- 权重 $w_i$ 控制各个输入的重要性:权重越大,对应输入对结果的影响越大。
- 偏置 $b$ 控制神经元被激活的难易程度:$b=-0.1$ 时加权和超过 0.1 就激活;$b=-20$ 时加权和要超过 20 才激活。输入全为 0 时,输出只由 $b$ 决定。
逻辑门
用感知机实现逻辑门,就是找一组 $(w_1,w_2,b)$ 使它满足真值表。
| $x_1$ | $x_2$ | AND | NAND | OR | XOR |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 0 | 0 |
| 1 | 0 | 0 | 1 | 1 | 1 |
| 0 | 1 | 0 | 1 | 1 | 1 |
| 1 | 1 | 1 | 0 | 1 | 0 |
- 与门(AND):$(w_1,w_2,b)=(0.5,0.5,-0.7)$。只有两个输入都是 1 时,加权和 $1.0$ 才超过 $0.7$。满足条件的参数有无穷多组,如 $(0.5,0.5,-0.8)$、$(1.0,1.0,-1.0)$。
- 与非门(NAND):把与门的参数全部取反,$(w_1,w_2,b)=(-0.5,-0.5,0.7)$。
- 或门(OR):$(w_1,w_2,b)=(0.5,0.5,-0.2)$,只要有一个输入为 1,加权和 $0.5$ 就超过 $0.2$。
三个门的结构完全相同,只有参数不同。这正是机器学习的出发点:结构(模型)由人设计,参数应该由计算机从数据(这里是真值表)中自动确定。
1 | import numpy as np |
局限:XOR
异或门(XOR)在两个输入恰好一个为 1 时输出 1。单个感知机无法实现它,原因可以画图看出来。
以或门为例,取 $(b,w_1,w_2)=(-0.5,1.0,1.0)$,感知机在平面上画出直线 $-0.5+x_1+x_2=0$:直线一侧输出 0(只含点 $(0,0)$),另一侧输出 1(含 $(1,0),(0,1),(1,1)$)。单个感知机的决策边界永远是一条直线。
而 XOR 的四个点中,$(0,0),(1,1)$ 输出 0,$(1,0),(0,1)$ 输出 1,两类点在对角线上交错,任何一条直线都分不开。能被一条直线分开的问题称为线性可分,由直线划分的区域称为线性空间;需要曲线才能划分的称为非线性空间。
多层感知机
把门“叠起来”就能绕过这个限制。XOR 可以写成
$$ \mathrm{XOR}(x_1,x_2)=\mathrm{AND}\big(\mathrm{NAND}(x_1,x_2),\ \mathrm{OR}(x_1,x_2)\big). $$
记 $s_1=\mathrm{NAND}(x_1,x_2)$,$s_2=\mathrm{OR}(x_1,x_2)$,逐行验证:
| $x_1$ | $x_2$ | $s_1$ | $s_2$ | $y$ |
|---|---|---|---|---|
| 0 | 0 | 1 | 0 | 0 |
| 1 | 0 | 1 | 1 | 1 |
| 0 | 1 | 1 | 1 | 1 |
| 1 | 1 | 0 | 1 | 0 |
1 | def XOR(x1, x2): |
画成网络:第 0 层是输入 $x_1,x_2$,第 1 层是 $s_1,s_2$,第 2 层是输出 $y$。有权重的层只有两层(0→1、1→2),所以称为 2 层感知机(有的文献按神经元列数称为 3 层)。这种叠加了多层的感知机称为多层感知机(multi-layered perceptron, MLP)。
几何上,第一层把输入空间变换成 $(s_1,s_2)$ 平面,在新平面里四个点变得线性可分,第二层再用一条直线切开。加一层就能表示单层表示不了的东西,这是“深度”最原始的动机。
▸从 NAND 到计算机
只用 NAND 门的组合就能搭出加法器、编码器乃至整台计算机(参见《计算机系统要素:从零开始构建现代计算机》)。既然感知机能实现 NAND,多层感知机理论上就能表示计算机能做的任何处理。理论上 2 层感知机(激活函数为 sigmoid 等非线性函数)已能表示任意函数,但实际搭建时,分模块逐层构造(与门 → 半加器 → 全加器 → ALU → CPU)要自然得多,这与深度网络“逐层组合特征”的思路一致。
从阶跃到平滑
感知机还有一个问题:参数要靠人凑。为了让计算机自动学习参数,需要对激活函数做一处关键修改。
把感知机写成两步:先算加权和 $a=b+w_1x_1+w_2x_2$,再用函数 $h$ 转换为输出 $y=h(a)$。这个 $h$ 称为激活函数(activation function)。感知机用的是阶跃函数:
$$ h(a)=\begin{cases}0 & a\le 0\\ 1 & a>0\end{cases} $$
阶跃函数的导数几乎处处为 0(在 $a=0$ 处不存在)。这意味着微调参数时输出要么不变、要么突然跳变,无法告诉算法“往哪个方向调、调多少”。把它换成平滑的 sigmoid 函数
$$ h(a)=\sigma(a)=\frac{1}{1+e^{-a}} $$
就进入了神经网络的范畴。例如 $\sigma(1.0)=0.731\ldots$,$\sigma(2.0)=0.880\ldots$。
- 相同点:两者都是“输入小则输出接近 0,输入大则输出接近 1”,输出都在 $[0,1]$ 内,而且都是非线性函数。
- 不同点:阶跃函数只输出 0 或 1,像“竹筒敲石”一样只有传/不传两种动作;sigmoid 输出连续实数,像“水车”一样按水量调节输出。正是这种平滑性,使得输出对参数可导,梯度法才能工作。
▸激活函数为什么必须是非线性的
若激活函数是线性的 $h(x)=cx$,三层叠加 $y=h(h(h(x)))=c^{3}x$,等价于一次乘法 $y=ax$($a=c^{3}$),即一个没有隐藏层的网络。更一般地,任意多个仿射变换的复合仍是一个仿射变换,加深层数毫无意义。所以激活函数必须使用非线性函数。
▸衔接
感知机说明了两件事:单层只能画直线,多层才能处理 XOR;阶跃函数不可导,必须换成平滑函数才能自动学习。下一节先做第二件事:只保留一个神经元,把激活换成 sigmoid,并给出自动学习参数的完整方法——这就是逻辑回归。
逻辑回归(Logistic Regression)
定义
逻辑回归(logistic regression)是只有一个 sigmoid 神经元、没有隐藏层的网络,用于二分类 $y\in\{0,1\}$。它输出的不是 0/1,而是“$y=1$ 的概率”:
$$ \hat{y}=\sigma(w^{\top}x+b)=P(y=1\mid x). $$
用前面的记号,它就是 $L=1$、$g=\sigma$ 的 $Z=WA+b$。输入是设计矩阵与标签 $(X,Y)$,要学的是参数 $(w,b)$。
它和感知机的区别只有激活函数:阶跃换成 sigmoid。因此它的决策边界 $w^{\top}x+b=0$ 依然是一条直线(超平面),同样无法处理 XOR;要处理 XOR,必须像多层感知机那样在前面再插一层非线性。
模型
$$ z=w^{\top}x+b,\qquad \hat{y}=\sigma(z)=\frac{1}{1+e^{-z}}. $$
sigmoid 的几个性质在推导中会反复用到:
- $\sigma$ 把任意实数压到 $(0,1)$,所以输出可以解释为概率。
- 对称性:$\sigma(z)+\sigma(-z)=1$。
- 导数可以用函数值自身表示:$\sigma'(z)=\sigma(z)(1-\sigma(z))$。
- $|z|$ 很大时 $\sigma(z)$ 贴近 0 或 1,曲线变平,导数接近 0,称为饱和。饱和会让梯度消失,这是后文需要更好的初始化与归一化的原因之一。
损失函数
由最大似然得到交叉熵
有了模型,需要一个标量来衡量“预测得有多差”,称为损失函数(loss function)。逻辑回归的损失不是拍脑袋定的,而是由最大似然推出来的。
模型认为 $y=1$ 的概率是 $\hat{y}$,$y=0$ 的概率是 $1-\hat{y}$。这两种情况可以合写成一个 Bernoulli 似然:
$$ P(y\mid x)=\hat{y}^{y}(1-\hat{y})^{1-y}. $$
代入 $y=1$ 得 $\hat{y}$,代入 $y=0$ 得 $1-\hat{y}$。好的参数应让观测到的标签概率尽量大。取对数(单调变换,不改变最大值位置,还把乘积变成求和)再取负号,”最大化似然”就变成”最小化损失”,得到二元交叉熵(binary cross-entropy):
$$ \mathcal{L}(\hat{y},y)=-y\log\hat{y}-(1-y)\log(1-\hat{y}). $$
- $y=1$ 时只剩 $-\log\hat{y}$:预测 $\hat{y}$ 越接近 1 损失越小,$\hat{y}\to 0$ 时损失趋于无穷。
- $y=0$ 时只剩 $-\log(1-\hat{y})$:对称地惩罚把负例预测成正例。
- 实现时把 $\hat{y}$ 截断到 $[\varepsilon,1-\varepsilon]$,避免 $\log 0$。
对整个训练集取平均,得到代价函数(cost function):
$$ J(w,b)=\frac{1}{m}\sum_{i=1}^{m}\mathcal{L}\big(\hat{y}^{(i)},y^{(i)}\big). $$
- 除以 $m$ 让损失与样本数无关,换 batch 大小时学习率仍可比较。
- 加正则项时,正则项是否同样除以 $m$,必须与梯度公式保持一致。
- 独立同分布样本的对数似然是 $\sum_i [y^{(i)}\log a^{(i)}+(1-y^{(i)})\log(1-a^{(i)})]$,最大化它等价于最小化 $J$。
- 逻辑回归是判别模型:直接建模 $P(y\mid x)$,不建模 $P(x)$。
两种常用损失:均方误差与交叉熵
一般的神经网络输出向量 $y_k$,标签 $t_k$ 常用 one-hot 表示(正确类为 1,其余为 0)。最常用的两种损失是:
$$ \text{均方误差(MSE)}\quad E=\frac{1}{2}\sum_k (y_k-t_k)^2, \qquad \text{交叉熵}\quad E=-\sum_k t_k\log y_k. $$
由于 $t$ 是 one-hot,交叉熵实际上只看正确类的输出:$E=-\log y_{\text{正确类}}$。
▸例1 两种损失的数值比较(MNIST 十分类)
设正确答案是“2”,即 $t=(0,0,1,0,0,0,0,0,0,0)$。
- 网络输出 $y=(0.1,0.05,\mathbf{0.6},0,0.05,0.1,0,0.1,0,0)$,认为“2”的概率最高(预测正确):
- MSE $=0.0975$;交叉熵 $=-\log 0.6=0.51$。
- 网络输出 $y=(0.1,0.05,0.1,0,0.05,0.1,0,\mathbf{0.6},0,0)$,认为“7”的概率最高(预测错误),“2”只有 0.1:
- MSE $=0.5975$;交叉熵 $=-\log 0.1=2.30$。
两种损失都在预测错误时变大,与直觉一致。实现交叉熵时写成 -np.sum(t * np.log(y + 1e-7)),加一个极小值 $\delta=10^{-7}$ 防止 log(0) 得到 -inf。
▸为何不用 MSE 做分类
若 $\mathcal{L}=(a-y)^{2}/2$ 且 $a=\sigma(z)$,由链式法则
$$
\frac{\partial\mathcal{L}}{\partial z}=\frac{\partial\mathcal{L}}{\partial a}\cdot\frac{\partial a}{\partial z}=(a-y)\cdot a(1-a).
$$
当预测极错时,例如 $y=1$、$z=-4$,则 $a=\sigma(z)\approx 0.018$,故 $a(1-a)\approx 0.018$,总梯度 $(a-y)\cdot a(1-a)\approx -0.017$,几乎学不动。交叉熵在同一点 $\partial\mathcal{L}/\partial z=a-y\approx -0.98$,仍有强信号。另外,MSE 配 sigmoid 输出对参数不是凸的;二元交叉熵对 $(w,b)$ 是凸的。
为什么优化损失而不是准确率
最终关心的是准确率,为什么不直接优化它?因为准确率对参数几乎处处不可导。100 个样本中答对 32 个,准确率是 32%;把某个权重微调一点,答对的个数通常不变,准确率仍是 32%,导数为 0;即使变了也是跳到 33%,是离散的跳变。这和阶跃函数不能用于学习是同一个道理。损失函数则随参数连续变化,微调参数就能看到损失如何变化,梯度才有意义。
同理,预测时把阈值从 0.5 移开会改变准确率,但不改变 $J$;准确率是评估指标,不是训练目标。
Mini-batch 损失
训练集很大时(MNIST 有 6 万张),每一步都在全部数据上算损失太慢。常用做法是每次随机抽一小批(mini-batch),例如 100 个样本,用这一批的平均损失近似整体损失:
1 | batch_mask = np.random.choice(train_size, batch_size) |
这就像用电视收视率抽样估计全体观众。mini-batch 的大小、遍历方式与噪声的影响在“优化”一节详细讨论。
梯度
导数与数值微分
有了损失 $J(w,b)$,下一步是知道“参数往哪边动,损失会下降”,这由导数给出。导数的定义是
$$ \frac{\mathrm{d}f(x)}{\mathrm{d}x}=\lim_{h\to 0}\frac{f(x+h)-f(x)}{h}. $$
直接用很小的 $h$ 近似这个极限,称为数值微分(numerical differentiation)。实现时有两个陷阱:
- 舍入误差:$h$ 不能太小。
np.float32(1e-50)会直接变成0.0,一般取 $h=10^{-4}$。 - 截断误差:前向差分 $(f(x+h)-f(x))/h$ 算的其实是 $x$ 与 $x+h$ 之间割线的斜率,与 $x$ 处切线有偏差。改用中心差分可把误差从 $O(h)$ 降到 $O(h^2)$:
$$ f'(x)\approx\frac{f(x+h)-f(x-h)}{2h}. $$
1 | def numerical_diff(f, x, h=1e-4): |
▸例2 数值微分与解析微分
$f(x)=0.01x^{2}+0.1x$,解析导数 $f'(x)=0.02x+0.1$。
- $x=5$:数值微分得 $0.1999999999990898$,真值 $0.2$;
- $x=10$:数值微分得 $0.2999999999986347$,真值 $0.3$。
误差非常小。数值微分简单可靠,但每个参数都要算两次 $f$,参数一多就太慢;所以训练用解析梯度(反向传播),数值微分只用来检查解析梯度写得对不对(见“梯度检查”)。
偏导数与梯度
有多个参数时,对其中一个求导、其余固定,称为偏导数。把所有偏导数排成向量,就是梯度:
$$ \nabla f=\left(\frac{\partial f}{\partial x_0},\frac{\partial f}{\partial x_1},\dots\right). $$
▸例3 梯度的方向
$f(x_0,x_1)=x_0^{2}+x_1^{2}$,$\nabla f=(2x_0,2x_1)$。
- 在 $(3,4)$:数值偏导为 $6.00000000000378$ 与 $7.999999999999119$,即梯度 $(6,8)$;
- 在 $(0,2)$:梯度 $(0,4)$;在 $(3,0)$:梯度 $(6,0)$。
把各点的负梯度画成箭头,箭头都指向最低点 $(0,0)$,离最低点越远箭头越长。负梯度是函数值在该点下降最快的方向。注意它指向的是局部下降方向,不保证指向全局最小值。
梯度下降
既然负梯度指向下降最快的方向,就沿它走一小步,重复多次。这就是梯度下降(gradient descent):
$$ \theta\leftarrow\theta-\alpha\,\frac{\partial J}{\partial\theta}. $$
$\alpha$ 称为学习率(learning rate),决定每一步走多远。它不是学出来的,需要人工设定,属于超参数。
▸例4 学习率过大或过小
对 $f(x_0,x_1)=x_0^{2}+x_1^{2}$,从 $(-3,4)$ 出发做 100 步梯度下降:
- $\alpha=0.1$:到达 $(-6.1\times 10^{-10},\ 8.1\times 10^{-10})$,几乎就是真正的最小值 $(0,0)$;
- $\alpha=10$:发散到 $(-2.58\times 10^{13},\ -1.29\times 10^{12})$;
- $\alpha=10^{-10}$:几乎不动,停在 $(-2.99999994,\ 3.99999992)$。
实际训练中,$\alpha$ 过大表现为 $J$ 震荡或出现 nan,过小表现为数百步几乎不动。
逻辑回归的解析梯度
对逻辑回归,可以直接用链式法则求出梯度的解析式,不必数值微分。
▸从损失到 $\mathrm{d}z$(输出层误差怎么算)
符号:$z$ 是进入 sigmoid 的一个数(logit);$a=\sigma(z)\in(0,1)$ 是预测概率;$y\in\{0,1\}$ 是标签。反向传播里常把 $\partial\mathcal{L}/\partial z$ 记成 $\mathrm{d}z$,表示“$z$ 该往哪边微调、损失才会降”。
第一步:损失只通过 $a$ 依赖 $z$。单样本二元交叉熵为 $\mathcal{L}=-\big[y\log a+(1-y)\log(1-a)\big]$,且 $a=\sigma(z)$,所以要用链式法则:
$$
\mathrm{d}z=\frac{\partial\mathcal{L}}{\partial z}=\frac{\partial\mathcal{L}}{\partial a}\cdot\frac{\partial a}{\partial z}.
$$
左因子 $\partial\mathcal{L}/\partial a$:损失对概率 $a$ 有多敏感;右因子 $\partial a/\partial z=a(1-a)$:sigmoid 在 $z$ 处的斜率。
第二步:分别求两个因子。
- 对 $a$ 求导(把 $y$ 当常数):$\dfrac{\partial\mathcal{L}}{\partial a}=-\dfrac{y}{a}+\dfrac{1-y}{1-a}$。直觉:$y=1$ 时希望 $a$ 变大,$a$ 偏小时第一项 $-y/a$ 为负、损失偏大;$y=0$ 时希望 $a$ 变小,第二项为正。
- 对 $z$ 求导:$\dfrac{\partial a}{\partial z}=a(1-a)$(sigmoid 导数,见上文激活函数一节)。
第三步:代入并化简(把 $a(1-a)$ 乘进括号,两项分别约分):
$$
\begin{aligned}
\mathrm{d}z&=\left(-\frac{y}{a}+\frac{1-y}{1-a}\right)\cdot a(1-a)\\
&=-y(1-a)+(1-y)a\\
&=-y+ya+a-ya\\
&=a-y.
\end{aligned}
$$
中间 $ya$ 与 $-ya$ 正好抵消,所以 sigmoid 的 $a(1-a)$ 不会留在最终结果里——这是交叉熵与 sigmoid 配对使用时才会出现的化简,不是随便哪个损失都有。
第四步:读一个具体数字。设 $y=1$(正类)、$z=0$,则 $a=\sigma(0)=0.5$,$\mathrm{d}z=a-y=-0.5$。$z$ 增大时 $a$ 增大、损失下降,梯度为负表示“应增大 $z$”(与梯度下降 $z\leftarrow z-\eta\,\mathrm{d}z$ 一致:减去负数等于加上去)。若 $y=0$、$a=0.8$,则 $\mathrm{d}z=0.8$,为正,表示 $z$ 偏大、应减小。
和 MSE 对比:若损失是 $\mathcal{L}=\frac12(a-y)^2$,链式法则给出 $\mathrm{d}z=(a-y)\cdot a(1-a)$,饱和区 $a(1-a)$ 很小,梯度会被压扁(见 callout「为何不用 MSE 做分类」)。交叉熵则直接得到 $\mathrm{d}z=a-y$,不乘 $a(1-a)$。
实现:输出层用 sigmoid + BCE 时,代码里可直接写 dz = a - y(或 sigmoid(z) - y),不必先算 $\partial\mathcal{L}/\partial a$ 再乘 $a(1-a)$。多分类时 softmax + 交叉熵同样得到 $\partial\mathcal{L}/\partial z_j=a_j-y_j$(向量形式仍是「预测减 one-hot 标签」),见后文「softmax 交叉熵的 $\mathrm{d}z$」。
再由 $z=w^{\top}x+b$ 得 $\partial z/\partial w=x$、$\partial z/\partial b=1$,乘上 $\partial\mathcal{L}/\partial z=a-y$,得到单样本梯度:
$$ \frac{\partial\mathcal{L}}{\partial w}=(a-y)x,\qquad \frac{\partial\mathcal{L}}{\partial b}=a-y. $$
含义很直观:预测偏高($a>y$)时,把 $w$ 往 $-x$ 方向推,使下次对同一个 $x$ 的输出变小。
对 $m$ 个样本求平均。循环写法是对每个 $i$ 执行 $\mathrm{d}w \mathrel{+}= (a^{(i)}-y^{(i)})x^{(i)}$,最后除以 $m$。向量化写法令 $A=\sigma(w^{\top}X+b)\in\mathbb{R}^{1\times m}$:
$$ \mathrm{d}w=\frac{1}{m}X(A-Y)^{\top},\qquad \mathrm{d}b=\frac{1}{m}\sum_{i=1}^{m}(A-Y)_{i}. $$
- 形状核对:$X$ 为 $(n_x,m)$,$(A-Y)^{\top}$ 为 $(m,1)$,乘积为 $(n_x,1)$,与 $w$ 同形。
- 误用
X @ (A-Y)而不转置,会因形状不匹配报错或被广播成错误的形状。
最后用梯度下降更新:
$$ w\leftarrow w-\alpha\,\mathrm{d}w,\qquad b\leftarrow b-\alpha\,\mathrm{d}b. $$
在猫分类作业上,$\alpha=0.005$、$2000$ 步是一个能让损失下降的常见起点,但不是普遍最优。
算法
- 预处理:图像
(64, 64, 3)展平成(12288, 1),像素除以 $255$ 缩放到 $[0,1]$,按列拼成 $X$。训练与推理必须使用同一reshape顺序。 - 初始化:$w=0$、$b=0$。逻辑回归只有一个神经元,不存在隐藏单元的对称性问题,零初始化合法。
- 迭代:计算 $A=\sigma(w^{\top}X+b)$;计算 $J$;计算 $\mathrm{d}w,\mathrm{d}b$;更新参数。
- 监控:每隔固定步记录 $J$。若 $J$ 不降,依次检查 shape、学习率,以及标签是否为 $\{0,1\}$ 而非 $\{-1,1\}$。
- 预测:$\hat{y}\ge 0.5$ 判为正类;也可以按假阳性与假阴性的代价调整阈值。准确率不是训练目标:移动阈值会改变准确率,但不改变 $J$。
几点性质:
- 每次迭代的时间为 $O(m n_x)$。
- 逻辑回归的 $J$ 对 $(w,b)$ 是凸的,梯度下降能到达全局最优;一旦加入隐藏层,凸性就消失了。
- 若特征尺度相差几个数量级,$J$ 的等高线会被拉成狭长的山谷,梯度下降来回震荡。因此要做标准化,而且只用训练集的统计量 $\mu,\sigma$,测试集复用同一组 $\mu,\sigma$。
实现
1 | import numpy as np |
▸例5 决策边界
- 二维输入 $x=(x_1,x_2)$ 时,$\hat{y}=0.5$ 等价于 $z=0$,决策边界是直线 $w_1 x_1+w_2 x_2+b=0$。
- 正类线性可分时,训练后法向量 $w$ 指向正类一侧。
- 对异或四点,无论怎么训练,损失都有一个正的下界,四个点无法同时分对。
- 这就是引入隐藏层的动机。
▸衔接
逻辑回归给出了“模型 → 损失 → 梯度 → 更新”的完整训练闭环,以及输出层误差 $A-Y$。但它的边界仍是直线。下一节在输入与输出之间插入一层带非线性激活的隐藏层,让边界可以弯曲——相当于把多层感知机的结构和逻辑回归的学习方法合在一起。
浅层网络(Shallow Neural Network)
结构
浅层网络指一层隐藏层加一层输出层,即 $L=2$。隐藏层的神经元从输入中提取新的特征,输出层再在这些特征上做逻辑回归。隐藏层常用 tanh 或 ReLU,输出层二分类用 sigmoid、多分类用 softmax。
层数的数法:输入层、隐藏层、输出层共三列神经元,但只有两层带权重,所以称为“2 层网络”(鱼书同样按带权重的层数计)。
前向
$$ \begin{aligned} Z^{[1]} &= W^{[1]}X + b^{[1]}, & A^{[1]} &= g^{[1]}(Z^{[1]}),\\ Z^{[2]} &= W^{[2]}A^{[1]} + b^{[2]}, & A^{[2]} &= g^{[2]}(Z^{[2]}). \end{aligned} $$
各量形状:
- $W^{[1]}$:$(n^{[1]}, n_x)$
- $A^{[1]}$:$(n^{[1]}, m)$
- $W^{[2]}$:$(n_y, n^{[1]})$
- $A^{[2]}$:$(n_y, m)$
每一层都是“矩阵乘 + 加偏置 + 激活”,用 np.dot 一次算完一层所有神经元。不用矩阵乘法就得为每个神经元写一个循环,所以向量化在实现层面非常关键。
▸例6 一个 3 层网络的前向计算(鱼书 3.4 节)
网络为 2 → 3 → 2 → 2,隐藏层用 sigmoid,输出层用恒等函数。鱼书使用行样本约定($a=xW+b$):
- 输入 $x=(1.0,\ 0.5)$;
- $W^{(1)}=\begin{pmatrix}0.1&0.3&0.5\\0.2&0.4&0.6\end{pmatrix}$,$b^{(1)}=(0.1,0.2,0.3)$;
- $W^{(2)}=\begin{pmatrix}0.1&0.4\\0.2&0.5\\0.3&0.6\end{pmatrix}$,$b^{(2)}=(0.1,0.2)$;
- $W^{(3)}=\begin{pmatrix}0.1&0.3\\0.2&0.4\end{pmatrix}$,$b^{(3)}=(0.1,0.2)$。
逐层计算:
- 第 1 层加权和 $a^{(1)}=xW^{(1)}+b^{(1)}=(0.3,\ 0.7,\ 1.1)$,例如第一个分量 $1.0\times 0.1+0.5\times 0.2+0.1=0.3$;激活 $z^{(1)}=\sigma(a^{(1)})=(0.574,\ 0.668,\ 0.750)$;
- 第 2 层 $a^{(2)}=(0.516,\ 1.214)$,$z^{(2)}=(0.626,\ 0.771)$;
- 输出 $y=z^{(2)}W^{(3)}+b^{(3)}=(0.3168,\ 0.6963)$。
形状链为 $(2,)\times(2,3)\to(3,)\times(3,2)\to(2,)\times(2,2)\to(2,)$,每一步“相邻维度一致”。
激活函数
隐藏层的激活函数决定了网络能表示什么样的非线性。常用的选择如下,每个都给出公式、导数、用途与缺点。
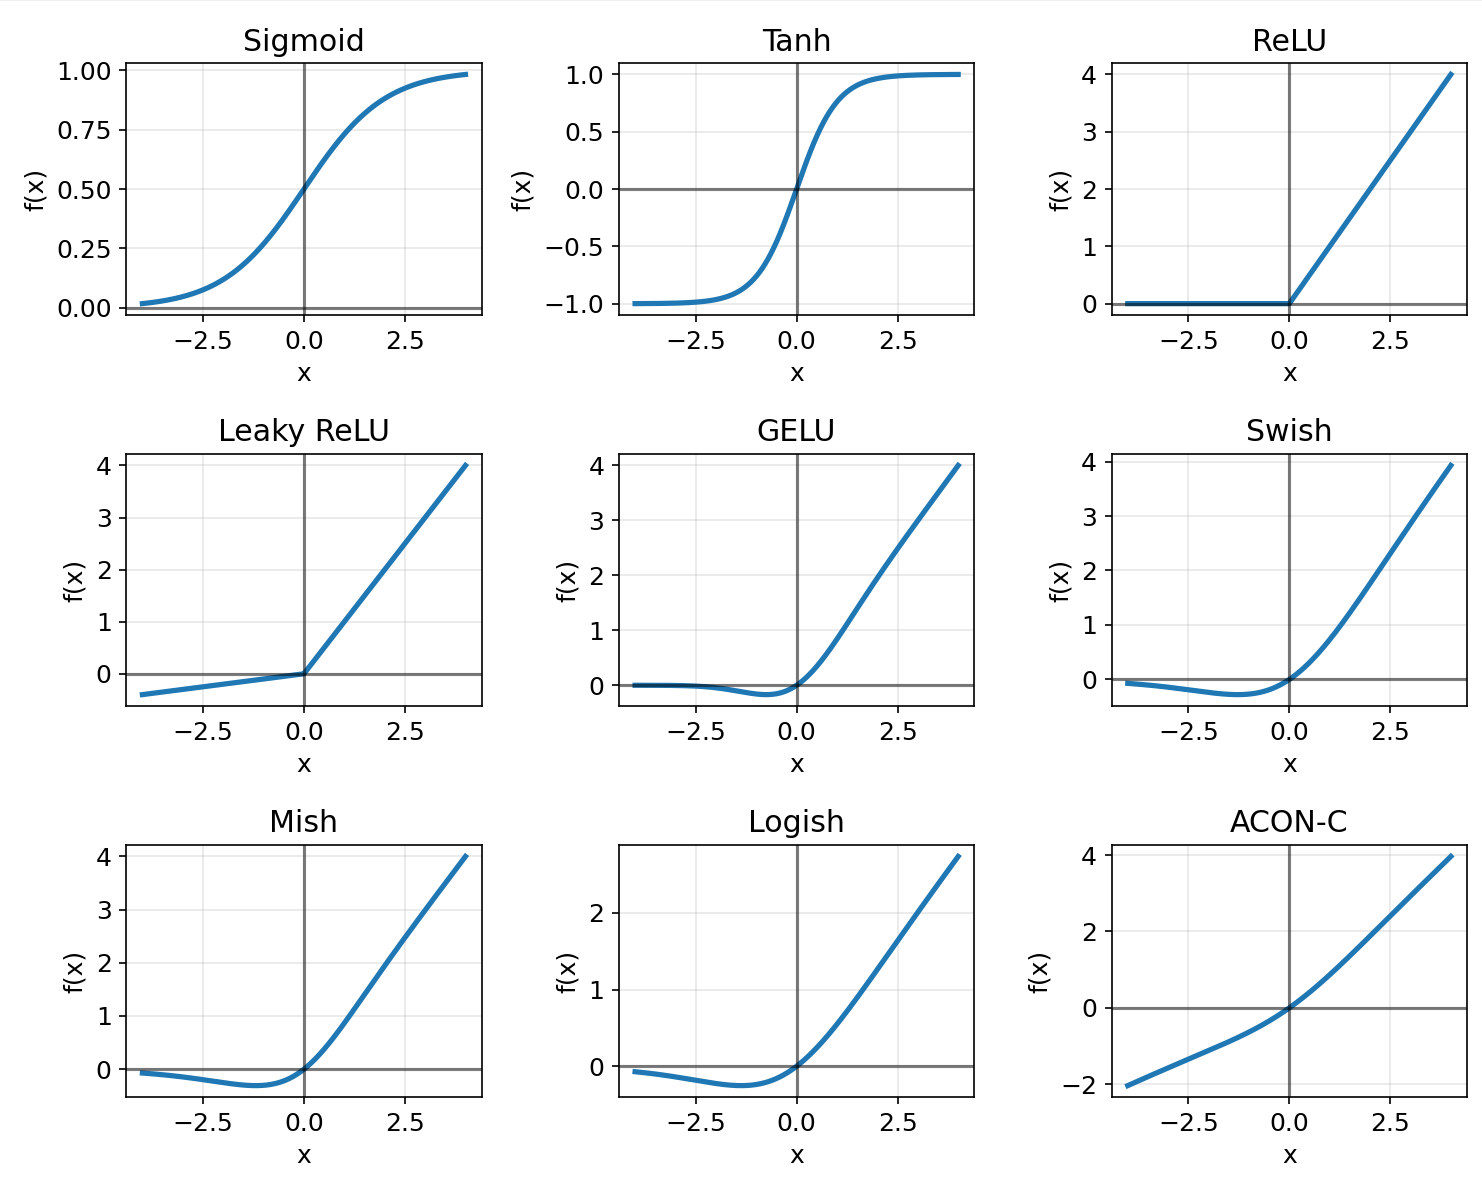
▸激活函数
sigmoid(logistic function,逻辑函数)
$$ g(z)=\frac{1}{1+e^{-z}},\qquad g'(z)=g(z)\big(1-g(z)\big). $$
用途:值域 $(0,1)$,二分类输出直接当概率。缺点:$|z|$ 大时导数接近 $0$(最大值也只有 $0.25$),多层连乘后梯度消失;输出不以 $0$ 为中心,下一层输入整体偏正。
tanh(hyperbolic tangent,双曲正切)
$$ g(z)=\tanh z=\frac{e^{z}-e^{-z}}{e^{z}+e^{-z}},\qquad g'(z)=1-\tanh^{2}z. $$
用途:值域 $(-1,1)$ 且零中心,浅层隐藏层和 RNN 中比 sigmoid 好训。缺点:$|z|$ 大时同样饱和,深层仍会梯度消失。
ReLU(rectified linear unit,整流线性单元)
$$ g(z)=\max(0,z),\qquad g'(z)=\begin{cases} 0 & z<0 \\ 1 & z>0 \end{cases}. $$
用途:正半轴导数恒为 $1$,不饱和,计算只是一次比较,所以是卷积网络隐藏层的默认选择。缺点:负半轴导数恒为 $0$,单元若一直停在负区就不再更新,称为死亡 ReLU(dying ReLU)。$z=0$ 处导数不唯一,实现里通常把 $z\le 0$ 的导数写成 $0$。
Leaky ReLU(leaky rectified linear unit,渗漏整流线性)
$$ g(z)=\max(\alpha z, z),\qquad g'(z)=\begin{cases} \alpha & z<0 \\ 1 & z>0 \end{cases},\quad \alpha=0.01. $$
用途:负半轴仍有梯度,避免永久死亡。缺点:$\alpha$ 很小,形状仍接近 ReLU,负信号几乎传不远。
ELU(exponential linear unit,指数线性单元)
$$ g(z)=\begin{cases} z & z>0 \\ a(e^{z}-1) & z\le 0 \end{cases},\qquad g'(z)=\begin{cases} 1 & z>0 \\ g(z)+a & z\le 0 \end{cases}. $$
常取 $a=1$。用途:负值平滑,激活均值更靠近 $0$,比固定小斜率更容易把单元拉回零附近;处处可导($a=1$ 时)。缺点:负半轴多一次指数,比 ReLU 贵。
GELU(Gaussian error linear unit,高斯误差线性单元)
$$ g(z)=z\,\Phi(z),\qquad g'(z)=\Phi(z)+z\,\phi(z). $$
$\Phi$ 是标准正态累积分布,$\phi$ 是其密度。用途:负半轴按概率缩小输入,而不是硬截成 $0$,不会死亡;Transformer 与语言模型的隐藏层常用它。缺点:要比 ReLU 多算 $\Phi$。实现里常用 $z\,\sigma(1.702z)$ 近似。
hard tanh(hard hyperbolic tangent,硬双曲正切)
$$ g(z)=\begin{cases} -1 & z<-1 \\ z & -1\le z\le 1 \\ 1 & z>1 \end{cases},\qquad g'(z)=\begin{cases} 1 & |z|<1 \\ 0 & |z|>1 \end{cases}. $$
用途:CS224n 把它当作 tanh 的便宜替代,区间内就是恒等,没有指数。缺点:区间外饱和,导数为 $0$,和 tanh 一样会消失。
softsign(软符号)
$$ g(z)=\frac{z}{1+|z|},\qquad g'(z)=\frac{1}{(1+|z|)^{2}}. $$
用途:值域 $(-1,1)$,零中心,导数恒正;尾部按多项式衰减,比 tanh 更晚贴到 $\pm 1$,比 tanh 少一次指数。缺点:仍会在远处变平,深层一样会饱和;比 hard tanh 多一次除法。
Softplus(软加)
$$ g(z)=\log(1+e^{z}),\qquad g'(z)=\frac{e^{z}}{1+e^{z}}=\sigma(z). $$
用途:ReLU 的光滑版本,值域 $(0,\infty)$,常用来输出必须为正的量(方差、尺度参数)。缺点:负半轴导数 $\sigma(z)$ 也趋于 $0$;做隐藏层激活时一般不比 ReLU 好。
PReLU(parametric ReLU,参数化 ReLU)
$$ g(z)=\max(\alpha z,z),\qquad \frac{\partial g}{\partial z}=\begin{cases}\alpha & z<0\\ 1 & z>0\end{cases},\qquad \frac{\partial g}{\partial \alpha}=\begin{cases} z & z<0\\ 0 & z>0\end{cases}. $$
与 Leaky ReLU 形状相同,但 $\alpha$ 是可学习参数(通常每个通道一个),由反向传播决定负半轴斜率。He 初始化的论文(He et al., 2015)就是用 PReLU 在 ImageNet 上首次超过人类水平。缺点:多了参数,小数据上可能过拟合。
SELU(scaled ELU,缩放指数线性单元)
$$ g(z)=\lambda\begin{cases} z & z>0\\ a(e^{z}-1) & z\le 0\end{cases},\qquad \lambda\approx1.0507,\ a\approx1.6733. $$
两个常数是解出来的:在 LeCun 初始化($\mathrm{Var}(w)=1/n_{\mathrm{in}}$)下,若输入均值 $0$、方差 $1$,输出的均值、方差仍为 $0$、$1$,称为自归一化(self-normalizing)。用途:不加 BatchNorm 的深层全连接网络。缺点:只对全连接、特定初始化、配合 AlphaDropout 时成立,卷积与残差网络中优势不明显。
SiLU / Swish(sigmoid-weighted linear unit)
$$ g(z)=z\,\sigma(z),\qquad g'(z)=\sigma(z)+z\,\sigma(z)\big(1-\sigma(z)\big)=\sigma(z)\big(1+z(1-\sigma(z))\big). $$
形状与 GELU 几乎重合(GELU 的近似式 $z\,\sigma(1.702z)$ 就是 Swish 加了一个系数)。光滑、非单调:在 $z\approx-1.28$ 处有最小值约 $-0.28$,负半轴先降后回到 $0$。EfficientNet、YOLO 系列与很多大语言模型使用它。
GLU 系列(gated linear unit,门控线性单元)
$$ \mathrm{GLU}(x)=(xW+b)\odot\sigma(xV+c),\qquad \mathrm{SwiGLU}(x)=\mathrm{SiLU}(xW)\odot(xV). $$
它不是逐元素函数,而是两路线性投影相乘:一路给内容,一路当门,思路与 LSTM 的门相同。LLaMA 等模型的 FFN 用 SwiGLU 代替 ReLU。为了保持参数量不变,隐藏宽度常从 $4d$ 改成约 $\frac{8}{3}d$(三个矩阵 $W,V,W_2$ 而不是两个)。
选择:隐藏层默认 ReLU;需要光滑负值时用 GELU 或 ELU。输出层按任务:回归用恒等函数,二分类用 sigmoid,多分类用 softmax,不把 ReLU 放在概率输出上。
▸ReLU 为什么成为默认
ReLU 由 Nair & Hinton (2010) 提出,AlexNet 之后卷积网络的隐藏层基本都用它。原因在于导数:sigmoid 的导数最大只有 $0.25$,tanh 在 $|z|$ 稍大时导数也只有 $0.1$ 左右,十层乘下来梯度接近 0;ReLU 在正半轴导数恒为 1,梯度可以原样穿过很多层。代价是负半轴梯度为 0,神经元可能“死掉”,Leaky ReLU 给负半轴一个很小的斜率来缓解。
▸例7 反向传播中如何计算激活函数的导数
前向已经得到 $a=g(z)$。反向时直接用下面的式子,多数情况下能复用前向结果,不必重新计算:
- sigmoid:$g'(z)=a(1-a)$
- tanh:$g'(z)=1-a^{2}$
- ReLU:$z>0$ 时为 $1$,否则为 $0$
- Leaky ReLU:$z>0$ 时为 $1$,否则为 $\alpha$
- ELU:$z>0$ 时为 $1$,否则为 $g(z)+a$
- GELU:$g'(z)=\Phi(z)+z\,\phi(z)$
- hard tanh:$|z|<1$ 时为 $1$,否则为 $0$
- softsign:$g'(z)=1/(1+|z|)^{2}$
sigmoid 与 tanh 在远离 $0$ 时导数接近 $0$,多层连乘后梯度消失;ReLU、Leaky ReLU、ELU 在正半轴导数为 $1$。所以隐藏层用后者,输出层才用 sigmoid 或 softmax。
NumPy 实现:每个激活写成“前向 + 导数”一对,反向时 dZ = dA * g_prime(Z, A)。
1 | import numpy as np |
PyTorch 用 autograd 核对上面的导数:对 g(z).sum() 求反向,z.grad 就是逐点的 $g'(z)$。
1 | import torch |
ReLU 在 $z=0$ 处 PyTorch 取导数 $0$,与上面 z > 0 的写法一致;网格若恰好落在 $0$ 上,换别的约定就会对不上。
导数推导
上面的导数都可以一步步推出来,推导本身也说明了“为什么能复用前向结果”。
sigmoid。把 $\sigma(z)=(1+e^{-z})^{-1}$ 看成复合函数,用链式法则:
$$ \sigma'(z)=-(1+e^{-z})^{-2}\cdot(-e^{-z}) =\frac{1}{1+e^{-z}}\cdot\frac{e^{-z}}{1+e^{-z}} =\sigma(z)\cdot\big(1-\sigma(z)\big). $$
最后一步用了 $\frac{e^{-z}}{1+e^{-z}}=1-\frac{1}{1+e^{-z}}$。$\sigma(1-\sigma)$ 在 $\sigma=\frac12$(即 $z=0$)时取最大值 $\frac14$,这个 $\frac14$ 是后面梯度消失估计的关键数字。
tanh。用商的求导法则,记 $u=e^{z}-e^{-z}$、$w=e^{z}+e^{-z}$,则 $u'=w$、$w'=u$:
$$ \tanh'(z)=\frac{u'w-uw'}{w^{2}}=\frac{w^{2}-u^{2}}{w^{2}}=1-\tanh^{2}z. $$
$z=0$ 时导数为 $1$,比 sigmoid 的 $\frac14$ 大 4 倍。tanh 其实就是平移、缩放过的 sigmoid:
$$ \tanh z=\frac{1-e^{-2z}}{1+e^{-2z}}=\frac{2}{1+e^{-2z}}-1=2\sigma(2z)-1. $$
所以二者表达能力相同,区别只在“是否零中心”和“$0$ 附近的斜率”。
Softplus 与 SiLU。$\frac{\mathrm d}{\mathrm dz}\log(1+e^{z})=\frac{e^{z}}{1+e^{z}}=\sigma(z)$:Softplus 的导数正好是 sigmoid,sigmoid 的积分就是 Softplus。SiLU 是乘积 $z\cdot\sigma(z)$,用乘积法则得 $\sigma(z)+z\sigma'(z)=\sigma(z)+z\sigma(z)(1-\sigma(z))$。
GELU。$g(z)=z\Phi(z)$,乘积法则加上 $\Phi'=\phi$,得 $g'(z)=\Phi(z)+z\phi(z)$,其中 $\phi(z)=\frac{1}{\sqrt{2\pi}}e^{-z^{2}/2}$。
ReLU 在 0 处。$\max(0,z)$ 在 $z=0$ 处不可导,但左右导数 $0$ 和 $1$ 之间的任何值都是次梯度(subgradient)。实际训练中 $z$ 恰好等于 $0$ 的概率几乎为零,取 $0$ 或 $1$ 都不影响结果。
为什么零中心重要
考虑下一层的一个神经元 $z=\sum_i w_i a_i+b$,它的权重梯度是
$$ \frac{\partial L}{\partial w_i}=\frac{\partial L}{\partial z}\cdot a_i. $$
若上一层用 sigmoid,所有 $a_i>0$,那么同一个样本给出的所有 $\partial L/\partial w_i$ 都与 $\partial L/\partial z$ 同号:这一步要么所有 $w_i$ 一起变大,要么一起变小。若最优方向是“$w_1$ 增大、$w_2$ 减小”,就只能交替走“全增”“全减”两种方向,路径呈之字形,收敛变慢。tanh 的输出有正有负,没有这个限制。这也是数据预处理要减均值、BatchNorm 要把预激活拉回零均值的原因之一。mini-batch 平均会把这个问题冲淡一些,但不能消除。
梯度消失的定量估计
反向传播时,每经过一层,梯度都乘一次 $g'(z)$(还有权重矩阵)。只看激活函数这一项:
| 激活 | $g'$ 的最大值 | 10 层连乘的上界 |
|---|---|---|
| sigmoid | $1/4$ | $(1/4)^{10}\approx 9.5\times10^{-7}$ |
| tanh | $1$(仅在 $z=0$) | 实际 $\lvert z\rvert$ 稍大就远小于 $1$ |
| ReLU | $1$($z>0$ 时恒为 $1$) | 激活路径上不衰减 |
sigmoid 即使在最理想的位置,10 层也让梯度缩小约一百万倍:前几层几乎学不动。ReLU 在激活的位置导数恰好为 $1$,梯度大小只由权重决定,这时配合 He 初始化让权重项的连乘也保持在 $1$ 附近,深层网络才训得动。
死亡 ReLU
ReLU 单元若对所有训练样本都有 $z\le 0$,它的输出恒为 $0$、梯度恒为 $0$,权重再也不会更新,这个单元就“死”了。常见原因:
- 学习率过大:一次大更新把偏置推到很负的位置;
- 偏置初始化为较大的负数;
- 输入没有归一化,某些方向尺度极大。
诊断方法是统计每个隐藏单元在一个 batch 上的激活率:
1 | def dead_relu_fraction(Z): |
比例超过 10% 到 20% 时,可以减小学习率、改用 Leaky ReLU / GELU,或把偏置初始化为小的正数(如 $0.01$)。
对比与选择
| 激活 | 值域 | 零中心 | 饱和 | 会死亡 | 计算 | 常见位置 |
|---|---|---|---|---|---|---|
| sigmoid | $(0,1)$ | 否 | 两侧 | 否 | 指数 | 二分类输出、门 |
| tanh | $(-1,1)$ | 是 | 两侧 | 否 | 指数 | RNN 隐状态、候选值 |
| ReLU | $[0,\infty)$ | 否 | 负侧梯度为 0 | 会 | 比较 | CNN 隐藏层 |
| Leaky / PReLU | $\mathbb{R}$ | 近似 | 否 | 否 | 比较 | 担心死亡时 |
| ELU / SELU | $(-a,\infty)$ | 近似 | 负侧缓饱和 | 否 | 负侧指数 | 无 BN 的全连接 |
| GELU / SiLU | 约 $(-0.17,\infty)$ / $(-0.28,\infty)$ | 近似 | 否 | 否 | 指数或误差函数 | Transformer、现代 CNN |
| softmax | 单纯形 | 否 | 是 | 否 | 指数 | 多分类输出 |
选择的原则:
【是否(0,1), 是否需要加和=1,是分类还是回归,,是否门控,负值分布情况。】
- 输出层由任务决定,并且和损失函数配对(见下面的“损失函数的选择”):回归用恒等,二分类和多标签用 sigmoid,单标签多分类用 softmax,必须为正的量用 Softplus 或 $\exp$。
- 输出层的值域要和目标的值域一致:房价可正可负、没有上下界,用恒等;“是不是猫”是一个概率,要落在 $(0,1)$,用 sigmoid;“是猫、狗、鸟中的哪一个”要求几个概率加起来等于 1,用 softmax。
- 多标签(一张图可以同时有猫和狗)不是多分类:每个标签各自是一个是/否问题,所以每个输出单独用 sigmoid,而不是整体 softmax。
- 配对的损失:恒等配 MSE,sigmoid 配二元交叉熵,softmax 配交叉熵。这样配对时,输出层的梯度会化简成 $\hat y - y$,既好算又不会因为饱和而消失。
- 方差、价格、计数这类必须为正的量,用 Softplus $\log(1+e^z)$ 或 $\exp(z)$ 把任意实数映射到正数。
- 隐藏层先用 ReLU,配 He 初始化。出现大量死亡单元时换 Leaky ReLU;做 Transformer 或追求最后一点精度时用 GELU / SiLU;FFN 可以用 SwiGLU。
- ReLU 计算便宜,正半轴梯度恒为 1,深层网络中梯度不容易衰减,所以作为默认选项。
- “死亡单元”指某个神经元的输入总是负数,输出恒为 0、梯度也恒为 0,再也学不动。学习率过大或初始化不当时容易出现。Leaky ReLU 在负半轴留一个小斜率(如 0.01),让梯度还能流过。
- GELU / SiLU 是 ReLU 的平滑版本,在 0 附近没有折角,大模型里通常稍好一点,代价是计算略贵。BERT、GPT 用 GELU。
- SwiGLU 是带门控的变体:一路做 SiLU,另一路做线性变换,两路逐元素相乘。LLaMA 等模型的前馈层(FFN)使用它。
- 门控结构保留 sigmoid 和 tanh:LSTM / GRU 的门需要 $(0,1)$ 之间的“开关比例”,只能用 sigmoid;候选值需要有正有负,用 tanh。这里的饱和反而是想要的:门要么开、要么关。
- 门的作用是决定“保留多少旧记忆、写入多少新信息”,这是一个 0 到 1 之间的比例,所以用 sigmoid。ReLU 没有上界,不能当比例。
- 候选值是要写进记忆的新内容,可能需要增加也可能需要减少,所以用值域为 $(-1,1)$ 的 tanh,而且有界,不会让记忆数值越滚越大。
- 在隐藏层里,饱和意味着梯度消失,是缺点;在门里,输出接近 0 或 1 正好表示“完全关”或“完全开”,是想要的行为。
- 激活与初始化要成对:ReLU 系列配 He($\mathrm{Var}=2/n_{\mathrm{in}}$),tanh / sigmoid 配 Xavier,SELU 配 LeCun($1/n_{\mathrm{in}}$)。
- 初始化的目标是让每一层输出的方差大致不变,信号既不逐层放大,也不逐层缩小到 0。
- ReLU 把负半边全部置 0,大约丢掉一半方差,所以 He 初始化把方差设为 $2/n_{\mathrm{in}}$,用多出来的一倍补回来。
- tanh 和 sigmoid 在 0 附近近似线性、两边对称,不需要这个补偿,用 Xavier($1/n_{\mathrm{in}}$ 或 $2/(n_{\mathrm{in}}+n_{\mathrm{out}})$)。
- SELU 的自归一化性质是在 LeCun 初始化下推出来的,换成别的初始化,这个性质就不成立了。
- 配错不一定立刻报错,但深层网络会出现 loss 不降、梯度为 0 或变成 NaN。具体推导见后文“初始化”一节。
- 换激活函数通常只带来很小的提升,排在数据、架构、学习率之后再调。
- 调参的优先级:先保证数据质量和数据量,再选合适的网络结构,再调学习率;这些都定了之后,换激活函数一般只带来不到 1 个百分点的变化。
- 训练不收敛时,原因通常在学习率、初始化或数据,不在激活函数。
补充的几种激活的 NumPy 实现,并用 PyTorch 核对导数:
1 | SELU_L, SELU_A = 1.0507009873554805, 1.6732632423543772 |
SELU 的导数在 $z\le0$ 处可以复用前向结果:$g=\lambda a(e^{z}-1)$,所以 $g'=\lambda a e^{z}=g+\lambda a$,代码里的 a + SELU_L * SELU_A 就是这个式子(a 是前向输出,SELU_A 是常数 $a$)。
隐藏层的作用
- 非线性不可省略。若 $g^{[1]}$ 为恒等函数,则
$$ A^{[2]}=g^{[2]}\big(W^{[2]}W^{[1]}X + W^{[2]}b^{[1]}+b^{[2]}\big), $$
记 $W'=W^{[2]}W^{[1]}$、$b'=W^{[2]}b^{[1]}+b^{[2]}$,就退化成单层的 $g^{[2]}(W'X+b')$,决策边界仍是直线。异或四个点需要把空间“折叠”,隐藏层的响应必须是弯曲的。
- 通用逼近(universal approximation)
- 足够宽的单隐藏层网络可以以任意精度逼近紧集上的连续函数;
- 但所需宽度可能是指数级的;
- 定理只说明这样的参数存在,不保证训练能找到它;
- 深度用“组合”的方式复用特征,常常比单纯加宽更省参数。
- 参数量:$n^{[1]}(n_x+1)+n_y(n^{[1]}+1)$(每个神经元有若干权重和一个偏置)。
- 平面分类作业常用 $n_x=2$、$n^{[1]}=4$、$n_y=1$,共 $4\times 3+1\times 5=17$ 个参数;
- 隐藏单元太少:拼不出弯曲的边界;
- 隐藏单元太多而数据只有几百点:过拟合。
输出层
输出层的激活函数由任务决定:回归(预测连续值,如由照片预测体重 57.4 kg)用恒等函数,直接输出;二分类用 sigmoid;多分类用 softmax。输出层的神经元个数一般等于类别数,例如手写数字 0–9 有 10 个输出神经元。
softmax
$K$ 类分类时,输出层先算出 $K$ 个分数 $z_1,\dots,z_K$,softmax 把它们变成概率:
$$ a_k=\frac{e^{z_k}}{\sum_{j=1}^{K}e^{z_j}}. $$
分子是第 $k$ 个分数的指数,分母是所有指数之和,所以每个输出都受所有输入影响。
- 输出可当概率:每个 $a_k\in(0,1)$,且 $\sum_k a_k=1$。例如 $z=(0.3,2.9,4.0)$ 时 $a=(0.018,\ 0.245,\ 0.737)$,可以说“有 74% 的概率是第 2 类,25% 的概率是第 1 类,1% 的概率是第 0 类”。
- 不改变大小顺序:指数函数单调递增,所以 $\arg\max_k a_k=\arg\max_k z_k$。推理时只需取最大分数对应的类别,softmax 可以省略以节省计算;训练时需要它,是因为损失函数要用到概率。
- 二分类时,softmax 退化为 sigmoid:$\frac{e^{z_1}}{e^{z_1}+e^{z_0}}=\sigma(z_1-z_0)$。
溢出问题
指数增长极快:$e^{10}>20000$,$e^{100}$ 后面有 40 多个 0,$e^{1000}$ 直接返回 inf,两个 inf 相除得到 nan。解决办法是分子分母同乘一个常数 $C$:
$$ a_k=\frac{Ce^{z_k}}{C\sum_j e^{z_j}}=\frac{e^{z_k+\log C}}{\sum_j e^{z_j+\log C}}=\frac{e^{z_k-c}}{\sum_j e^{z_j-c}}. $$
即所有分数同时减去同一个常数,结果不变。取 $c=\max_j z_j$,最大的指数变成 $e^{0}=1$,其余都小于 1,不会溢出。
▸例8 softmax 的溢出与修正
1
2
3
4a = np.array([1010, 1000, 990])
np.exp(a) / np.sum(np.exp(a)) # array([nan, nan, nan])
c = np.max(a) # 1010
np.exp(a - c) / np.sum(np.exp(a - c)) # array([9.9995e-01, 4.5398e-05, 2.0611e-09])
损失函数的选择
▸一条主线
几乎所有常用损失都是负对数似然:先假设“给定 $x$ 时 $y$ 服从什么分布”,输出层给出这个分布的参数,损失就是 $-\log p(y\mid x)$。假设高斯得到 MSE,假设拉普拉斯得到 MAE,假设伯努利得到二元交叉熵,假设类别分布得到交叉熵。输出激活与损失因此成对出现,配对正确时 $\partial L/\partial z$ 都化简成“预测减标签”。
总表
| 任务 | 假设的分布 | 输出激活 | 损失 | $\partial L/\partial z$ | PyTorch |
|---|---|---|---|---|---|
| 回归 | 高斯 | 恒等 | MSE $\frac12(\hat y-y)^2$ | $\hat y-y$ | MSELoss |
| 回归,有离群点 | 拉普拉斯 | 恒等 | MAE $\lvert\hat y-y\rvert$ | $\mathrm{sign}(\hat y-y)$ | L1Loss |
| 回归,折中 | 高斯与拉普拉斯的拼接 | 恒等 | Huber | 截断的 $\hat y-y$ | HuberLoss、SmoothL1Loss |
| 二分类 | 伯努利 | sigmoid | BCE | $a-y$ | BCEWithLogitsLoss |
| 多标签 | 每类独立伯努利 | 每维 sigmoid | 各维 BCE 之和 | $a_k-y_k$ | BCEWithLogitsLoss |
| 单标签多分类 | 类别分布 | softmax | 交叉熵 | $a_k-t_k$ | CrossEntropyLoss |
| 计数 | 泊松 | $\exp$ | $\hat y-y\log\hat y$ | $\hat y-y$ | PoissonNLLLoss |
最后一列的 PyTorch 损失都直接接收 logits(激活之前的 $z$),自己在内部做 sigmoid / softmax。在模型里再加一层 Sigmoid 或 Softmax 是最常见的错误之一:激活被做了两次,梯度变小,训练变慢但不报错。
回归:MSE、MAE 与 Huber
由似然推 MSE。假设 $y=\hat y+\varepsilon$,$\varepsilon\sim\mathcal N(0,\sigma^2)$,则
$$ -\log p(y\mid x)=-\log\Big(\frac{1}{\sqrt{2\pi}\sigma}e^{-(y-\hat y)^2/(2\sigma^2)}\Big) =\frac{(y-\hat y)^2}{2\sigma^2}+\log(\sqrt{2\pi}\sigma). $$
$\sigma$ 固定时,第二项是常数,第一项正比于平方误差。所以最小化 MSE 就是在高斯噪声假设下做最大似然。同理,拉普拉斯噪声 $p(\varepsilon)\propto e^{-\lvert\varepsilon\rvert/b}$ 给出 MAE。
两者预测的是不同的量。对一组观测 $y_1,\dots,y_n$ 只用一个常数 $c$ 去拟合:
- MSE:$\frac{\mathrm d}{\mathrm dc}\sum_i\frac12(c-y_i)^2=\sum_i(c-y_i)=0$,得 $c=\bar y$,均值;
- MAE:$\frac{\mathrm d}{\mathrm dc}\sum_i\lvert c-y_i\rvert=\#\{y_i
▸离群点对 MSE 与 MAE 的影响
房价数据 $\{1,2,3,4,100\}$(单位:百万),最后一个是录入错误。MSE 的最优常数是均值 $22$,被一个错误值拉得远离其他所有点;MAE 的最优常数是中位数 $3$,几乎不受影响。从梯度看:MSE 对这个点的梯度是 $\hat y-y$,误差 $97$ 就给出 $97$ 倍的推力;MAE 的梯度只有 $\pm1$,离群点和普通点的发言权一样大。
Huber 损失把两者拼在一起:误差小时用平方($0$ 附近光滑,梯度随误差减小,便于精确收敛),误差大时用绝对值(梯度有界,不被离群点带跑):
$$ L_\delta(r)=\begin{cases}\frac12 r^2, & \lvert r\rvert\le\delta,\\ \delta\big(\lvert r\rvert-\frac12\delta\big), & \lvert r\rvert>\delta,\end{cases} \qquad L_\delta'(r)=\begin{cases} r, & \lvert r\rvert\le\delta,\\ \delta\,\mathrm{sign}(r), & \lvert r\rvert>\delta,\end{cases} $$
其中 $r=\hat y-y$。在 $\lvert r\rvert=\delta$ 处两段的值和导数都连续:$\frac12\delta^2=\delta(\delta-\frac12\delta)$,导数都是 $\delta$。它的梯度就是“裁剪到 $[-\delta,\delta]$ 的 MSE 梯度”。DQN 的 TD 误差和检测网络的边框回归都用它。SmoothL1Loss(beta) 等于 HuberLoss(delta=beta) 再除以 beta,二者在 $\delta=1$ 时相同。
| MSE | MAE | Huber | |
|---|---|---|---|
| 最优常数 | 均值 | 中位数 | 介于两者之间 |
| 梯度大小 | 正比于误差 | 恒为 $1$ | 小误差正比,大误差恒为 $\delta$ |
| 对离群点 | 敏感 | 稳健 | 稳健 |
| $0$ 处 | 光滑 | 不可导,梯度不变小,在最优点附近震荡 | 光滑 |
分类:交叉熵家族
二元交叉熵的梯度。由链式法则,
$$ \frac{\partial L}{\partial a}=-\frac{y}{a}+\frac{1-y}{1-a}=\frac{a-y}{a(1-a)},\qquad \frac{\partial L}{\partial z}=\frac{\partial L}{\partial a}\cdot\sigma'(z)=\frac{a-y}{a(1-a)}\cdot a(1-a)=a-y. $$
sigmoid 的导数 $a(1-a)$ 恰好被消掉。这正是“为何不用 MSE 做分类”的另一面:MSE 配 sigmoid 时,这个 $a(1-a)$ 留在梯度里,饱和区梯度消失。
数值稳定的写法。直接算 $\log\sigma(z)$,在 $z=-800$ 时 $\sigma(z)$ 下溢为 $0$,得到 $\log 0=-\infty$。把损失用 $z$ 重写:利用 $\log\sigma(z)=-\log(1+e^{-z})$、$\log(1-\sigma(z))=-z-\log(1+e^{-z})$,
$$ L=-y\log\sigma(z)-(1-y)\log(1-\sigma(z))=\log(1+e^{z})-yz=\max(z,0)-yz+\log\big(1+e^{-\lvert z\rvert}\big). $$
最后一步用了 $\log(1+e^{z})=\max(z,0)+\log(1+e^{-\lvert z\rvert})$:指数上永远是非正数,不会溢出。BCEWithLogitsLoss 内部就是这个式子。多分类同理:$\log y_k=z_k-\operatorname{logsumexp}(z)$,log_softmax 先减去最大值再求和。
多标签与多分类的区别。一张图里同时有猫和狗,标签是 $(1,1,0)$,各类之间不互斥,每一维单独做 sigmoid + BCE,概率之和不必为 $1$。只有“恰好一个类别正确”时才用 softmax:它强制概率和为 $1$,一个类升高必然压低其他类。
类别不平衡。正例只占 1% 时,模型全猜负例就有 99% 准确率,交叉熵也已经不小。两种常见对策:
- 加权交叉熵:$L=-\sum_k w_k t_k\log y_k$,少数类权重大,常取 $w_k\propto 1/\text{频率}$ 或其平方根。PyTorch 中是
CrossEntropyLoss(weight=...),二分类是BCEWithLogitsLoss(pos_weight=...)。 - Focal loss(Lin et al., 2017,RetinaNet):记正确类的概率为 $p_t$,
$$ \mathrm{FL}(p_t)=-(1-p_t)^{\gamma}\log p_t,\qquad \gamma=2. $$
$(1-p_t)^{\gamma}$ 把已经分对的简单样本压下去,让梯度集中在难样本上:
| $p_t$ | 交叉熵 $-\log p_t$ | Focal($\gamma=2$) | 压低倍数 |
|---|---|---|---|
| $0.9$(简单) | $0.105$ | $0.0011$ | $100$ |
| $0.5$ | $0.693$ | $0.173$ | $4$ |
| $0.1$(困难) | $2.303$ | $1.865$ | $1.23$ |
检测中每张图有上万个背景候选框,几乎都是简单负例。不压低它们,简单负例的损失总和会淹没少数难样本。
Hinge 损失(SVM)。标签取 $y\in\{-1,+1\}$,分数为 $z$,定义间隔(margin)$yz$:
$$ L_{\mathrm{hinge}}=\max(0,1-yz),\qquad \frac{\partial L}{\partial z}=\begin{cases}-y, & yz<1,\\ 0, & yz\ge 1.\end{cases} $$
同样用 $\pm1$ 标签,逻辑回归的损失可以写成 $\log(1+e^{-yz})$。两者都随间隔增大而下降,区别在于 hinge 在间隔超过 $1$ 后损失和梯度都恰好为 $0$,“分对且有余量”的样本不再贡献任何梯度;逻辑损失永远大于 $0$,还会继续把分数推大。多分类版本(CS231n)是 $\sum_{j\neq y}\max(0,z_j-z_y+1)$:要求正确类的分数比每个错误类至少高 $1$。神经网络中交叉熵更常用,因为它输出校准过的概率。
交叉熵与 KL 散度。对标签分布 $p$ 和预测分布 $q$,
$$ H(p,q)=-\sum_k p_k\log q_k=\underbrace{-\sum_k p_k\log p_k}_{H(p)}+\underbrace{\sum_k p_k\log\frac{p_k}{q_k}}_{\mathrm{KL}(p\Vert q)}. $$
$H(p)$ 与模型无关,所以对 $q$ 最小化交叉熵等价于最小化 KL 散度。标签是 one-hot 时 $H(p)=0$,两者完全相等;标签是软分布时(标签平滑、知识蒸馏),二者相差一个常数,梯度相同。蒸馏用 F.kl_div(F.log_softmax(z_s / T), F.softmax(z_t / T), reduction="batchmean") * T**2:学生向教师在温度 $T$ 下的软分布靠拢,乘 $T^2$ 是为了让梯度量级不随 $T$ 改变。
其他任务的损失
后面各章还会遇到专门的损失,它们都建立在上面的基本形式上:
- Triplet loss(人脸):$\max(\lVert f(A)-f(P)\rVert^2-\lVert f(A)-f(N)\rVert^2+\alpha,0)$,是作用在距离上的 hinge;
- 对比损失 NT-Xent(自监督):在 batch 内找出正样本对的交叉熵;
- Dice loss(分割):直接优化预测与真值的重叠率,前景很小时比逐像素交叉熵稳;
- 内容与风格损失(风格迁移):特征图和 Gram 矩阵上的 MSE;
- YOLO 损失:坐标的平方误差、置信度与类别的交叉熵加权求和;
- VAE 损失:重构的负对数似然加 KL 项。
实现与核对
每个损失返回 (loss, dz),dz 是对 logits 或预测值的梯度(已除以 batch 大小),再用 PyTorch autograd 核对:
1 | def mse(yhat, y): |
1 | def sigmoid(z): |
F.mse_loss 没有 $\frac12$,所以上面乘了 $0.5$ 才能对上;自己写的损失与框架对拍时,常数因子和“是否对 batch 取平均”(reduction="mean" 或 "sum")是最常见的不一致来源。
推理示例:MNIST
把前面的部件拼起来,就能完成一个真实任务的推理(假设参数已训练好)。
- 数据:MNIST 手写数字,训练 6 万张、测试 1 万张,每张 $28\times 28$ 灰度图,像素取值 0–255。
- 预处理:展平为 784 维向量;像素除以 255 缩放到 $[0,1]$(称为正规化,normalization)。更常见的预处理是减均值、除以标准差,使数据以 0 为中心;还有使分布形状均匀化的白化(whitening)。
- 网络:784 → 50 → 100 → 10,隐藏层 sigmoid,输出层 softmax。权重形状(行样本约定)为 $(784,50),(50,100),(100,10)$。
- 结果:取输出中概率最大的类别作为预测(
np.argmax),测试集准确率 93.52%。
批处理:一次只输入一张图时,形状链是 $(784,)\to(10,)$。若一次输入 100 张,输入变为 $(100,784)$,输出为 $(100,10)$,第 $i$ 行就是第 $i$ 张图的结果。这样打包的输入称为一个批(batch)。批处理更快,因为数值库对大矩阵运算做了高度优化,而且减少了数据搬运的开销,让更多时间花在计算上。
1 | batch_size = 100 |
反向传播(Backpropagation)
为什么需要反向传播
训练需要 $J$ 对每个参数的梯度。用数值微分,每个参数都要前向两次;一个有一百万参数的网络,一步更新就要两百万次前向,完全不可行。反向传播(误差反向传播法,error backpropagation)利用链式法则,只需一次前向 + 一次反向,就能得到所有参数的梯度,代价与前向同阶。
理解反向传播最直观的工具是计算图(computational graph):把计算拆成一个个节点,每个节点只做一件简单的事。
计算图
▸例9 买苹果(鱼书 5.1 节)
买 2 个单价 100 日元的苹果,消费税 10%,应付多少?
前向(从左到右):$100\xrightarrow{\times 2}200\xrightarrow{\times 1.1}220$。
现在问:苹果单价涨一点,总价涨多少?即求 $\partial(\text{总价})/\partial(\text{单价})$。反向(从右到左)传递导数:
- 起点是 $\partial(\text{总价})/\partial(\text{总价})=1$;
- 经过“$\times 1.1$”节点,乘以 1.1,得 1.1;
- 经过“$\times 2$”节点,乘以 2,得 2.2。
所以单价每涨 1 日元,总价涨 2.2 日元。顺带还能得到:对苹果个数的导数是 110,对消费税的导数是 200。
计算图的两个好处:
- 局部计算:每个节点只需关心自己的输入输出,不管全局多复杂。例如在超市买了很多东西,“$\times$ 税率”节点只需要知道税前总额。
- 中间结果可复用:前向时存下每个节点的值,反向时一次就能求出所有变量的导数。
链式法则
反向传播的数学基础是链式法则:复合函数的导数等于各环节导数的乘积。例如 $z=t^{2}$,$t=x+y$:
$$ \frac{\partial z}{\partial x}=\frac{\partial z}{\partial t}\cdot\frac{\partial t}{\partial x}=2t\cdot 1=2(x+y). $$
在计算图上,反向传播就是:把从右边传来的上游梯度,乘以本节点的局部导数,再传给左边。
基本节点
- 加法节点 $z=x+y$:$\partial z/\partial x=\partial z/\partial y=1$,所以上游梯度原样传给两个输入。
- 乘法节点 $z=xy$:$\partial z/\partial x=y$,$\partial z/\partial y=x$,所以上游梯度乘以另一个输入再传回(输入“交换”)。因此乘法节点反向时需要前向的输入值,必须缓存。
▸例10 买苹果和橘子
2 个苹果(单价 100)、3 个橘子(单价 150),税率 1.1。
前向:苹果 $100\times 2=200$,橘子 $150\times 3=450$,加法得 $650$,乘税得 $715$。
反向:
- 乘税节点:对税前总额的导数是 $1.1$,对税率的导数是 650;
- 加法节点:把 $1.1$ 原样传给苹果总价和橘子总价;
- 苹果的乘法节点:对单价的导数 $1.1\times 2=$ 2.2,对个数的导数 $1.1\times 100=$ 110;
- 橘子的乘法节点:对单价的导数 $1.1\times 3=$ 3.3,对个数的导数 $1.1\times 150=$ 165。
激活函数层
把神经网络的每种运算实现成一个“层”,每层提供 forward 和 backward 两个方法,网络就像积木一样拼起来。
ReLU 层:前向时 $x>0$ 输出 $x$,否则输出 0;反向时 $x>0$ 的位置梯度原样通过,$x\le 0$ 的位置梯度置 0。前向时记下布尔掩码
mask = (x <= 0),反向时dout[mask] = 0。ReLU 就像一个开关:前向时导通的位置,反向时也导通。Sigmoid 层:$y=1/(1+e^{-x})$ 可以拆成“$\times(-1)$ → $\exp$ → $+1$ → 取倒数”四个节点。逐个反向:
- 取倒数 $y=1/u$:局部导数 $-1/u^{2}=-y^{2}$;
- $+1$:原样通过;
- $\exp$:局部导数 $e^{-x}$;
- $\times(-1)$:乘以 $-1$。
合起来,上游梯度 $\frac{\partial L}{\partial y}$ 变为
$$ \frac{\partial L}{\partial y}\,y^{2}e^{-x}=\frac{\partial L}{\partial y}\cdot\frac{1}{1+e^{-x}}\cdot\frac{e^{-x}}{1+e^{-x}}=\frac{\partial L}{\partial y}\,y(1-y). $$
反向只需前向的输出 $y$,与 $\sigma'(z)=\sigma(z)(1-\sigma(z))$ 一致。
Affine 层
神经网络前向中的矩阵乘加偏置,在几何上称为仿射变换(affine transformation),对应的层称为 Affine 层。按上一节的恒等式,列样本约定 $Z=WA+b$ 下:
$$ \frac{\partial J}{\partial W}=\mathrm{d}Z\,A^{\top},\qquad \frac{\partial J}{\partial A}=W^{\top}\mathrm{d}Z,\qquad \frac{\partial J}{\partial b}=\sum_{\text{样本}}\mathrm{d}Z. $$
偏置在前向时被广播到每个样本上,所以反向时要把每个样本的梯度加起来(沿样本维求和)。鱼书的行样本约定 $Y=XW+b$ 下对应为 $\partial L/\partial X=\frac{\partial L}{\partial Y}W^{\top}$、$\partial L/\partial W=X^{\top}\frac{\partial L}{\partial Y}$、$\partial L/\partial b$ 沿第 0 轴求和。
Softmax-with-Loss 层
把 softmax 和交叉熵合成一个层,反向时的梯度极其简洁:
$$ \frac{\partial L}{\partial z_k}=y_k-t_k. $$
即“输出减标签”,与 sigmoid + 二元交叉熵的 $a-y$ 完全一致。批处理时再除以批大小。
推导分两步:先求 softmax 的 Jacobian,再与交叉熵的梯度相乘。
第一步,softmax $y_k=e^{z_k}/S$,$S=\sum_j e^{z_j}$。对 $z_i$ 求导,分 $i=k$ 和 $i\neq k$ 两种情况(商的求导法则,注意 $\partial S/\partial z_i=e^{z_i}$):
$$ \frac{\partial y_k}{\partial z_i}= \begin{cases} \dfrac{e^{z_k}S-e^{z_k}e^{z_k}}{S^{2}}=y_k(1-y_k), & i=k,\\[2ex] \dfrac{0\cdot S-e^{z_k}e^{z_i}}{S^{2}}=-y_k y_i, & i\neq k. \end{cases} $$
两种情况合写为 $\frac{\partial y_k}{\partial z_i}=y_k(\delta_{ki}-y_i)$,矩阵形式是 $\frac{\partial y}{\partial z}=\mathrm{diag}(y)-yy^{\top}$。对角线上的 $y_k(1-y_k)$ 与 sigmoid 的导数形式相同;非对角项为负,因为一个类的分数变大,会把其他类的概率挤小。
第二步,交叉熵 $L=-\sum_k t_k\log y_k$,所以 $\frac{\partial L}{\partial y_k}=-\frac{t_k}{y_k}$。链式法则对所有 $k$ 求和:
$$ \frac{\partial L}{\partial z_i} =\sum_k\frac{\partial L}{\partial y_k}\frac{\partial y_k}{\partial z_i} =\sum_k\Big(-\frac{t_k}{y_k}\Big)y_k(\delta_{ki}-y_i) =-\sum_k t_k\delta_{ki}+y_i\sum_k t_k =-t_i+y_i. $$
最后一步用了 $\sum_k t_k=1$(one-hot 或任何概率分布标签都成立)。分母里的 $y_k$ 被 Jacobian 里的 $y_k$ 消掉了,所以合并成一层后既简单又数值稳定:不需要计算 $1/y_k$,$y_k$ 很小时也不会除以接近 $0$ 的数。这就是框架把 softmax 和交叉熵合成 CrossEntropyLoss 一个函数的原因。
更直接的推法是先化简损失:$\log y_k=z_k-\log S$,于是
$$ L=-\sum_k t_k z_k+\log\sum_j e^{z_j},\qquad \frac{\partial L}{\partial z_i}=-t_i+\frac{e^{z_i}}{\sum_j e^{z_j}}=y_i-t_i. $$
$\log\sum_j e^{z_j}$ 称为 log-sum-exp,它的梯度正好是 softmax。
1 | def softmax_jacobian(y): |
▸例11 误差的大小反映错误的程度
标签 $t=(0,1,0)$:
- softmax 输出 $y=(0.3,0.2,0.5)$,正确类概率只有 0.2,识别错误。反向传回 $(0.3,\,-0.8,\,0.5)$,误差很大,前面的层会做较大调整。
- softmax 输出 $y=(0.01,0.99,0)$,识别得相当准确。反向传回 $(0.01,\,-0.01,\,0)$,误差很小,前面的层只做微小调整。
回归问题中“恒等函数 + 均方误差”也有同样的结果 $y-t$。这不是巧合:交叉熵与 softmax、均方误差与恒等函数,都是为了得到这个简洁形式而成对设计的。
两层网络的反向公式
把以上节点串起来,就得到浅层网络的完整反向传播。二分类取 $g^{[2]}=\sigma$,则 $\mathrm{d}Z^{[2]}=A^{[2]}-Y$,其余按 Affine 层与激活层依次往回传:
$$ \begin{aligned} \mathrm{d}W^{[2]} &= \frac{1}{m}\mathrm{d}Z^{[2]}A^{[1]\top},& \mathrm{d}b^{[2]} &= \frac{1}{m}\sum_{i}\mathrm{d}Z^{[2](:,i)},\\ \mathrm{d}A^{[1]} &= W^{[2]\top}\mathrm{d}Z^{[2]},& \mathrm{d}Z^{[1]} &= \mathrm{d}A^{[1]}\odot g^{[1]\prime}(Z^{[1]}),\\ \mathrm{d}W^{[1]} &= \frac{1}{m}\mathrm{d}Z^{[1]}X^{\top},& \mathrm{d}b^{[1]} &= \frac{1}{m}\sum_{i}\mathrm{d}Z^{[1](:,i)}. \end{aligned} $$
- $\odot$ 是逐元素乘:激活函数逐元素作用,所以它的反向也是逐元素乘局部导数。
- $g=\tanh$ 时 $g'(z)=1-\tanh^{2}(z)=1-a^{2}$,用前向已算的 $A^{[1]}$ 即可,不必另存 $Z^{[1]}$。
- ReLU 必须知道 $Z^{[1]}$ 的符号,需要缓存 $Z^{[1]}$(或掩码)。
▸两层网络的链式法则
$J$ 对 $W^{[2]}$ 的依赖路径是 $W^{[2]}\rightarrow Z^{[2]}\rightarrow A^{[2]}\rightarrow J$。$\mathrm{d}W^{[2]}=\mathrm{d}Z^{[2]}A^{[1]\top}/m$,因为 $Z^{[2]}$ 的第 $k$ 行来自 $W^{[2]}$ 第 $k$ 行与 $A^{[1]}$ 的内积。对 $A^{[1]}$ 求导时,$W^{[2]\top}$ 把输出层的误差“投影”回隐藏层的坐标;再乘以隐藏层的局部激活导数,才得到 $\mathrm{d}Z^{[1]}$。漏乘 $g'$ 是实现中最常见的错误之一。
实现
激活函数层与两层网络的前向、反向:
1 | def tanh_forward(Z): |
- 初始化
- 不能全零:若 $W^{[1]}=W^{[2]}=0$,所有隐藏单元计算同一个函数,收到同样的梯度,更新后仍然相同,永远无法分化出不同的特征(对称性问题);
- 常用小的高斯随机数,或按后文 Xavier/He 缩放;
- $b$ 可以零初始化,因为 $W$ 的随机性已经打破了对称。
- 训练循环
- 每步四件事:前向、算损失、反向、更新;
- 更新必须用当前步的梯度,不能把所有层的梯度算完后再用过期的激活;
- 学习率对浅层网络同样敏感:平面数据上 $\alpha=1.2$ 可能合适,而 $\alpha=0.01$ 会显得“网络学不会”;
- 损失曲线还没下降时,先不要换架构,先查学习率和实现。
1 | def two_layer_update(params, grads, lr): |
- 决策边界:$A^{[2]}=0.5$ 即 $Z^{[2]}=0$,在输入平面上一般是曲线。把网格上的点送入前向,按输出着色即可画出。
- 若边界仍接近直线,可能是隐藏层过窄、激活近似线性(输入落在 tanh 的线性区),或训练未收敛。
同一个两层网络的 PyTorch 写法。注意两点:PyTorch 的 nn.Linear 按行样本排布(输入 (m, n_x),权重 (n_out, n_in),计算 $XW^{\top}+b$);输出层不写 sigmoid,而是把 logits 交给 BCEWithLogitsLoss,它内部用数值稳定的方式合并 sigmoid 与交叉熵,对应前面的 $\mathrm{d}Z^{[2]}=A^{[2]}-Y$。
1 | import torch |
model.fc1.weight.grad与手写的dW1同形(n_h, n_x),可以直接对拍:同一组初值下两者应一致到 $10^{-6}$ 量级(float32)。- 漏写
zero_grad()时梯度会跨步累加,等价于学习率越来越大,损失往往先降后炸。
▸例12 鱼书的两层网络训练(MNIST)
784 → 50 → 10 的两层网络,mini-batch 大小 100,学习率 0.1,迭代 10000 次。训练集 60000 张、batch 100,所以遍历一遍训练集需要 600 次迭代,称为一个 epoch。每个 epoch 记录一次训练集与测试集准确率,两条曲线几乎重合且一起上升,说明没有过拟合。用数值微分做同样的训练会慢几个数量级,这正是反向传播的价值。
▸衔接
两层网络已经具备完整的“前向缓存 + 反向外积”结构,每一层都是一个有 forward / backward 的模块。下一部分只是把这两步放进 $l=1\to L$ 与 $l=L\to 1$ 的循环,接口不变;随后讨论网络变深之后才出现的问题:初始化、过拟合、优化速度。
深层网络与训练
浅层网络的前向与反向已经写清楚,把它推广到 $L$ 层只是加一个循环。真正的困难在于:网络一深,训练本身就变难了。这一部分按问题出现的顺序组织:
- 深层网络:$L$ 层的通用接口,以及用梯度检查验证反向传播写对了;
- 初始化:权重的初始尺度决定信号能否穿过很多层;
- 优化:mini-batch、Momentum、AdaGrad / RMSprop、Adam、学习率衰减,决定损失下降得快不快、稳不稳;
- 批归一化:把每层激活的分布强制拉回合适范围,降低对初始化和学习率的敏感度;
- 正则化:训练误差降下来之后,缩小训练集与开发集之间的差距(过拟合);
- 超参数:上述方法引入的 $\alpha,\beta,\lambda$ 等如何在验证集上搜索。
前四节回答“训练误差降不降得下去”,第五节回答“能不能泛化”,第六节回答“这些旋钮怎么拧”。
深层网络(Deep Neural Network)
为什么要深
深层网络把浅层的前向、反向两步写成对 $l=1\to L$ 的循环。层宽记为 $[n^{[0]},\ldots,n^{[L]}]$,隐藏层的激活函数通常相同,输出层由任务决定。后面的卷积网络和 RNN 只是把 $W^{[l]}A^{[l-1]}$ 换成带权重共享的线性算子,反向接口不变;Dropout、BatchNorm、残差也都挂在这套层接口上。
为什么要加深而不是加宽?
- 特征层次(经验动机):浅层学到边缘,中层学到纹理和部件,深层学到物体。像素 → 边缘 → 部件 → 物体,每一层都在上一层的基础上组合出更抽象的特征。
- 参数效率:同样的参数预算下,深度组合比单层极宽更省,中间表示可以被后续层复用。通用逼近定理说单隐藏层足够,但所需宽度可能是指数级的。
- 这不是定理:过深而没有残差连接、没有合适的初始化时,训练误差反而会上升(见卷积部分的 ResNet)。
作业中的 $L$ 层模型通常是 2–5 层全连接,目标是把循环接口写对,不是追求 ImageNet 精度。
前向
对 $l=1,\ldots,L$:
$$ Z^{[l]}=W^{[l]}A^{[l-1]}+b^{[l]},\qquad A^{[l]}=g^{[l]}(Z^{[l]}). $$
输出层按任务选择:
- 二分类:$g^{[L]}=\sigma$,$J$ 为二元交叉熵。
- $K$ 类:$g^{[L]}=\mathrm{softmax}$,减去最大值保证数值稳定:
$$ a_k=\frac{e^{z_k-\max_j z_j}}{\sum_{j=1}^{K}e^{z_j-\max_j z_j}},\qquad \mathcal{L}=-\sum_{k=1}^{K}y_k\log a_k. $$
$y$ 为 one-hot 时 $\mathcal{L}=-\log a_{k^{\ast}}$,$k^{\ast}$ 是正确类别。
▸softmax 交叉熵的 $dz$
令 $a_k=\mathrm{softmax}(z)_k$,$\mathcal{L}=-\sum_k y_k\log a_k$。softmax 的每个输出依赖所有输入,所以先求 Jacobian:
$$ \frac{\partial a_k}{\partial z_j}=a_k(\delta_{kj}-a_j), $$
其中 $\delta_{kj}$ 在 $k=j$ 时为 1,否则为 0。再由链式法则,并利用 $\sum_k y_k=1$:
$$ \frac{\partial\mathcal{L}}{\partial z_j}=\sum_k \frac{\partial\mathcal{L}}{\partial a_k}\frac{\partial a_k}{\partial z_j} =\sum_k\left(-\frac{y_k}{a_k}\right)a_k(\delta_{kj}-a_j)=-y_j+a_j\sum_k y_k=a_j-y_j. $$
与 sigmoid + BCE 相同:配对使用时输出层误差就是 $a-y$,不要再乘一遍 softmax 的 Jacobian。若损失改成 MSE,该简化不成立。
参数量约为 $\sum_l (n^{[l]}n^{[l-1]}+n^{[l]})$。图像若先展平再接全连接,参数量随图像长宽增长,而且模型默认任意两个像素同等相关,丢掉了“相邻像素关系更密切”的空间结构。让相邻位置共享权重,正是后面卷积网络的动机。
作业中常见的结构是 [12288, 20, 7, 5, 1](输入是 $64\times 64\times 3$ 的展平图像):
| 层 $l$ | $W^{[l]}$ | $b^{[l]}$ | $A^{[l]}$ |
|---|---|---|---|
| 1 | $(20, 12288)$ | $(20, 1)$ | $(20, m)$ |
| 2 | $(7, 20)$ | $(7, 1)$ | $(7, m)$ |
| 3 | $(5, 7)$ | $(5, 1)$ | $(5, m)$ |
| 4 | $(1, 5)$ | $(1, 1)$ | $(1, m)$ |
- 第一层独占几乎全部参数($20\times 12288=245760$ 个权重)。
- 前向时每层存一个缓存
caches[l-1] = (lin_cache, act_cache),其中lin_cache=(A^{[l-1]}, W^{[l]}, b^{[l]})。丢掉 $A^{[l-1]}$ 就无法计算 $\mathrm{d}W^{[l]}$。 - 前向必须按 $l=1\to L$,因为 $A^{[l]}$ 依赖 $A^{[l-1]}$;反向必须按 $l=L\to 1$,因为 $\mathrm{d}A^{[l-1]}$ 依赖 $\mathrm{d}Z^{[l]}$。把反向写成与前向相同的升序循环是逻辑错误,梯度检查会立刻失败。
反向
反向从输出层开始:
- 一般情况令 $\mathrm{d}A^{[L]}=\partial J/\partial A^{[L]}$,再乘 $g^{[L]\prime}$ 得 $\mathrm{d}Z^{[L]}$。
- sigmoid + BCE:直接设 $\mathrm{d}Z^{[L]}=A^{[L]}-Y$。
- softmax + 分类交叉熵:若 $Y\in\{0,1\}^{K\times m}$ 是 one-hot 标签,同样有 $\mathrm{d}Z^{[L]}=A^{[L]}-Y$。此时 $A^{[L]}$ 和 $Y$ 都是 $(K,m)$,每列和为 $1$。
然后对 $l=L,\ldots,1$ 重复同一组公式(就是浅层网络的反向公式加上层号):
$$ \begin{aligned} \mathrm{d}W^{[l]} &= \frac{1}{m}\mathrm{d}Z^{[l]}A^{[l-1]\top},\\ \mathrm{d}b^{[l]} &= \frac{1}{m}\sum_{i=1}^{m}\mathrm{d}Z^{[l](:,i)},\\ \mathrm{d}A^{[l-1]} &= W^{[l]\top}\mathrm{d}Z^{[l]},\\ \mathrm{d}Z^{[l-1]} &= \mathrm{d}A^{[l-1]}\odot g^{[l-1]\prime}(Z^{[l-1]}). \end{aligned} $$
- 若损失已与输出激活配对,最后一层不必再乘 $g^{[L]\prime}$。
- 每层必须缓存 $A^{[l-1]}$,以及激活函数求导所需的 $Z^{[l]}$ 或掩码。
▸例1 多分类输出(multiclass output)
三分类时 $W^{[L]}$ 的 shape 是 $(3,n^{[L-1]})$,而不是 $(1,n^{[L-1]})$。前向和损失为
$$ A^{[L]}=\operatorname{softmax}(Z^{[L]}),\qquad J=-\frac{1}{m}\sum_{i=1}^{m}\sum_{k=1}^{3} Y_{ki}\log A_{ki}^{[L]}. $$
反向仍从 $\mathrm{d}Z^{[L]}=A^{[L]}-Y$ 开始。这个简化只适用于 softmax 与分类交叉熵的配对。若 $Y$ 只是类别号 $(m,)$,应先转成 one-hot,或使用框架提供的 sparse categorical cross-entropy,不能直接依赖 NumPy 广播相减。
▸反向传播作为动态规划
从 $A^{[L]}$ 到 $W^{[1]}$ 的计算图是一条长链。朴素的数值差分需要对每个参数各做两次前向。反向传播从输出往回走,每一层复用上一层算好的 $\mathrm{d}Z$,每条边只访问一次,总代价与一次前向同阶,这本质上是动态规划。缓存是空间换时间:不存 $A^{[l]}$ 就无法用外积形成 $\mathrm{d}W^{[l+1]}$。梯度检查点(checkpointing)可以丢掉部分激活、在反向时重算,用计算换显存。
实现
1 | def softmax(Z): |
- 每步更新的代价为 $O(\sum_l n^{[l]}n^{[l-1]}m)$,与前向同阶。
- 不要在反向过程中立刻修改 $W^{[l]}$:后续层的 $\mathrm{d}A^{[l-1]}=W^{[l]\top}\mathrm{d}Z^{[l]}$ 需要用更新前的权重。正确顺序是全部
dW算完,再统一更新。
梯度检查
反向传播的公式很容易写错一个转置或漏乘一个导数,而且错了之后网络往往仍能“训练”,只是效果差,很难察觉。梯度检查(gradient checking)用数值微分作为参照:数值微分慢但几乎不会写错,反向传播快但容易写错,两者结果一致就说明反向传播正确。
对每个参数分量用中心差分:
$$ \frac{\partial J}{\partial\theta_i}\approx\frac{J(\theta_i+\varepsilon)-J(\theta_i-\varepsilon)}{2\varepsilon}. $$
把所有参数拉平成一个长向量,用相对误差衡量两者差距(相对误差不受梯度整体大小影响):
$$ \frac{\|\mathrm{d}\theta_{\mathrm{num}}-\mathrm{d}\theta_{\mathrm{bp}}\|_2}{\|\mathrm{d}\theta_{\mathrm{num}}\|_2+\|\mathrm{d}\theta_{\mathrm{bp}}\|_2}. $$
- 判据($\varepsilon=10^{-7}$、双精度):
- 相对误差 $<10^{-7}$:实现通常正确;
- $10^{-5}$ 量级:需要排查;
- $10^{-2}$:公式或 shape 有错误。
- 数值梯度要对每个参数前向两次,代价极高,只在小模型上检查,检查完就关掉。
- 检查时关闭 Dropout(随机掩码会让每次前向的 $J$ 不同),BatchNorm 使用固定统计量。
- 若加了正则项,$J$ 中必须包含正则项,否则两边的梯度对不上。
1 | def gradient_check(forward_loss, params, grads, eps=1e-7): |
▸例2 鱼书两层网络的梯度确认
在 MNIST 两层网络上,比较数值微分与反向传播得到的梯度,各参数的平均绝对误差为:$W_1$:$2.2\times 10^{-13}$,$b_1$:$9.7\times 10^{-13}$,$W_2$:$8.4\times 10^{-13}$,$b_2$:$1.2\times 10^{-10}$。误差极小且不为零,后者源于浮点运算精度有限,说明反向传播实现正确。
$\varepsilon$ 的取法是一个折中:太大,差分本身对导数的近似变差(截断误差约 $O(\varepsilon^{2})$);太小,$J(\theta+\varepsilon)$ 与 $J(\theta-\varepsilon)$ 几乎相等,相减时有效数字被抵消(舍入误差约 $O(\epsilon_{\text{mach}}/\varepsilon)$)。双精度下取 $10^{-7}$ 左右,单精度下应放大到 $10^{-3}$ 左右。
先过拟合一个小 batch
梯度检查只说明“反向传播与前向一致”,不说明整个训练管道没有问题。CS230 速查表(Deep Learning Tips and Tricks)推荐的另一项检查是:取一个很小的 batch,看模型能不能把它背下来。
- 做法:固定一个 mini-batch(例如 $16$–$64$ 个样本),关掉 Dropout、数据增强与权重衰减,在这一批上反复迭代几百步。
- 预期:损失接近 $0$,训练准确率接近 $100\%$。参数量远大于样本数,网络完全有能力记住它们。
- 背不下来时,先查这些,而不是先调网络结构:
- 标签与输入是否错位(打乱 $X$ 时没有同步打乱 $Y$);
- 损失与输出层是否匹配(sigmoid 输出却用了 softmax 交叉熵,或 logits 被重复过了一次 softmax);
- 学习率是否过大或过小;梯度是否真的流到了每一层(参数是否注册进了优化器、是否误加了
stop_gradient); - 预处理是否把输入变成了常数(例如整数除法把像素全变成 $0$)。
- 速查表的说法是:若网络连一个小 batch 都过拟合不了,那它要么太复杂而训不动,要么太简单,正常大小的训练集就更不用谈了。
这项检查只花几分钟,应当在每次搭新管道、换损失或换数据格式后先跑一次,再开始正式训练。
1 | import torch |
PyTorch 也自带梯度检查:torch.autograd.gradcheck 用中心差分核对自定义算子的反向,要求输入为双精度。
1 | from torch.autograd import gradcheck |
自己写了 torch.autograd.Function(手写 backward)时,这一步与前面 NumPy 的 gradient_check 作用相同。
▸衔接
$L$ 层接口已写完,梯度也能验证。但同一份代码,权重初始尺度不同,结果可能是正常训练,也可能完全学不动。下一节讨论初始化:全零导致对称,过小使信号逐层收缩,过大使激活饱和或爆炸。
初始化(Initialization)
问题
初始化规定 $W^{[l]}$ 从什么分布采样。它要解决两个问题:
- 打破对称:同一层的神经元必须从不同的起点出发,否则它们永远一样。
- 保持尺度:信号经过很多层后,既不能缩到 0,也不能涨到无穷大,否则梯度会消失或爆炸。
Xavier 与 He 初始化按层宽设定方差,使初始化时刻每层的预激活保持 $O(1)$。深层网络中信号要先传得动,才谈得上正则。
下面按 C2M1 Initialization 作业的三个练习展开:全零(Exercise 1)、大随机数(Exercise 2)、He(Exercise 3),再补上作业没有要求的 Xavier。
不能全零
全零(或全部相同)会导致对称性问题。若同一层每一行权重都相等,前向时这一层所有神经元的预激活相等、输出相等;反向时每一行收到的梯度也相等(回忆乘法节点:梯度依赖另一个输入,而这些输入都相同),更新后仍然相等。于是整层只学到同一个特征,有 100 个神经元也只相当于 1 个。随机初始化打破这组相等。偏置仍可取 $0$,因为权重已经不对称了。
注意,问题不在于“零”,而在于“相同”:同层权重若完全相同,即使不是零,梯度也相同,对称性同样破不掉。
Exercise 1:全零初始化
1 | import numpy as np |
C2M1 Initialization 作业的 Exercise 1 就是这样做的:把所有 $W$、$b$ 都设成 0,然后训练 15000 步。结果 loss 几乎不动,准确率约 50%,和瞎猜一样。原因可以直接顺着前向和反向走一遍:
- 前向:$W^{[1]}=0$,所以第一层每个神经元算出来都是 $0$,ReLU 后还是 $0$。后面每一层也一样,输出只剩偏置决定的一个常数,跟输入 $X$ 无关。
- 反向:$\mathrm{d}W^{[l]}=\mathrm{d}Z^{[l]}A^{[l-1]\top}/m$,而 $A^{[l-1]}$ 全是 0,所以 $\mathrm{d}W^{[l]}=0$;往前传的 $\mathrm{d}A^{[l-1]}=W^{[l]\top}\mathrm{d}Z^{[l]}$,因为 $W^{[l]}=0$,也是 0。所有权重的梯度都是 0,一步也动不了。
就算不是全 0,而是同一层每一行都相同(比如都填 0.5),问题也一样:同一层的神经元收到相同的输入、算出相同的值、拿到相同的梯度、做相同的更新,永远一模一样。10 个神经元等于 1 个。这叫对称性没有被打破。下面是一个可以直接运行的小实验,训练 200 步后,三个隐藏神经元的权重行仍然完全相同:
1 | import numpy as np |
偏置可以是 0。 只要 $W$ 是随机的,各个神经元从一开始算出的值就不同,梯度也不同,自然会分开,偏置从 0 开始没有影响。所以实际写法是:$W$ 用随机数(具体缩放见下文),$b$ 用 np.zeros((n, 1))。
What you should remember(notebook 原话):
- The weights $W^{[l]}$ should be initialized randomly to break symmetry.
- It’s okay to initialize the biases $b^{[l]}$ to zeros. Symmetry is still broken so long as $W^{[l]}$ is initialized randomly.
用 np.random 生成随机权重
既然权重必须随机,先看 NumPy 里造随机数组的几个函数,以及写初始化代码时最常见的错误。
常用函数
| 函数 | 分布 | 例子 | 说明 |
|---|---|---|---|
np.random.randn(d0, d1, ...) |
标准正态 $\mathcal{N}(0,1)$ | np.random.randn(3, 2) |
形状直接写成几个整数,不是元组 |
np.random.rand(d0, d1, ...) |
均匀分布 $[0,1)$ | np.random.rand(3, 2) |
全是正数,不能直接当权重 |
np.random.seed(s) |
— | np.random.seed(3) |
固定全局随机数种子,结果可复现 |
rng = np.random.default_rng(s) |
— | rng.standard_normal((3, 2)) |
新式写法,形状写成元组;rng.normal(0, std, size) 直接指定标准差 |
np.random.uniform(low, high, size) |
均匀分布 $[\text{low},\text{high})$ | np.random.uniform(-0.1, 0.1, (3, 2)) |
Xavier 的均匀分布版本会用到 |
randn 生成的数均值为 0、标准差为 1。乘上常数 $c$ 之后,标准差变成 $c$、方差变成 $c^2$。所以“用方差为 $v$ 的正态分布初始化”写成代码就是 np.random.randn(...) * np.sqrt(v):乘的是标准差,不是方差。
易错点
randn和zeros的形状写法不同。np.zeros((3, 2))要元组;np.random.randn(3, 2)要两个整数,写成np.random.randn((3, 2))会报TypeError。新式的rng.standard_normal((3, 2))又要元组。rand不是randn。rand是 $[0,1)$ 上的均匀分布,全为正数、均值 0.5,用来初始化权重时所有神经元的输入都往同一个方向偏,起不到“零均值、对称”的作用。- 种子只设一次,设在循环外面。 作业里
np.random.seed(3)写在函数开头,之后每层依次从同一个随机数流里取数。若把seed放进for循环里,每层都从同一个起点取数,各层权重的开头部分会一模一样。 - 乘的是标准差。 He 初始化的方差是 $2/n^{[l-1]}$,代码是
* np.sqrt(2 / n_prev);写成* 2 / n_prev就把方差当成了标准差,权重整体小了一个数量级。 - 形状顺序是(本层,前一层)。 与
np.zeros一节相同:np.random.randn(layers_dims[l], layers_dims[l-1])。两个参数写反,形状变成 $(n^{[l-1]},n^{[l]})$,前向W @ A会直接报错(或在两层宽度相同时悄悄算错)。
尺度太小或太大
▸例3 激活值分布的实验(鱼书 6.2 节,参考 CS231n)
5 层网络,每层 100 个神经元,激活函数为 sigmoid,输入 1000 个高斯随机样本,观察各层激活值的直方图:
- 标准差为 1:各层激活值集中在 0 和 1 两端。sigmoid 在两端导数接近 0,反向传播时梯度越来越小,最终消失,即梯度消失(gradient vanishing)。
- 标准差为 0.01:激活值集中在 0.5 附近。梯度不会消失,但 100 个神经元输出几乎相同的值,和 1 个神经元没区别,称为表现力受限。
- Xavier 初始化(标准差 $1/\sqrt{n}$,$n$ 为前一层节点数):各层激活值都有较宽的分布,后面几层略有歪斜。把 sigmoid 换成关于原点对称的 tanh,分布会变成漂亮的钟形。
结论:各层激活值的分布需要有适当的广度。偏向两端会梯度消失,挤在一起会表现力受限。
更一般地:
- 方差过小(标准差 $0.01$):激活和梯度的标准差逐层一起变小,信号消失。
- 方差过大(标准差 $1$):ReLU 与线性层上两者逐层变大,梯度爆炸;tanh / sigmoid 则进入饱和区,局部导数接近 $0$,同样学不动。
- 按 Xavier 或 He 取值:激活与梯度跨层保持同一量级。
下面按 C2M1 Initialization 作业的顺序,用代码复现“尺度太大”的情形。
Exercise 2:随机初始化(大方差)
作业先故意用一个很大的尺度:标准正态再乘 10。代码与 initialize_parameters_zeros 只差一行:
1 | import numpy as np |
输出(与作业的期望输出一致):
1 | W1 = [[ 17.88628473 4.36509851 0.96497468] |
用这组参数训练作业里的三层网络(LINEAR→RELU→LINEAR→RELU→LINEAR→SIGMOID,layers_dims = [2, 10, 5, 1],15000 次迭代),结果如下:
- 第 0 次迭代的 cost 打印出来是
inf。权重太大,最后一层的 $z$ 绝对值很大,sigmoid 输出被推到非常接近 0 或 1。对答错的样本,交叉熵里的 $\log(a)$ 或 $\log(1-a)$ 会变成 $\log 0$,于是 cost 变成无穷大。 - cost 下降之后,训练集准确率约 83%,测试集约 86%。网络打破了对称性,比全 0 的 50% 好,但决策边界不好,学得也慢。
- 原因:权重大,激活就落在 sigmoid 的饱和区,局部导数接近 0,梯度很小;而且一开始预测“很自信又是错的”,损失很大,要用很多步才能把权重拉回合理范围。
What you should remember(notebook 原话):
- The cost starts very high.
- Poor initialization can lead to vanishing/exploding gradients, which also slows down the optimization algorithm.
- Initializing weights to very large random values does not work well.
- Hopefully intializing with small random values does better.
第一条对应上面的
inf:作业说明这个无穷大是数值舍入造成的,sigmoid 输出在浮点数里被舍成了恰好 0 或 1,$\log$ 就变成 $\log 0$。最后一条留下的问题是“小到多少”,下面的 He 初始化给出答案。
Xavier 初始化
推导的出发点是:让每层输出的方差与输入的方差相等。对线性层 $z=\sum_{j=1}^{n_{\mathrm{in}}} w_j a_j$,若 $a_j$ 零均值、方差 $v_a$,$w_j$ 独立零均值、方差 $v_w$,则
$$ \mathrm{Var}(z)=n_{\mathrm{in}}\, v_w\, v_a. $$
($n_{\mathrm{in}}$ 项独立随机变量之和,每项的方差是 $v_w v_a$。)
- 希望前向时 $\mathrm{Var}(z)\approx\mathrm{Var}(a)$,需要 $v_w\approx 1/n_{\mathrm{in}}$。
- 同样要求反向时 $\mathrm{Var}(\mathrm{d}a)\approx\mathrm{Var}(\mathrm{d}z)$,得到 $v_w\approx 1/n_{\mathrm{out}}$。
- 两者通常不能同时满足,取调和折中(Xavier / Glorot):
$$ W^{[l]}\sim\mathcal{N}\left(0,\frac{2}{n^{[l-1]}+n^{[l]}}\right) \quad\text{或均匀分布等价尺度}. $$
Caffe 等框架常简化为只看输入,即 $v_w=1/n_{\mathrm{in}}$、标准差 $1/\sqrt{n}$;课程讲座给 tanh 用的也是这个写法。直观上,前一层节点越多,求和项越多,每个权重就应越小。
Xavier 的推导假设激活函数在 0 附近近似线性。sigmoid 和 tanh 关于中心对称、中间段近似线性,所以适用 Xavier。
作业只要求 He,Xavier 的代码按讲座与原论文补齐。两种形式对应:
- 课程讲座的写法只看输入宽度:$\mathrm{Var}(W^{[l]})=\dfrac{1}{n^{[l-1]}}$,代码
* np.sqrt(1 / n_prev); - Glorot 原论文同时兼顾前向与反向:$\mathrm{Var}(W^{[l]})=\dfrac{2}{n^{[l-1]}+n^{[l]}}$,代码
* np.sqrt(2 / (n_prev + n_cur))。均匀分布版本取 $W\sim U\!\left[-\sqrt{\tfrac{6}{n^{[l-1]}+n^{[l]}}},\ \sqrt{\tfrac{6}{n^{[l-1]}+n^{[l]}}}\right]$,它的方差同样是 $\tfrac{2}{n^{[l-1]}+n^{[l]}}$(区间 $[-a,a]$ 上均匀分布的方差是 $a^2/3$)。
1 | def initialize_parameters_xavier(layers_dims, variant="lecture", uniform=False): |
输出(讲座写法、正态分布;与 He 用的是同一组随机数,每个元素正好是 He 结果的 $1/\sqrt2$):
1 | W1 = [[ 1.26475132 0.30865908] |
He 初始化
ReLU 把负半轴置零。对零均值对称的输入,这会使二阶矩 $\mathbb{E}[a^{2}]$ 大约折半(注意不是严格把方差折半)。为了补偿丢掉的一半,He 初始化把方差乘 2:
$$ W^{[l]}\sim\mathcal{N}\left(0,\frac{2}{n^{[l-1]}}\right). $$
▸例4 ReLU 网络的三种初始化(鱼书 6.2.3 节)
同样的 5 层、每层 100 个神经元的网络,激活换成 ReLU:
- std = 0.01:各层激活的均值依次约为 $0.0396,\ 0.00290,\ 0.000197,\ 1.32\times 10^{-5},\ 9.46\times 10^{-7}$,每层缩小一个数量级以上,反向梯度同样极小,学习基本没有进展。
- Xavier:随层数加深,分布逐渐偏向 0,层再多就会梯度消失。
- He:各层分布的广度保持一致。
在 MNIST 上训练(5 层,每层 100 个 ReLU 神经元):std = 0.01 完全学不动;Xavier 与 He 都能顺利学习,He 更快一些。
当前的最佳实践:ReLU 用 He 初始化,sigmoid / tanh 用 Xavier 初始化。
▸Xavier 与 He
Xavier / Glorot (2010) 按层宽设定 $\mathrm{Var}(W)$,使初始化时预激活保持 $O(1)$,适合 tanh 与 sigmoid。He et al. (2015) 考虑到 ReLU 丢掉负半轴、二阶矩约折半,改用 $2/n_{\mathrm{in}}$。二者都只约束初始化时刻;训练开始后方差仍会变化,这也是后面需要 BatchNorm 的原因之一。
Exercise 3:He 初始化
Exercise 2 留下的问题是“小到多少”。按上面的公式,标准差取 $\sqrt{2/n^{[l-1]}}$,代码只是把 Exercise 2 的 * 10 换成 * np.sqrt(2 / layers_dims[l - 1]):
1 | def initialize_parameters_he(layers_dims): |
输出:
1 | W1 = [[ 1.78862847 0.43650985] |
可以对照着看:$W^{[1]}$ 的前一层宽度是 2,标准差 $\sqrt{2/2}=1$,所以 W1 就是原始的标准正态数;$W^{[2]}$ 的前一层宽度是 4,标准差 $\sqrt{2/4}\approx0.707$,所以 W2 是原始数乘 0.707。注意这里的循环写法 L = len(layers_dims) - 1、range(1, L + 1),与 Exercise 2 的 L = len(layers_dims)、range(1, L) 遍历的是同一组层,只是 L 的含义不同。
同样的三层网络用 He 初始化训练 15000 次:训练集准确率约 99.3%,测试集约 96%,决策边界把两类分得很干净。
实现与对照
作业的三个函数各自写死一种尺度;下面的 init_params 把几种尺度合在一个函数里,用 mode 切换,便于做对比实验。
几种初始化放在一起
| 初始化 | W 的写法 |
训练集准确率(作业三层网络) | 问题 |
|---|---|---|---|
| 全 0 | np.zeros((n_l, n_prev)) |
约 50% | 对称性没打破,同层神经元永远相同 |
| 大随机数 | np.random.randn(n_l, n_prev) * 10 |
约 83% | 权重太大,sigmoid 饱和,初始 cost 为 inf,学得慢 |
| He | np.random.randn(n_l, n_prev) * np.sqrt(2 / n_prev) |
约 99% | 推荐用于 ReLU |
| Xavier | np.random.randn(n_l, n_prev) * np.sqrt(1 / n_prev) |
作业未比较 | 推荐用于 tanh / sigmoid |
1 | def init_params(layer_dims, mode="he", seed=1): |
用 NumPy 复现例 4 的观察:5 层、每层 100 个 ReLU,看各层激活的标准差怎么变。
1 | def activation_stats(scale_fn, n=100, L=5, m=1000, seed=0): |
- std $=0.01$:每层缩小一个数量级以上;
- Xavier(ReLU 下):每层约乘 $1/\sqrt2$;
- He:各层基本不变。
把层数加到 10(每层 100 个 ReLU 神经元),再加上作业里“乘 10”的大尺度,看最后一层激活的标准差,差别更明显:
1 | import numpy as np |
PyTorch 的 nn.Linear 默认用 Kaiming-uniform($a=\sqrt5$),方差比 He 小,等价于 $\mathrm{Var}(W)=1/(3n_{\mathrm{in}})$。要与作业一致,需要显式重设:
1 | import torch.nn as nn |
What you should remember(notebook 原话):
- Different initializations lead to different results
- Random initialization is used to break symmetry and make sure different hidden units can learn different things
- Don’t intialize to values that are too large
- He initialization works well for networks with ReLU activations.
梯度消失与爆炸的连乘解释
反向时,梯度从第 $L$ 层传到第 1 层,要依次乘上每层的 $W^{[l]\top}\mathrm{diag}(g'(z^{[l]}))$,即经过连乘 $\prod_l W^{[l]\top} \mathrm{diag}(g'(z^{[l]}))$。
- 每层的“放大倍数”(谱半径)$>1$:梯度随层数指数增长,即爆炸。
- 每层的谱半径 $<1$:梯度随层数指数衰减,即消失。
- 好的初始化让每层倍数接近 1;残差连接把每层的乘子改成“$1+$ 小残差”,从结构上缓解这个问题。
▸例5 过小与过大初始化的数量级
设十层 tanh 网络,$n^{[l]}=100$。若 $W_{ij}\sim\mathcal{N}(0,0.01^{2})$,每层方差约乘 $100\times 10^{-4}=0.01$,激活幅度逐层收缩,最后一层几乎是常数,梯度接近 0。若 $W_{ij}\sim\mathcal{N}(0,1)$,每层方差约乘 $100$,tanh 饱和,导数接近 0,同样学不动。同一套 $\mathcal{N}(0,1)$ 若接 ReLU,正半轴不截断,激活二阶矩大约每层乘 $n_{\mathrm{in}}/2=50$,激活与梯度一起爆炸。He 对 ReLU 取 $\mathrm{Var}=2/n_{\mathrm{in}}=0.02$,标准差约 $0.14$,使 $\mathrm{Var}(z)$ 保持 $O(1)$。
作业对比图通常显示:零初始化训练准确率停在随机水平;过大初始化损失曲线震荡;He 初始化损失平稳下降。这是 C2M1 编程作业的核心观察。
▸衔接
初始化保证了训练开始时信号和梯度的尺度合适。接下来的问题是:有了梯度,参数该怎么走?下一节讨论优化算法。注意 Dropout 等正则方法不能代替好的初始化,它们解决的是另一类问题。
优化(Optimization)
问题
优化(optimization)决定参数沿梯度怎么走。损失 $J$ 已经给定,这里只选更新规则:输入是梯度 $\mathrm{d}W$,输出是新的 $W$。
神经网络的优化很难:参数空间维度极高、形状复杂,不可能像解方程那样一步求出最小值。鱼书用一个比喻描述这种处境:一位蒙着眼睛、没有地图的探险家,要在广袤的山地中找到最深的谷底,唯一的线索是脚下地面的坡度。SGD 的策略就是“朝坡度最陡的方向走”,而本节的各种方法都是在改进这个策略。
损失不降、曲线剧烈震荡或出现 nan,属于优化失败;加大 $\lambda$ 或加 Dropout 改变的是模型的有效容量,不能代替调学习率。
Mini-batch
▸Mini-batch
Mini-batch 用 $n_b$ 条样本估计梯度并更新一次,损失定义不变。$n_b=m$ 是全批量,方向稳、每个 epoch 只走一步;$n_b=1$ 是随机梯度,噪声大。常用 $32$ 到 $512$。过小则 BatchNorm 统计不稳,过大则一个 epoch 内更新次数变少。
把 $m$ 个样本打乱后分成大小 $n_b$ 的批,每批更新一次参数。第 $t$ 批的损失为:
$$ J_t=\frac{1}{n_b}\sum_{i\in\mathcal{B}_t}\mathcal{L}^{(i)}. $$
由于 mini-batch 是随机抽取的,它的梯度是全批量梯度的无偏估计,只是带有噪声,所以这种做法称为随机梯度下降(stochastic gradient descent, SGD)。
- $n_b=m$:批量梯度下降,方向稳定,但每个 epoch 只更新 1 次,大数据集上太慢。
- $n_b=1$:严格意义的 SGD,噪声大,而且无法利用向量化加速。
- $n_b\in\{32,64,128,256,512\}$:折中。常用 2 的幂以契合 GPU 的计算块。
几个相关概念:
- 一个 epoch 等于全部训练样本都被看过一次。例如 6 万个样本、batch 大小 100,一个 epoch 是 600 次迭代。
- mini-batch 的损失曲线呈云状下降,不是单调的;若要平滑,对 $J_t$ 做指数滑动平均。
- 每个 epoch 开始时都要重新打乱样本,否则同一 mini-batch 的偏差会被网络记住。
▸批量大小
batch 增大时,梯度估计方差(variance of the gradient estimate)下降,矩阵乘吞吐通常提高,但一个 epoch 内的参数更新次数减少。显存占用增加,而且低噪声轨迹有时收敛到泛化较差的尖锐区域(sharp minima)。
- 小批量(small batch):更新噪声大、每个 epoch 更新多,吞吐可能较低。
- 大批量(large batch):梯度稳定、硬件利用率高,但需要更多显存,学习率通常也要重新调。
- 线性缩放规则(linear scaling rule)只是经验起点:batch 放大 $k$ 倍时把学习率放大约 $k$ 倍,并配学习率预热(learning-rate warmup)。它不是对所有优化器和任务都成立的定理。
- 比较实验时要同时说明 batch size、每个 epoch 的更新次数、总样本数与总优化步数,否则“收敛更快”没有统一含义。
1 | def mini_batches(X, Y, batch_size, rng): |
- 打乱必须每个 epoch 重新做。
- 固定 batch 顺序等于让网络记住“第 3 个 batch 总是那些困难样本”,梯度噪声不再无偏。
PyTorch 把“打乱 + 切片”交给 DataLoader;shuffle=True 会在每个 epoch 重新打乱。
1 | from torch.utils.data import TensorDataset, DataLoader |
drop_last=True会丢掉最后不满的一批。带 BatchNorm 时,如果最后一批只剩 1 个样本,方差为 0,训练会报错或不稳定,这时应开启它。- dev/test 的 loader 用
shuffle=False,保证每次评估顺序一致。
SGD 的缺点
普通 SGD 的更新是 $W\leftarrow W-\eta\,\frac{\partial L}{\partial W}$($\eta$ 即学习率 $\alpha$)。它简单,但在某些地形上效率很低。
▸例6 狭长山谷中的 SGD(鱼书 6.1.3 节)
考虑
$$ f(x,y)=\frac{1}{20}x^{2}+y^{2}. $$
它的图形是沿 $x$ 轴拉长的碗,等高线是沿 $x$ 方向拉长的椭圆。梯度 $(x/10,\ 2y)$ 在 $y$ 方向大、$x$ 方向小,在大多数位置并不指向最小值 $(0,0)$。从 $(-7,2)$ 出发做 SGD,路径呈“之”字形:在陡峭的 $y$ 方向来回震荡,在平缓的 $x$ 方向缓慢前进。
这种各方向曲率差别很大的函数称为非均向(anisotropic)的。SGD 低效的根本原因是梯度方向没有指向最小值。下面的 Momentum、AdaGrad / RMSprop、Adam 分别从“平滑方向”和“按维度调步长”两个角度改进。
指数滑动平均(exponentially weighted moving average)
后面几种方法都依赖一个工具:指数滑动平均(EWMA)。它用上一时刻的平滑值和新观测做凸组合,得到“近期数据的平均”:
$$ v_t=\beta v_{t-1}+(1-\beta)\theta_t. $$
展开后 $v_t=(1-\beta)\sum_{k\le t}\beta^{t-k}\theta_k$,越早的观测权重按 $\beta$ 指数衰减。$v_t$ 大约平均了最近 $1/(1-\beta)$ 个值:$\beta=0.9$ 约 10 步,$\beta=0.999$ 约 1000 步。Momentum、RMSprop、Adam 里的 $v,s$,以及损失曲线的平滑,用的都是它。
偏差修正:初始 $v_0=0$,前几步的 $v_t$ 会被这个 0 拉低。例如 $\beta=0.9$、$\theta_1=10$ 时 $v_1=1$,远小于真实水平 10。除以 $1-\beta^t$ 可以修正:
$$ \hat{v}_t=\frac{v_t}{1-\beta^{t}}. $$
$t=1$ 时 $\hat{v}_1=1/(1-0.9)=10=\theta_1$。随着 $t$ 增大,$\beta^t\to 0$,修正自动失效。
1 | def ewma(xs, beta=0.9, bias_correction=True): |
Momentum
▸Momentum
Momentum 把梯度的指数滑动平均当作速度,再沿速度更新。来自 Polyak 重球法,$\beta$ 常取 $0.9$。狭长谷里左右振荡的分量会互相抵消,沿谷底的分量会累积。
Momentum(动量)借用物理直觉:参数像一个在地面上滚动的小球,梯度是作用在它上面的力,力改变的是速度,速度再改变位置。
$$ \begin{aligned} v_{\mathrm{d}W} &= \beta v_{\mathrm{d}W} + (1-\beta)\,\mathrm{d}W,\\ W &\leftarrow W-\alpha v_{\mathrm{d}W}. \end{aligned} $$
在例 6 的山谷中:$x$ 方向的力虽小,但始终同向,速度不断累积;$y$ 方向的力虽大,但正负交替,在平均中相互抵消。于是“之”字形明显减弱,更快地沿谷底前进。
这一点可以定量算出来。只看一个坐标,分两种极端情况求 $v$ 的稳态(令 $v_t=v_{t-1}$):
- 梯度恒为 $g$(沿谷底的方向):$v=\beta v+(1-\beta)g$,解得 $v=g$。速度最终等于梯度本身,每步走 $\alpha g$,与 SGD 相同,没有被削弱。
- 梯度正负交替 $+g,-g,+g,\dots$(横跨山谷的方向):稳态时相邻两步的 $v$ 符号相反、大小相等,设为 $\pm v$。代入 $v=\beta(-v)+(1-\beta)g$,得
$$ v=\frac{1-\beta}{1+\beta}\,g. $$
$\beta=0.9$ 时 $v=0.0526\,g$:震荡方向的步长被压到原来的约 $\frac{1}{19}$,而一致方向的步长不变。这就是 Momentum 的全部作用:一致的分量保留,来回抖的分量抵消。$\beta$ 越大,抵消越彻底,但对方向变化的反应也越慢(大约要 $1/(1-\beta)$ 步才能“转过弯来”)。
鱼书写法是 $v\leftarrow\alpha v-\eta\frac{\partial L}{\partial W}$,$W\leftarrow W+v$,其中 $\alpha v$ 项相当于摩擦或空气阻力,让小球在没有外力时逐渐减速($\alpha$ 取 0.9 左右)。它与上式只差一个尺度:令 $\alpha_{\text{鱼书}}=\beta$,则鱼书的 $v$ 等于 $-\frac{\eta}{1-\beta}v_{\mathrm{d}W}$,即有效学习率为 $\eta/(1-\beta)$。所以把 $(1-\beta)$ 省略的实现,$\alpha$ 的有效尺度会改变,超参数不能直接照抄。
Nesterov 动量先沿速度方向走一步,再在新位置求梯度,对凸问题有更紧的收敛率;课程以普通 Momentum 为主。
AdaGrad 与 RMSprop
▸RMSprop
RMSprop 用梯度平方的滑动平均去除以当前梯度,长期偏大的坐标步长变小,偏小的变大。AdaGrad 把历史梯度平方累加后开方去除以步长,学习率单调衰减,后期几乎走不动。RMSprop 改成滑动平均,避免这一项只增不减。
另一个思路是给每个参数分配自己的学习率。学习率衰减是让所有参数的学习率一起变小;AdaGrad(Ada 取自 adaptive)进一步按参数的每个元素分别衰减:
$$ \begin{aligned} h &\leftarrow h+\frac{\partial L}{\partial W}\odot\frac{\partial L}{\partial W},\\ W &\leftarrow W-\eta\,\frac{1}{\sqrt{h}+\varepsilon}\,\frac{\partial L}{\partial W}. \end{aligned} $$
$h$ 累加了历史上所有梯度的平方。某个参数过去变动越大,$h$ 越大,它的步长就越小。在例 6 中,$y$ 方向梯度大,一开始变动大,但很快被按比例压小,“之”字形明显减弱。$\varepsilon$(鱼书取 $10^{-7}$)防止除零。
AdaGrad 的问题是 $h$ 只增不减:学得越久,步长越小,最终完全停止更新。RMSprop 把累加改成指数滑动平均,逐渐遗忘久远的梯度:
$$ \begin{aligned} s_{\mathrm{d}W} &= \beta_2 s_{\mathrm{d}W} + (1-\beta_2)\,\mathrm{d}W\odot\mathrm{d}W,\\ W &\leftarrow W-\alpha\frac{\mathrm{d}W}{\sqrt{s_{\mathrm{d}W}}+\varepsilon}. \end{aligned} $$
$\varepsilon$ 如 $10^{-8}$,防止除零。梯度长期偏大的坐标步长被缩小,偏小的被放大,自动调整各维学习率。
为什么是除以 $\sqrt{s}$。$s$ 是梯度平方的平均,$\sqrt{s}$ 就是梯度的均方根(RMS,RMSprop 名字的由来),和梯度同一量纲。三个角度理解这一除:
- 步长与梯度尺度无关。若梯度一直是常数 $g$,则 $s\to g^2$,更新为 $\alpha g/\lvert g\rvert=\alpha\,\mathrm{sign}(g)$:无论 $g$ 是 $1000$ 还是 $0.001$,每步都走 $\alpha$。把损失整体乘以 $c$,SGD 的步长也乘以 $c$,RMSprop 的步长不变。于是 $\alpha$ 的含义变成“参数每步大约移动多少”,比 SGD 的学习率直观得多。
- 各维度一视同仁。例 6 中 $y$ 方向梯度是 $x$ 方向的约 $20$ 倍,SGD 只能按 $y$ 方向选一个小学习率,$x$ 方向因此走得极慢。除以各自的 RMS 后,两个方向的步长同量级。
- 近似的曲率修正。对一维二次函数 $f=\frac12 h w^2$,牛顿法的步长是 $g/h$:曲率大的方向走小步。梯度 $g=hw$ 的大小正比于曲率 $h$,所以除以 $\lvert g\rvert$ 粗略地起到了除以曲率的作用。它不是真正的二阶方法,只是一个便宜的对角近似。
AdaGrad 用的是累加 $h=\sum_k g_k^2$,到第 $t$ 步大约是 $t\cdot\overline{g^2}$,步长按 $1/\sqrt{t}$ 衰减,这是它后期停滞的原因;RMSprop 的滑动平均只记最近约 $1/(1-\beta_2)$ 步,$s$ 不会无限增长。
Momentum 与 RMSprop 的 NumPy 更新,接口与后面的 adam_update 相同:
1 | def momentum_update(params, grads, v, lr, beta=0.9): |
在例 6 的 $f(x,y)=x^{2}/20+y^{2}$ 上直接对比路径:
1 | def run(update, steps=30, **kw): |
- SGD 在 $y$ 方向每步乘 $1-2\times 0.95=-0.9$,符号来回翻转,这就是之字形;$x$ 方向每步只乘 $0.905$,走得很慢。
- Momentum 把 $y$ 方向正负交替的梯度平均掉,$x$ 方向持续累积速度;速度大了会冲过最低点再折返,所以第 30 步时离原点未必更近。把
path画出来,能看到它的轨迹比 SGD 平滑得多。 - RMSprop 按各自的梯度尺度归一化,两个方向的步长同量级,最先把 $y$ 压到 $0$。
Adam
▸Adam
Adam(Kingma & Ba, 2015)同时保存梯度的一阶矩(Momentum)和二阶矩(RMSprop),并用 $1-\beta^t$ 修正 $v_0=s_0=0$ 带来的初期偏差。默认 $\beta_1=0.9$,$\beta_2=0.999$。学习率 $\alpha$ 仍要选;实现时 $t$ 必须从 1 递增。
Momentum 平滑了方向,RMSprop 按维度调整了步长,Adam(adaptive moment estimation)把两者合在一起,再加上偏差修正:
$$ \begin{aligned} v_{\mathrm{d}W} &= \beta_1 v_{\mathrm{d}W}+(1-\beta_1)\,\mathrm{d}W,\\ s_{\mathrm{d}W} &= \beta_2 s_{\mathrm{d}W}+(1-\beta_2)\,\mathrm{d}W\odot\mathrm{d}W,\\ \hat{v}_{\mathrm{d}W} &= \frac{v_{\mathrm{d}W}}{1-\beta_1^{t}},\qquad \hat{s}_{\mathrm{d}W} = \frac{s_{\mathrm{d}W}}{1-\beta_2^{t}},\\ W &\leftarrow W-\alpha\frac{\hat{v}_{\mathrm{d}W}}{\sqrt{\hat{s}_{\mathrm{d}W}}+\varepsilon}. \end{aligned} $$
- 默认 $\beta_1=0.9$,$\beta_2=0.999$,$\varepsilon=10^{-8}$。在例 6 中,Adam 的路径也像小球在碗中滚动,但左右摇晃比 Momentum 更轻。
- $t$ 是更新步数,从 1 计。
- 每个参数张量(每个 $W^{[l]},b^{[l]}$)都有自己的 $v,s$。
- Adam 对初始学习率仍敏感,常用 $\alpha\in\{10^{-3},3\times10^{-4},10^{-4}\}$,再配合衰减。
▸偏差修正为何必要
$s$ 的 $\beta_2=0.999$ 使早期 $s_t\approx(1-\beta_2)\sum_{k} \beta_2^{t-k} g_k^{2}$ 远小于稳态值。若不除以 $1-\beta_2^{t}$,分母过小,最初若干步的更新会过大。$\beta_1$ 同样需要修正,但 $\beta_1=0.9$ 时偏差消失更快。实现中若漏掉 $t$ 的递增,等于永远按 $t=1$ 修正,学习率标度错误。
一步步推导 Adam
第 1 步:想要什么。把每个坐标的梯度 $g_t$ 看成随机变量(mini-batch 带来噪声),有均值 $\mathbb E[g]$ 和二阶矩 $\mathbb E[g^2]$。理想的更新应该:
- 方向跟着真实梯度的均值 $\mathbb E[g]$ 走,而不是跟着单个 batch 的噪声走;
- 步长按这个坐标的梯度尺度 $\sqrt{\mathbb E[g^2]}$ 归一化,使各维度、各层的步长同量级。
于是目标形如 $\Delta w=-\alpha\,\mathbb E[g]/\sqrt{\mathbb E[g^2]}$。Adam 的名字 adaptive moment estimation 指的就是“估计一阶矩和二阶矩”。
第 2 步:用滑动平均估计两个矩。两个期望都不能直接算,只能用历史梯度估计。用指数滑动平均(越近的梯度权重越大,适应参数在变化的事实):
$$ v_t=\beta_1v_{t-1}+(1-\beta_1)g_t\approx\mathbb E[g],\qquad s_t=\beta_2s_{t-1}+(1-\beta_2)g_t^2\approx\mathbb E[g^2]. $$
$v$ 就是 Momentum 的速度,$s$ 就是 RMSprop 的分母。$\beta_1=0.9$ 约平均最近 10 步,方向反应快;$\beta_2=0.999$ 约平均最近 1000 步,尺度估计稳。尺度要稳是因为它在分母上,抖动会直接放大成步长的抖动。
第 3 步:发现估计有偏。$v_0=0$,把递推展开:
$$ v_t=(1-\beta_1)\sum_{k=1}^{t}\beta_1^{t-k}g_k. $$
假设梯度分布不随时间变($\mathbb E[g_k]=\mathbb E[g]$),取期望,并用等比数列求和 $\sum_{k=1}^{t}\beta_1^{t-k}=\frac{1-\beta_1^{t}}{1-\beta_1}$:
$$ \mathbb E[v_t]=(1-\beta_1)\cdot\frac{1-\beta_1^{t}}{1-\beta_1}\cdot\mathbb E[g]=(1-\beta_1^{t})\,\mathbb E[g]. $$
所以 $v_t$ 系统性地偏小,偏小的比例正好是 $1-\beta_1^{t}$。原因是滑动平均的权重 $(1-\beta_1)\beta_1^{t-k}$ 加起来只有 $1-\beta_1^t$,缺的那部分权重分给了初始值 $v_0=0$。$s_t$ 同理:$\mathbb E[s_t]=(1-\beta_2^{t})\mathbb E[g^2]$。
第 4 步:修正。既然偏小的比例已知,除掉即可:
$$ \hat v_t=\frac{v_t}{1-\beta_1^{t}},\qquad \hat s_t=\frac{s_t}{1-\beta_2^{t}},\qquad \mathbb E[\hat v_t]=\mathbb E[g],\quad \mathbb E[\hat s_t]=\mathbb E[g^2]. $$
第 5 步:合成更新,加上 $\varepsilon$ 防止除零,就得到 Adam:
$$ w_t=w_{t-1}-\alpha\,\frac{\hat v_t}{\sqrt{\hat s_t}+\varepsilon}. $$
不修正会怎样
两个矩的偏差大小不同,所以不修正时它们不会互相抵消。看第 1 步($t=1$):
$$ v_1=(1-\beta_1)g_1=0.1\,g_1,\qquad s_1=(1-\beta_2)g_1^2=0.001\,g_1^2,\qquad \frac{v_1}{\sqrt{s_1}}=\frac{0.1}{\sqrt{0.001}}\,\mathrm{sign}(g_1)\approx 3.16\,\mathrm{sign}(g_1). $$
不修正,第一步就走 $3.16\alpha$;修正后 $\hat v_1=g_1$、$\hat s_1=g_1^2$,正好走 $\alpha$。梯度恒为常数时,逐步的步长(以 $\alpha$ 为单位)如下:
| $t$ | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 不修正 | 3.16 | 4.25 | 4.95 | 5.44 | 5.80 |
| 修正 | 1 | 1 | 1 | 1 | 1 |
不修正时,前几千步的步长是设定值的数倍(直到 $\beta_2^t$ 衰减掉,约需几千步),训练初期最容易发散,正好落在参数还很差、最需要稳的阶段。
每一步走多远
修正后,更新量 $\Delta_t=\alpha\,\hat v_t/\sqrt{\hat s_t}$ 中的比值有一个很好的解释。设梯度的均值为 $\mu$、方差为 $\sigma^2$,则 $\mathbb E[g^2]=\mu^2+\sigma^2$,
$$ \frac{\hat v_t}{\sqrt{\hat s_t}}\approx\frac{\mu}{\sqrt{\mu^2+\sigma^2}}\in[-1,1]. $$
它是梯度的信噪比:
- 梯度方向稳定($\sigma\ll\lvert\mu\rvert$):比值接近 $\pm1$,每步走满 $\alpha$;
- 梯度噪声大($\sigma\gg\lvert\mu\rvert$),通常是接近最优点时:比值接近 $0$,步长自动变小,相当于自带了学习率退火。
用均值为 $\mu$、标准差为 $1$ 的随机梯度跑 5000 步,统计稳定后平均每步走多远(以 $\alpha$ 为单位):
| $\mu$ | 理论 $\mu/\sqrt{\mu^2+1}$ | 实测 |
|---|---|---|
| $1.0$ | $0.707$ | $0.717$ |
| $0.1$ | $0.0995$ | $0.117$ |
| $0.0$ | $0$ | $0.019$ |
另外 $\lvert\hat v_t\rvert\le\sqrt{\hat s_t}$ 大致成立(均值的平方不超过平方的均值),所以 $\lvert\Delta_t\rvert$ 一般不超过 $\alpha$。Adam 论文给出的严格上界分两种参数情形:$1-\beta_1\le\sqrt{1-\beta_2}$ 时 $\lvert\Delta_t\rvert\le\alpha$;$1-\beta_1>\sqrt{1-\beta_2}$ 时(默认的 $0.1>0.0316$ 属于这种)$\lvert\Delta_t\rvert\le\alpha(1-\beta_1)/\sqrt{1-\beta_2}\approx3.16\alpha$。后者只在梯度长期接近 $0$、某一步突然变大时才会接近,常见情形下 $\lvert\Delta_t\rvert$ 不超过 $\alpha$。因此 $\alpha$ 可以理解为参数空间里的信赖域半径:知道参数大致的合理尺度,就能估出 $\alpha$ 的量级。
梯度正负交替($+1,-1,+1,\dots$)时,修正后的步长依次是 $1,-0.053,0.336,-0.053,0.204,\dots$,奇数步逐渐减小、偶数步稳定在 $-0.053$:与 Momentum 的 $\frac{1-\beta}{1+\beta}$ 一样,来回抖的方向被自动压低。
超参数各管什么
| 超参数 | 默认 | 作用 | 何时改 |
|---|---|---|---|
| $\alpha$ | $10^{-3}$ | 每步大约移动多少 | 最需要调;Transformer 常用 $10^{-4}$ 到 $3\times10^{-4}$ 并加 warmup |
| $\beta_1$ | $0.9$ | 方向平滑的时间窗约 10 步 | GAN 常取 $0.5$,让方向反应更快 |
| $\beta_2$ | $0.999$ | 尺度估计的时间窗约 1000 步 | 大模型训练常取 $0.95$ 或 $0.98$,让 $s$ 更快跟上梯度尺度的突变,减少损失尖峰 |
| $\varepsilon$ | $10^{-8}$ | 防止除零 | 梯度极小或用 fp16 时可增大到 $10^{-6}$ 甚至更大;$\varepsilon$ 很大时 Adam 退化为带动量的 SGD,学习率为 $\alpha/\varepsilon$ |
变体
- AMSGrad:用 $\hat s_t=\max(\hat s_{t-1},s_t)$,分母只增不减,修复了 Adam 在某些构造的凸问题上不收敛的反例(Reddi et al., 2018);实践中提升不稳定,PyTorch 中为
Adam(amsgrad=True)。 - Nadam:把 Nesterov 动量用到 $\hat v$ 上,先“往前看一步”。
- AdamW:解耦权重衰减,见下面的推导;现在训练 Transformer 的默认选择。
- Adafactor / 8-bit Adam:Adam 对每个参数要额外存 $v,s$ 两份,显存是参数的 2 倍。Adafactor 把矩阵的 $s$ 分解成行、列两个向量,8-bit Adam 把 $v,s$ 量化,都是为了省显存。
▸$L_2$ 与 AdamW
对普通 SGD,在损失中加入 $\lambda\|W\|^{2}/2$ 与每步按比例缩小 $W$ 基本等价。Adam 会按坐标缩放梯度,因此把 $\lambda W$ 混进梯度,不再等价于统一的权重衰减。
AdamW 使用解耦权重衰减(decoupled weight decay):
$$ W\leftarrow (1-\alpha\lambda)W -\alpha\frac{\hat v}{\sqrt{\hat s}+\varepsilon}. $$
这里衰减项不经过 Adam 的二阶矩缩放。英文题目中的 L2 regularization with Adam 与 AdamW weight decay 不能自动当作同一件事。
为什么不等价,推一遍。损失加 $\frac{\lambda}{2}\lVert w\rVert^2$ 后,梯度变成 $g+\lambda w$。
- SGD:$w\leftarrow w-\alpha(g+\lambda w)=(1-\alpha\lambda)w-\alpha g$。每个参数都按同一个比例 $1-\alpha\lambda$ 收缩,L2 正则与权重衰减完全相同。
- Adam:$\lambda w$ 进入 $v$ 和 $s$,最后被除以 $\sqrt{\hat s}$。忽略动量,衰减部分约为 $\alpha\lambda w/\sqrt{\hat s}$,每个参数的衰减强度反比于它的梯度 RMS。
举个数:两个权重都等于 $1$,一个梯度 RMS 是 $0.1$,另一个是 $0.001$。L2 + Adam 下,后者每步的衰减是前者的 $100$ 倍;梯度大的权重几乎不被正则。这与“惩罚大权重”的初衷不符:梯度大的往往正是最活跃、最需要约束的权重。
AdamW 把衰减从梯度中拿出来,直接作用在参数上:
$$ w\leftarrow w-\alpha\Big(\frac{\hat v}{\sqrt{\hat s}+\varepsilon}+\lambda w\Big). $$
衰减比例对每个参数都是 $\alpha\lambda$,与梯度尺度无关。另一个好处是 $\lambda$ 与 $\alpha$ 的作用分开了,两者可以分别调。PyTorch 中 AdamW 的默认 weight_decay=0.01,乘的是当前学习率,所以学习率衰减时权重衰减也一起变小。
1 | def adam_init(params): |
PyTorch 中的对应写法:
1 | import torch |
torch.optim.SGD(momentum=β)用的是鱼书的写法:$v\leftarrow\beta v+g$,$W\leftarrow W-\alpha v$,没有 $(1-\beta)$。要与 CS230 公式在同一个 $\alpha$ 下等价,PyTorch 的学习率应取 $\alpha(1-\beta)$,这正是前面说的“超参数不能直接照抄”。RMSprop的平滑系数叫alpha(默认 $0.99$),不是学习率。Adam(weight_decay=λ)是把 $\lambda W$ 加进梯度(经过二阶矩缩放),AdamW(weight_decay=λ)才是解耦衰减。- 一个优化器只应创建一次。若在训练循环里反复新建,$v,s$ 和步数 $t$ 每步都被清零,Adam 就退化成每步都按 $t=1$ 做偏差修正。
用上面的 adam_update 与 torch.optim.Adam 逐步对拍,并验证 AdamW 的解耦写法:
1 | def adamw_update(params, grads, v, s, t, lr, wd, beta1=0.9, beta2=0.999, eps=1e-8): |
PyTorch 内部先算分母 $\sqrt{s}/\sqrt{1-\beta_2^t}+\varepsilon$(即 $\sqrt{\hat s}+\varepsilon$),再用步长 $\alpha/(1-\beta_1^t)$ 乘 $v$,与上面的公式逐项相同;AdamW 则在这一步之前先执行 $w\leftarrow(1-\alpha\lambda)w$,与 adamw_update 的顺序一致。
选哪个
▸例7 MNIST 上四种方法的比较(鱼书 6.1.8 节)
5 层网络,每层 100 个 ReLU 神经元。Momentum、AdaGrad、Adam 的损失下降速度大致相同,都明显快于 SGD;细看 AdaGrad 稍快一点。结果会随学习率等超参数和网络结构而变化,但一般而言,后三者比 SGD 学得快,有时最终精度也更高。
- 不存在在所有问题上都最好的方法,各自有擅长和不擅长的问题。
- AdaGrad:历史平方梯度一直累加,学习率单调下降,后期可能过早停止。
- RMSprop:用滑动平均避免 AdaGrad 的过早停止。
- Adam = Momentum + RMSprop,但不是“一定最好”。视觉分类上,调好的 SGD + Momentum 仍常与 Adam 打平或更好。
- Adam 对初始 $\alpha$ 更宽容,适合作业与项目起步。
学习率衰减
训练初期离最优点远,可以走大步;后期接近最优点,大步会在最小值附近来回跳,需要减小步长。常见的衰减方式:
$$ \alpha_t=\frac{\alpha_0}{1+\delta\,\mathrm{epoch}},\qquad \alpha_t=\alpha_0\cdot 0.95^{\mathrm{epoch}},\qquad \alpha_t=\frac{k\alpha_0}{\sqrt{t}}. $$
第一种是反比衰减($\delta$ 为衰减率),第二种是指数衰减,第三种按迭代次数的平方根衰减。另外还有阶梯式衰减和手动衰减。
1 | def lr_inverse(alpha0, epoch, decay_rate=1.0): |
PyTorch 用调度器(scheduler)包住优化器,每个 epoch(或每步)调用一次 step():
1 | from torch.optim.lr_scheduler import LambdaLR, ExponentialLR, CosineAnnealingLR |
- Transformer 中更常见:余弦退火、线性 warmup 后衰减。
- $\alpha$ 过大:损失爆炸或震荡;过小:下降极慢,易停在尖锐区域。
- 一个实用做法是先找使损失开始发散的 $\alpha$,再取它的 $1/3$ 到 $1/10$。
- 损失仍陡降时不要过早衰减 $\alpha$;先用常数 $\alpha$ 观察到平台,再衰减。
- $\alpha$ 衰减与 early stopping 同时打开时,dev 变好可能只是步长变小,不一定是泛化改善。
局部最优与鞍点
- 低维直觉里,优化最怕陷入局部最优。但在高维空间中,梯度为零的点要成为局部最小值,需要所有方向都向上弯,这概率极低;绝大多数梯度为零的点是鞍点(有的方向向上、有的向下)。
- 真正拖慢训练的是平台(plateau):梯度长时间接近 0 的大片区域。Momentum、Adam 等方法和 mini-batch 的随机噪声都有助于更快地离开平坦区。
- Batch 过小:噪声过大;过大:泛化有时变差。要与学习率线性缩放等经验规则一起调。
▸衔接
优化器决定了参数怎么走,但每层激活的分布仍会随前面层的参数更新而漂移,使得对初始化和学习率都很敏感。下一节用 BatchNorm 把每层激活的分布强制拉回合适的范围。
批归一化(Batch Normalization)
动机
初始化一节说明:各层激活值的分布有适当的广度,训练才能顺利。初始化只能保证开始时如此;训练开始后,参数不断变化,各层分布也跟着变。BatchNorm 的思路很直接:既然需要合适的分布,就在每层强制调整一次。
▸BatchNorm
BatchNorm(Ioffe & Szegedy, 2015)对当前 batch 的预激活做标准化,再乘 $\gamma$、加 $\beta$。没有 $\gamma,\beta$,一层只能输出近似零均值、单位方差的量。训练用当批统计,推理改用训练期累积的 running mean / variance,并仍然使用 $\gamma,\beta$。batch 统计带噪声,有轻微正则作用,但不能代替 Dropout 或 $L_2$。
论文给出的动机是内部协变量偏移(internal covariate shift):下层参数一更新,上层看到的输入分布就跟着变,上层要不断适应新分布。BatchNorm 用标准化把每层的尺度固定下来,学习率因而可以更大。论文把这当作动机;实践上更常观察到的是损失曲面变得更平滑好走、对初始化不那么敏感。
BatchNorm 的三个优点:
- 学习更快(可以使用更大的学习率);
- 不那么依赖初始值;
- 抑制过拟合(降低 Dropout 等的必要性)。
算法
对当前 mini-batch 的每个特征维(全连接:每个神经元;卷积:每个通道),先标准化为均值 0、方差 1:
$$ \mu=\frac{1}{n_b}\sum_{i}z^{(i)},\qquad \sigma^{2}=\frac{1}{n_b}\sum_{i}(z^{(i)}-\mu)^{2},\qquad \tilde{z}=\frac{z-\mu}{\sqrt{\sigma^{2}+\varepsilon}}. $$
$\varepsilon$ 是防止除零的小常数。然后做可学习的缩放和平移:
$$ z_{\mathrm{BN}}=\gamma\odot\tilde{z}+\beta. $$
- $\gamma,\beta$ 可学习,初始 $\gamma=1$、$\beta=0$。
- 为什么需要 $\gamma,\beta$:强制均值 0、方差 1 不一定是最好的分布(例如 sigmoid 在 0 附近近似线性,非线性就浪费了)。若 $\gamma=\sqrt{\sigma^{2}+\varepsilon}$,$\beta=\mu$,可以还原为恒等映射,所以 BatchNorm 不损失一层的表示能力,由网络自己决定要多大的均值和方差。
- 加入 BatchNorm 后,$b$ 与 $\beta$ 冗余(减均值会把 $b$ 抵消),实现中常省略 $b$。
- 位置:通常插在 Affine 之后、激活函数之前,即 Affine → BatchNorm → ReLU。也有放在激活之后的做法,文献中都有讨论。
训练与推理
- 训练:用当前 batch 的 $\mu,\sigma^2$。
- 推理:可能一次只来一个样本,无法计算 batch 统计(batch 大小为 1 时 $\sigma^{2}=0$)。因此训练时同时维护运行平均,推理时使用它:
$$ \bar{\mu}\leftarrow \eta\bar{\mu}+(1-\eta)\mu_{\mathrm{batch}}, $$
$\eta$ 如 $0.9$,$\bar{\sigma}^2$ 同理。评估模式必须切换到运行统计量,否则行为与训练不一致。
▸BatchNorm 的反向要点
$\partial J/\partial z$ 不能只通过 $\gamma/\sqrt{\sigma^{2}+\varepsilon}$ 缩放,因为 $\mu$ 与 $\sigma^{2}$ 也依赖 batch 内每个 $z^{(i)}$。完整 Jacobian 含三项:经 $\tilde{z}$ 的直接路径、经 $\mu$ 的路径、经 $\sigma^{2}$ 的路径。框架会自动求导;手写时需对这三项求和。$\gamma,\beta$ 的梯度是 $\partial J/\partial z_{\mathrm{BN}}$ 分别与 $\tilde{z}$、$1$ 的 batch 求和。画出计算图再逐节点反向推导会清楚得多(参见 Frederik Kratzert 的博客 Understanding the backward pass through Batch Normalization Layer)。
1 | def batchnorm_forward(Z, gamma, beta, cache_bn, eps=1e-8, momentum=0.9, train=True): |
上面的反向可以化简成一行。推导只看一个特征维(一行),batch 内有 $m$ 个样本,记 $\tilde\sigma=\sqrt{\sigma^2+\varepsilon}$,$\hat z_i=(z_i-\mu)/\tilde\sigma$。
第一步,两个统计量对每个输入的导数:
$$ \frac{\partial\mu}{\partial z_j}=\frac1m,\qquad \frac{\partial\sigma^2}{\partial z_j}=\frac2m(z_j-\mu),\qquad \frac{\partial\tilde\sigma}{\partial z_j}=\frac{1}{2\tilde\sigma}\cdot\frac2m(z_j-\mu)=\frac{\hat z_j}{m}. $$
求 $\partial\sigma^2/\partial z_j$ 时,$\mu$ 也依赖 $z_j$,但那一项是 $-\frac2m\sum_i(z_i-\mu)\cdot\frac1m=0$,因为偏差之和为零。
第二步,$\hat z_i$ 对 $z_j$ 的导数(商的求导法则,分子分母都依赖 $z_j$):
$$ \frac{\partial\hat z_i}{\partial z_j} =\frac{1}{\tilde\sigma}\Big(\delta_{ij}-\frac1m\Big)-\frac{z_i-\mu}{\tilde\sigma^2}\cdot\frac{\hat z_j}{m} =\frac{1}{\tilde\sigma}\Big(\delta_{ij}-\frac1m-\frac{\hat z_i\hat z_j}{m}\Big). $$
三项分别对应三条路径:直接路径 $\delta_{ij}$,经过 $\mu$ 的路径 $-\frac1m$,经过 $\sigma$ 的路径 $-\frac{\hat z_i\hat z_j}{m}$。
第三步,链式法则,$\mathrm d\hat z_i=\gamma\,\mathrm dy_i$,对 $i$ 求和:
$$ \mathrm dz_j=\sum_i\mathrm d\hat z_i\frac{\partial\hat z_i}{\partial z_j} =\frac{1}{\tilde\sigma}\Big(\mathrm d\hat z_j-\frac1m\sum_i\mathrm d\hat z_i-\hat z_j\cdot\frac1m\sum_i\mathrm d\hat z_i\hat z_i\Big) =\frac{\gamma}{m\tilde\sigma}\Big(m\,\mathrm dy_j-\sum_i\mathrm dy_i-\hat z_j\sum_i\mathrm dy_i\hat z_i\Big). $$
括号里是上游梯度减去它的均值分量、再减去它在 $\hat z$ 方向上的分量。所以 $\mathrm dz$ 满足 $\sum_j\mathrm dz_j=0$ 和 $\sum_j\mathrm dz_j\hat z_j=0$。这有直观的原因:把所有 $z_j$ 加同一个常数,或整体乘一个正数,BN 的输出不变,所以梯度在这两个方向上的分量必然为零。$\sum_i\mathrm dy_i$ 与 $\sum_i\mathrm dy_i\hat z_i$ 正好是 $\mathrm d\beta$ 与 $\mathrm d\gamma$,可以直接复用。写成矩阵形式:
$$ \mathrm{d}Z=\frac{\gamma}{m\sqrt{\sigma^{2}+\varepsilon}}\Big(m\,\mathrm{d}\hat{Z}'-\textstyle\sum_j \mathrm{d}\hat{Z}'_{\cdot j}-\hat{Z}\odot\sum_j\big(\mathrm{d}\hat{Z}'\odot\hat{Z}\big)_{\cdot j}\Big), $$
其中 $\mathrm{d}\hat{Z}'$ 即 d_out,求和沿 batch 维:
1 | def batchnorm_backward_compact(d_out, cache): |
PyTorch 的 nn.BatchNorm1d 按行样本沿第 0 维求统计量,model.train() / model.eval() 决定用 batch 统计还是运行平均:
1 | import torch.nn as nn |
- PyTorch 训练时用有偏方差(除以 $m$)做标准化,但更新
running_var时用无偏方差(除以 $m-1$)。与自己的 NumPy 实现对拍时,要注意这一点差异。 - 忘记
model.eval()是推理结果随 batch 组成而变的最常见原因。
▸例8 BatchNorm 的效果(鱼书 6.3.2 节)
在 MNIST 上比较有无 BatchNorm 的训练准确率:使用 BatchNorm 后学习明显更快。再把权重初始标准差从 $1.0$ 到 $0.0001$ 取 16 个值分别实验:几乎所有情况下有 BatchNorm 都学得更快;而没有 BatchNorm 时,初始尺度不合适,学习完全无法进行。这直接体现了“对初始值健壮”。
局限与替代
- 效果:学习率可以更大;对初始化不那么敏感;本身带轻微正则(batch 统计带噪声)。
- 小 batch 时统计不可靠:改用 LayerNorm(layer normalization)、GroupNorm,或增大 batch。
- RNN 中 BatchNorm 不如 LayerNorm 常见。
- 稳定深层训练的其他工具:softmax 温度、梯度裁剪(gradient clipping)、残差连接与归一化。
▸对照:BatchNorm 与 LayerNorm
- BatchNorm:沿 batch 维求统计量;训练用 batch 统计,推理用运行平均。
- LayerNorm:沿特征维求统计量(每个样本自己归一化);训练与推理公式相同。
- 全连接与卷积网络常用 BatchNorm;RNN 与 Transformer 常用 LayerNorm。
- 小 batch 时 BatchNorm 统计不可靠。
归一化家族
统一的写法
BatchNorm、LayerNorm、InstanceNorm、GroupNorm 的公式完全相同,唯一的区别是在哪些维度上求均值和方差。以卷积特征图 $x\in\mathbb R^{N\times C\times H\times W}$(batch、通道、高、宽)为例,选定一个维度集合 $\mathcal S$:
$$ \mu=\frac{1}{\lvert\mathcal S\rvert}\sum_{\mathcal S}x,\qquad \sigma^2=\frac{1}{\lvert\mathcal S\rvert}\sum_{\mathcal S}(x-\mu)^2,\qquad y=\gamma_c\,\frac{x-\mu}{\sqrt{\sigma^2+\varepsilon}}+\beta_c. $$
| 方法 | 求统计的维度 $\mathcal S$ | 每组统计用多少个数 | 依赖 batch | 训练与推理相同 | 典型场景 |
|---|---|---|---|---|---|
| BatchNorm | $N,H,W$(每个通道一组) | $NHW$ | 是 | 否,推理用运行平均 | CNN,batch 较大 |
| LayerNorm | $C,H,W$(每个样本一组) | $CHW$ | 否 | 是 | Transformer、RNN |
| InstanceNorm | $H,W$(每个样本的每个通道一组) | $HW$ | 否 | 是 | 风格迁移、图像生成 |
| GroupNorm | 每个样本内,$C/G$ 个通道一组,再加 $H,W$ | $\frac{C}{G}HW$ | 否 | 是 | 检测、分割等小 batch 任务 |
GroupNorm 是 LN 与 IN 之间的连续谱:$G=1$ 时所有通道一组,就是 LayerNorm;$G=C$ 时每个通道一组,就是 InstanceNorm。缩放参数 $\gamma,\beta$ 在四种方法中都是每个通道一个,共 $2C$ 个参数。
Transformer 里的张量是 $(N,T,d)$(batch、序列位置、特征),LayerNorm 只在最后一维 $d$ 上求统计:每个 token 自己归一化,与 batch 中其他句子、同一句的其他位置都无关。
▸同一个矩阵上的 BN 与 LN
2 个样本、3 个特征(行是样本),第二个样本恰好是第一个的 3 倍:
$$ X=\begin{pmatrix}1&2&3\\3&6&9\end{pmatrix}. $$
BatchNorm 按列(每个特征在 2 个样本上求统计)。第 1 列均值 2、标准差 1;第 2 列均值 4、标准差 2;第 3 列均值 6、标准差 3。结果
$$ \mathrm{BN}(X)=\begin{pmatrix}-1&-1&-1\\1&1&1\end{pmatrix}. $$
各特征原本的尺度差异($1,2,3$ 与 $3,6,9$)被抹掉,剩下的只是“这个样本在这个特征上比 batch 平均大还是小”。
LayerNorm 按行(每个样本在 3 个特征上求统计)。第 1 行均值 2、方差 $2/3$;第 2 行均值 6、方差 $6$。结果
$$ \mathrm{LN}(X)=\begin{pmatrix}-1.22&0&1.22\\-1.22&0&1.22\end{pmatrix}. $$
两个样本的输出完全相同:LN 去掉了“整体有多大”,只保留“各特征之间的相对模式”。第二个样本是第一个的 3 倍,这个信息被 LN 丢掉了,被 BN 保留了(体现为两行符号相反)。选哪种归一化,就是在选“哪种差异对任务无关、可以丢掉”。
为什么各有各的位置
BatchNorm。统计量来自 $NHW$ 个数,在 CNN 中通常有几万个,估计准,带来的噪声恰好起到正则作用。它的问题都来自对 batch 的依赖:
- batch 很小(每张卡 1 到 2 张图,检测和分割中常见)时,均值方差的估计噪声太大,精度明显下降;
- 训练用 batch 统计、推理用运行平均,两者不一致;训练数据和测试数据分布不同时更明显;
- 多卡训练时每张卡各算各的统计,需要
SyncBatchNorm才能用到全局 batch; - RNN 每个时间步的统计不同,变长序列难以处理。
LayerNorm。每个样本、每个 token 自己算,与 batch 大小、序列长度都无关,训练和推理完全一样,所以成了 Transformer 和 RNN 的标准选择。用在 CNN 上效果一般:它把所有通道放在一起归一化,假设各通道尺度相近,而卷积网络不同通道的激活尺度往往差别很大。
InstanceNorm。对每张图的每个通道单独去均值、除标准差。风格迁移的研究发现,一个通道在空间上的均值和方差主要编码了“风格”(对比度、色调、笔触强弱),去掉它们就去掉了原图的风格,生成网络更容易换上新风格。AdaIN 把这一点直接写成公式:$\mathrm{AdaIN}(x,y)=\sigma(y)\frac{x-\mu(x)}{\sigma(x)}+\mu(y)$,用风格图 $y$ 的统计量替换内容图 $x$ 的统计量。分类任务中它会丢掉有用的全局信息,一般不用。
GroupNorm(Wu & He, 2018)。把通道分组(默认 $G=32$),每组内的通道往往编码相关的特征(例如不同方向的边缘),一起归一化比 LN 的“全部一起”更合理,又比 IN 的“各自为政”保留更多信息。它不依赖 batch:在 batch 为 2 时,ResNet-50 的 ImageNet 错误率比 BN 低约 10 个百分点;batch 大时与 BN 相当。
RMSNorm
LayerNorm 做两件事:减均值(re-centering)和除尺度(re-scaling)。Zhang & Sennrich(2019)发现起作用的主要是后者,于是去掉减均值,也去掉 $\beta$:
$$ \mathrm{RMS}(x)=\sqrt{\frac1d\sum_{j=1}^{d}x_j^2+\varepsilon},\qquad y=\gamma\odot\frac{x}{\mathrm{RMS}(x)}. $$
- 少算一次均值、少一组参数,在大模型中能省下可观的时间;
- 当 $x$ 的均值恰好为 $0$ 时,RMS 就是标准差,RMSNorm 与 LayerNorm 相同;
- LLaMA、T5 等大语言模型使用 RMSNorm。
反向推导与 BN 类似,记 $r=\mathrm{RMS}(x)$、$u=\gamma\odot\mathrm dy$,用 $\partial r/\partial x_j=x_j/(dr)$:
$$ \mathrm dx_j=\frac{u_j}{r}-\frac{x_j}{d\,r^3}\sum_i u_ix_i. $$
与 BN 的结果对照:少了“减去均值分量”那一项(因为前向没有减均值),只剩“减去沿 $x$ 方向的分量”,所以 $\sum_j\mathrm dx_j x_j\approx 0$:把 $x$ 整体放大,输出不变,梯度在这个方向上为零。
归一化权重而不是激活
另一类方法不碰激活,直接约束权重:
- Weight Normalization:把权重向量写成 $w=g\,\frac{v}{\lVert v\rVert}$,方向 $v/\lVert v\rVert$ 与长度 $g$ 分开学习。没有 batch 依赖,也没有运行统计,但通常不如 BN 稳。
- Spectral Normalization(Miyato et al., 2018):用 $W/\sigma_{\max}(W)$ 代替 $W$,$\sigma_{\max}$ 是最大奇异值。这样每一层都是 1-Lipschitz 的:输入变化 $\delta$,输出变化不超过 $\lVert\delta\rVert$。GAN 的判别器常用它防止梯度过大、训练发散。$\sigma_{\max}$ 不需要做完整 SVD,用幂迭代每步迭代一次即可。
尺度不变性与有效学习率
BN 带来一个容易被忽略的性质。设一层权重为 $W$,后面接 BN。把 $W$ 乘以任意正数 $c$,预激活整体乘 $c$,BN 减均值除标准差后输出不变:
$$ \mathrm{BN}(cWx)=\mathrm{BN}(Wx),\qquad\text{所以}\quad L(cW)=L(W). $$
两边对 $W$ 求导:$c\,\nabla L(cW)=\nabla L(W)$,即 $\nabla L(cW)=\frac1c\nabla L(W)$:权重越大,梯度越小。另外,对 $L(cW)=L(W)$ 关于 $c$ 求导并令 $c=1$,得 $\langle\nabla L(W),W\rangle=0$,梯度总是与 $W$ 正交。
这两条合起来有两个推论:
- SGD 的一步 $W\leftarrow W-\alpha\nabla L$ 沿正交方向走,由勾股定理 $\lVert W\rVert$ 只增不减。权重越来越大,梯度越来越小,真正起作用的角度变化约为 $\alpha\lVert\nabla L\rVert/\lVert W\rVert\propto\alpha/\lVert W\rVert^2$,有效学习率随训练自动下降。
- 对 BN 前面的权重做权重衰减,几乎不改变函数(尺度不影响输出),主要作用是让 $\lVert W\rVert$ 保持较小,维持有效学习率。所以在 BN 网络里,权重衰减的作用更像调学习率,而不是传统意义上的正则。这也是 BN 网络中 $\lambda$ 与 $\alpha$ 需要一起调的原因。
部署时把 BN 折叠进卷积
推理时 BN 用的是固定的 $\bar\mu,\bar\sigma^2$,它就是一个逐通道的仿射变换,可以并入前面的卷积或全连接层。对输出通道 $c$:
$$ \gamma_c\frac{(W_c*x+b_c)-\bar\mu_c}{\sqrt{\bar\sigma_c^2+\varepsilon}}+\beta_c =\underbrace{\frac{\gamma_c}{\sqrt{\bar\sigma_c^2+\varepsilon}}W_c}_{W_c'}*x+\underbrace{\frac{\gamma_c(b_c-\bar\mu_c)}{\sqrt{\bar\sigma_c^2+\varepsilon}}+\beta_c}_{b_c'}. $$
折叠后网络少了一层,推理更快,结果在浮点误差内不变。移动端部署框架都会自动做这一步。LN 和 GN 的统计量依赖每个输入,不能这样折叠。
放在哪里
- CNN:
Conv → BN → ReLU,BN 前面的卷积不需要偏置;残差块中,最后一个 BN 的 $\gamma$ 初始化为 $0$,可以让每个残差块一开始等于恒等映射,深层网络更容易训练。 - Transformer:Post-LN 写成 $x_{l+1}=\mathrm{LN}(x_l+F(x_l))$,原论文结构;Pre-LN 写成 $x_{l+1}=x_l+F(\mathrm{LN}(x_l))$。Pre-LN 展开后 $x_L=x_0+\sum_{l}F_l(\cdot)$,从输出到任何一层都有一条不经过 LN 的恒等路径,$\partial x_L/\partial x_l$ 中总有一项单位阵,深层时梯度更稳,可以少用甚至不用 warmup;Post-LN 每一层的梯度都要穿过 LN,层数多时需要仔细的 warmup。现代大模型几乎都用 Pre-LN(常配 RMSNorm),最后再加一个 LN。
如何选择
| 场景 | 推荐 |
|---|---|
| CNN 分类,每卡 batch $\ge16$ | BatchNorm |
| 检测、分割、视频,每卡 batch 很小 | GroupNorm($G=32$),或 SyncBatchNorm |
| Transformer、RNN、变长序列 | LayerNorm;大模型用 RMSNorm |
| 风格迁移、图像生成器 | InstanceNorm / AdaIN |
| GAN 判别器 | Spectral Normalization |
| 不想要训练与推理的差异 | 任何不依赖 batch 的方法(LN、GN、RMSNorm) |
实现与核对
一个函数实现四种归一化,只改求统计的轴;再分别和 PyTorch 对拍:
1 | def normalize(x, axes, gamma, beta, eps=1e-5): |
LayerNorm 在 PyTorch 中的 weight 形状是 normalized_shape,即 $(C,H,W)$ 每个位置一个,而不是每个通道一个;上面为了与其他三种比较,用逐通道的 $\gamma$ 在外面手动缩放。Transformer 中 nn.LayerNorm(d) 的 $\gamma$ 是 $d$ 维,两种说法在那里一致。
BN 折叠与谱归一化的幂迭代:
1 | def fold_bn(conv: nn.Conv2d, bn: nn.BatchNorm2d): |
PyTorch 中谱归一化是 nn.utils.parametrizations.spectral_norm(layer),每次前向自动做一步幂迭代并把权重除以 $\sigma_{\max}$。
▸衔接
初始化、优化器和 BatchNorm 一起保证训练误差能降下来。但训练误差低不等于模型好:若开发集误差明显更高,模型只是记住了训练集。下一节讨论如何诊断并缩小这个差距。
正则化(Regularization)
问题
机器学习的目标是泛化:对训练时没见过的数据也能预测正确。只能拟合训练数据、不能拟合其他数据的状态称为过拟合(overfitting)。过拟合主要有两个原因:
- 模型参数多、表现力强;
- 训练数据少。
正则化用来缩小训练误差与开发集误差的差距:在损失上加惩罚,或在前向中注入噪声,使模型少拟合训练集中的偶然细节。它不管损失降不降得下去,那是优化的事。正则改的是损失或计算图,优化改的是参数沿梯度怎么走,两件事不要混在一次实验里。
▸例9 人为制造过拟合(鱼书 6.4.1 节)
从 MNIST 的 6 万个训练样本中只取 300 个,用 7 层网络(每层 100 个 ReLU 神经元)、学习率 0.01 的 SGD 训练 200 个 epoch。约 100 个 epoch 后,训练集准确率几乎达到 100%,但测试集准确率与之相差很大——模型只拟合了训练数据。后面的权值衰减和 Dropout 都以这个实验为对照。
偏差与方差
先诊断再开药。以可达到的最优误差(Bayes 误差,或用人类水平近似)为基准:
- 偏差(bias / underfitting):训练误差明显高于最优误差,模型连训练集都没学好。
- 方差(variance / overfitting):开发集误差明显高于训练误差,模型学到了训练集特有的细节。
- 数据不匹配:开发集分布与训练分布不同,即使方差小也会差(见“项目策略”)。
CS230 的实用判据(分类误差,最优误差接近 0 时):
| 训练误差 | Dev 误差 | 诊断 |
|---|---|---|
| 高 | 高且接近训练 | 偏差:更大网络、更久训练、更好优化、换特征 |
| 低 | 高 | 方差:更多数据、正则、简化模型 |
| 高 | 更高 | 偏差与方差同时存在 |
| 低 | 低 | 接着核对 test 与部署分布是否仍一致 |
- “更大网络一定过拟合”并不成立。足够大的网络配合正则与早停(early stopping),常常同时降低训练与 dev 误差。
- 顺序是:先保证模型能装下训练数据(降偏差),再压方差。
$L_2$ 权重衰减(weight decay)
▸$L_2$
$L_2$ 正则在损失上加 $\|W\|_F^{2}$。梯度多一项 $\lambda W/m$,更新等价于每次把 $W$ 乘以略小于 1 的因子,所以也叫权重衰减。偏置通常不惩罚。$\lambda$ 过大会欠拟合。
很多过拟合是因为权重取值过大。权重衰减在损失上加一项惩罚大权重:
$$ J_{\mathrm{reg}}=J+\frac{\lambda}{2m}\sum_{l}\|W^{[l]}\|_F^{2}. $$
$\|W\|_F^{2}=\sum_{i,j}W_{ij}^{2}$(Frobenius 范数,即所有元素的平方和)。$\lambda$ 控制正则强度,越大对大权重的惩罚越重;系数 $\frac{1}{2}$ 是为了让求导结果干净。偏置通常不惩罚。
梯度多一项 $\lambda W^{[l]}/m$,更新等价于
$$ W\leftarrow\left(1-\frac{\alpha\lambda}{m}\right)W-\alpha\,\mathrm{d}W_{\mathrm{data}}. $$
- 权重每次先被乘以一个略小于 1 的因子,再做普通梯度更新,故称 weight decay。
- 为什么能抑制过拟合:权重变小后,激活更可能落在 tanh / sigmoid 的近似线性区,每层更接近线性,整个网络的有效复杂度降低。
- $\lambda$ 过大则欠拟合。
- 范数的其他选择:$L_1$ 范数(各元素绝对值之和 $|w_1|+\dots+|w_n|$)倾向产生稀疏权重;$L_\infty$ 范数(Max 范数,取绝对值最大的元素)。CS230 作业以 $L_2$ 为主。
CS230 速查表把权重正则的三种常见写法并列($\theta$ 为全部权重,$\lambda\ge 0$):
| 名称 | 加到损失上的项 | 效果 |
|---|---|---|
| LASSO($L_1$) | $\lambda\lVert\theta\rVert_1$ | 把一部分系数压到恰好为 $0$,相当于做特征选择 |
| Ridge($L_2$) | $\lambda\lVert\theta\rVert_2^{2}$ | 所有系数整体缩小,但一般不为 $0$ |
| Elastic Net | $\lambda\big[(1-\alpha)\lVert\theta\rVert_1+\alpha\lVert\theta\rVert_2^{2}\big]$,$\alpha\in[0,1]$ | 在“稀疏”与“整体缩小”之间折中 |
$L_1$ 产生稀疏的原因在于梯度:$\partial|\theta_j|/\partial\theta_j=\mathrm{sign}(\theta_j)$,无论 $\theta_j$ 多小,都以固定大小把它往 $0$ 推;$L_2$ 的梯度 $2\theta_j$ 随 $\theta_j$ 变小而变小,只会让它越来越接近 $0$,却很少恰好等于 $0$。深度网络中 $L_1$ 用得少,因为稀疏权重在 GPU 上并不能自动变快;需要压缩模型时更常用剪枝或蒸馏。
课程中出现的各种范数及其用途:
| 范数 | 定义 | 梯度(次梯度) | 课程中的用途 |
|---|---|---|---|
| $L_1$ | $\sum_j\lvert w_j\rvert$ | $\mathrm{sign}(w)$ | 稀疏正则、MAE |
| $L_2$ | $\sqrt{\sum_j w_j^2}$ | $w/\lVert w\rVert_2$ | 梯度裁剪、嵌入归一化、triplet 距离 |
| $L_2^2$ | $\sum_j w_j^2$ | $2w$ | 权重衰减、MSE |
| $L_\infty$ | $\max_j\lvert w_j\rvert$ | 只在最大的分量上为 $\pm1$ | 对抗扰动的约束球(FGSM、PGD) |
| Frobenius | $\sqrt{\sum_{ij}W_{ij}^2}$ | $W/\lVert W\rVert_F$ | 矩阵的 $L_2$,权重衰减 |
| 谱范数 | $\sigma_{\max}(W)$ | $u_1v_1^{\top}$(最大奇异向量) | 谱归一化、Lipschitz 常数 |
梯度裁剪(gradient clipping)用的就是 $L_2$ 范数:所有参数的梯度拼成一个长向量,若总范数超过阈值 $c$,整体按比例缩小到 $c$,方向不变。
$$ g\leftarrow g\cdot\min\Big(1,\frac{c}{\lVert g\rVert_2}\Big). $$
1 | def clip_grad_norm(grads, max_norm): |
按范数裁剪保留了梯度方向;按值裁剪(clip_grad_value_,每个分量单独截断到 $[-c,c]$)会改变方向,一般不如前者。RNN 和 Transformer 训练中几乎总会开启按范数裁剪,返回的 total_norm 也是监控训练是否即将发散的好指标。
▸例10 权值衰减的效果
在例 9 的过拟合实验中加入 $\lambda=0.1$ 的权值衰减:训练集与测试集准确率之间仍有差距,但比不加时小得多;同时训练集准确率不再达到 100%。这正是正则化的典型表现:牺牲一点训练集拟合,换取更好的泛化。
1 | def l2_cost(params, lambda_, m): |
C2M1 Regularization 作业里的 $L_2$
作业用一个三层网络(LINEAR→RELU→LINEAR→RELU→LINEAR→SIGMOID)在二维点集上做分类,比较三种做法:不正则、$L_2$、Dropout。$L_2$ 部分要改两个函数:
- 代价:交叉熵加上 $\frac{1}{m}\frac{\lambda}{2}\sum_l\lVert W^{[l]}\rVert_F^2$,每层用
np.sum(np.square(Wl))(写法与易错点见代码一章的np.square小节)。作业测试用例的期望输出为cost = 1.78648594516。 - 反向:只有 $\mathrm{d}W$ 多一项,$\mathrm{d}b$ 与各层的 $\mathrm{d}Z$、$\mathrm{d}A$ 都不变:
1 | dW3 = 1. / m * np.dot(dZ3, A2.T) + (lambd * W3) / m |
取 $\lambda=0.7$ 训练,结果:
| 模型 | 训练集准确率 | 测试集准确率 |
|---|---|---|
| 不正则 | 94.8% | 91.5% |
| $L_2$($\lambda=0.7$) | 93.8% | 93% |
训练集准确率略降、测试集准确率上升,决策边界不再为了个别训练点绕弯,变得更平滑。作业的观察是:$\lambda$ 是要在 dev 集上调的超参数;$\lambda$ 太大会“过度平滑”(oversmooth),变成高偏差。
What you should remember(notebook 原话)– the implications of L2-regularization on:
- The cost computation: A regularization term is added to the cost
- The backpropagation function: There are extra terms in the gradients with respect to weight matrices
- Weights end up smaller (“weight decay”): Weights are pushed to smaller values.
Dropout
▸Dropout
Dropout(Srivastava et al., 2014):训练时每个神经元以概率 $1-p$ 置零,推理时用全部神经元。作业用 inverted dropout,训练阶段把保留值除以 $p$,使期望与推理一致。它近似许多子网络的平均,不能代替 $L_2$。卷积层权值已共享,通常只加在全连接头。
网络很复杂时,单靠权重衰减难以应对,这时常用 Dropout:训练时随机删除隐藏层的神经元,被删除的神经元不再传递信号。每传入一次数据(每个 mini-batch),都重新随机选择要删除的神经元。
设 $p$ 为保留概率(keep probability)。CS230 作业使用 inverted dropout:
$$ A^{[l]}\leftarrow\frac{D^{[l]}\odot A^{[l]}}{p},\qquad D^{[l]}_{ij}\sim\mathrm{Bernoulli}(p). $$
- 训练时,每个神经元以概率 $1-p$ 被置零,保留下来的值除以 $p$。
- 为什么除以 $p$:保留后激活的期望变成原来的 $p$ 倍,除以 $p$ 把期望拉回原值,这样测试时用全部神经元、不做任何缩放即可。
- 反向:只对保留的位置传梯度,并同样除以 $p$。行为与 ReLU 类似:前向传了信号的神经元,反向原样传梯度;前向被删除的,反向梯度停在那里。
- 鱼书的写法是另一种等价实现:训练时只乘掩码、不缩放,测试时把每个神经元的输出乘以保留比例 $1-\text{dropout_ratio}$。两者期望一致,框架多采用 inverted 版本,因为推理代码不用改。
为什么有效:
- 不能依赖个别神经元:任何一个隐藏单元都可能被删掉,网络只能把特征分散编码在多个单元中。从下一层的某个神经元看,它的任何一个输入都可能消失,所以不能把太多权重押在某一个输入上,只能把权重分散到各个输入上。分散权重会让 $\lVert W\rVert^2$ 变小,与 $L_2$ 收缩权重有相似作用;Andrew Ng 在课上把 Dropout 描述为一种更具适应性的 $L_2$(不同权重受到的收缩程度不同)。
- 集成学习的近似:集成学习(ensemble)训练多个模型、推理时取平均,通常能把精度提高几个百分点。Dropout 每次训练的都是一个随机子网络,相当于训练了指数级多个共享权重的子网络($n$ 个可丢弃的单元对应 $2^n$ 种子网络);推理时用全部神经元、按比例缩放(weight scaling inference rule),近似于对这些子网络的预测取平均。这个近似只在单层线性 + softmax 时是精确的(等于子网络预测的几何平均),多层非线性网络中只是一个经验上效果很好的近似。即用一个网络近似实现了集成学习的效果。
▸例11 Dropout 的效果(鱼书 6.4.3 节)
同样的 7 层网络,加入 dropout 比例 0.15(即保留 85%):训练集与测试集准确率的差距变小,训练集准确率也不再达到 100%。即使是表现力很强的网络,也能用 Dropout 抑制过拟合。
实践要点:
- $p$ 常用:输入层 $0.8$,隐藏层 $0.5$;参数多、易过拟合的层可以用更小的 $p$。
- 卷积层的激活在空间上高度相关:相邻像素的特征几乎一样,逐个像素随机置零后,被删的值很容易由邻居补回来,正则效果弱。常改用空间 Dropout(SpatialDropout,整张特征图一起丢;PyTorch 的
nn.Dropout2d),或只在全连接头使用。 - 与 BatchNorm 同时使用时,二者都在改变激活分布,调参需更小心:训练时 Dropout 改变了激活的方差,推理时关掉 Dropout,BN 用训练时统计的方差就对不上(Li et al., 2019 称为 variance shift)。常见做法是把 Dropout 放在所有 BN 之后,例如只放在最后的分类层前。许多现代卷积架构主要靠 BatchNorm、数据增强与权重衰减。
- 使用 Dropout 后损失函数 $J$ 不再有明确定义(每次前向都不同),调试时先关掉 Dropout(
keep_prob = 1)确认 $J$ 单调下降,再打开。 - 梯度检查时必须关掉 Dropout。 数值梯度要算两次 $J(\theta\pm\varepsilon)$,若每次前向都重新抽掩码,两次 $J$ 来自不同的子网络,差值主要是掩码不同造成的,与梯度无关(下面有可运行的例子)。先用
keep_prob = 1做梯度检查,通过后再打开 Dropout。
1 | def inverted_dropout_forward(A, keep_prob, rng): |
C2M1 Regularization 作业:三层网络的 Dropout
上面两个函数是通用写法;作业要求把 Dropout 直接写进三层网络的前向和反向。只对两个隐藏层 $A^{[1]},A^{[2]}$ 做 Dropout,输入层和输出层都不做。前向每层四步:造随机矩阵 → 与 keep_prob 比较得到 0/1 掩码 → 乘掩码关掉一部分神经元 → 除以 keep_prob。掩码 $D^{[1]},D^{[2]}$ 要存进 cache,反向时用的必须是同一张:
1 | import numpy as np |
逐行要注意的几处:
- 用
rand不用randn。 掩码要的是“以概率keep_prob为 1”:$[0,1)$ 上的均匀随机数小于keep_prob的概率正好是keep_prob。用正态的randn时,这个概率是 $\Phi(\text{keep_prob})$,不对。 - 形状与 $A$ 相同。 每个样本、每个神经元各自抽一次,所以同一个神经元在不同样本上可能一个保留、一个被关掉。
- 布尔掩码可以直接乘。
D1 < keep_prob得到布尔数组,与浮点数相乘时True当 1、False当 0;要显式得到整数可以写(D1 < keep_prob).astype(int)。 - 反向判断 ReLU 的正区间时用的是除过
keep_prob的A1。 被关掉的位置A1 = 0,(A1 > 0)也是 0,与乘掩码的结果一致;保留的位置除以正数不改变符号,所以与用 $Z^{[1]}>0$ 判断等价。 - 反向乘掩码与 ReLU 导数的顺序无所谓:两者都是逐元素乘,交换顺序结果相同(作业一章的
backward_relu_dropout就是先做 ReLU 再乘掩码)。
作业用 keep_prob = 0.86、learning_rate = 0.3 训练。每次迭代里,第 1、2 层的每个神经元以 $1-0.86=14\%$ 的概率被关掉(notebook 正文写作 24%,按 $1-\text{keep_prob}$ 应为 14%)。三种做法放在一起:
| 模型 | 训练集准确率 | 测试集准确率 |
|---|---|---|
| 不正则 | 94.8% | 91.5% |
| $L_2$($\lambda=0.7$) | 93.8% | 93% |
Dropout(keep_prob = 0.86) |
92.9% | 95% |
正则化都会让训练集准确率下降:它限制了网络对训练集的过拟合能力。但测试集准确率上升,所以对整个系统是有利的。
两个可以直接运行的检查(沿用上面两个函数):
1 | # 检查 1:inverted dropout 不改变激活的期望 |
第二个检查说明了为什么梯度检查前要先把 Dropout 关掉(或固定掩码):$J(\theta+\varepsilon)$ 和 $J(\theta-\varepsilon)$ 来自不同的子网络,二者之差主要由掩码不同造成,除以 $2\varepsilon$ 之后被放大成一个巨大的、毫无意义的数。
▸作业强调的常见错误
A common mistake when using dropout is to use it both in training and testing.(notebook 原话)只在训练时随机删节点;预测、计算 dev/test 准确率时调用的是不带 Dropout 的 forward_propagation。
What you should remember about dropout(notebook 原话):
- Dropout is a regularization technique.
- You only use dropout during training. Don’t use dropout (randomly eliminate nodes) during test time.
- Apply dropout both during forward and backward propagation.
- During training time, divide each dropout layer by keep_prob to keep the same expected value for the activations.
PyTorch 的 nn.Dropout(p) 中 p 是丢弃概率,即 CS230 的 $1-\text{keep_prob}$;它同样是 inverted 实现,eval() 时直接恒等:
1 | drop = nn.Dropout(p=0.2) # keep_prob = 0.8 |
$L_2$ 在 PyTorch 里通常不写进损失,而是交给优化器的 weight_decay。只惩罚 $W$、不惩罚 $b$ 时,要把参数分组:
1 | decay, no_decay = [], [] |
SGD 的 weight_decay=w 等价于在损失里加 $\frac{w}{2}\lVert W\rVert^{2}$。对应 CS230 的 $\frac{\lambda}{2m}\lVert W\rVert^{2}$,取 $w=\lambda/m$。
- 训练时 Dropout 必须开启,推理必须关闭。Keras/TF 用
training=切换;推理时若仍除以 $p$ 且随机置零,dev 准确率会无故抖动。 - Inverted dropout 的除以 $p$ 只属于训练分支。
- $L_2$ 与 Dropout 可以叠加,但二者都在压有效容量;同时把 $\lambda$ 和 $1-p$ 开到很大,会回到欠拟合。
- 正交化:先用更大网络把训练误差降下来,再加一种正则观察 dev。
其他正则
- 数据增强(data augmentation):从已有数据中生成更多数据,是“免费”的样本。图像可以翻转、旋转、随机裁剪、颜色偏移、加噪声、遮挡部分区域、改变对比度;文本可以同义改写。增强通常在训练时实时(on the fly)进行。
增强必须保持标签语义:分类可以水平翻转,但检测框坐标要跟着翻转;文字与左右不对称的医学影像不能盲目翻转;水平翻转车牌会破坏字符顺序。
增强过猛等于换了数据分布;dev 若未增强会出现人为的分布不匹配。
CS230 速查表按“模拟哪一种真实变化”列出图像增强:
变换 做法 模拟的真实情况 翻转(flip) 沿不改变语义的轴翻转 左右镜像的同类物体 旋转(rotation) 小角度旋转 拍摄时地平线没放平 随机裁剪(random crop) 随机聚焦图像的一部分,可连续裁多次 物体位置、取景范围不同 颜色偏移(color shift) 轻微改变 RGB 各通道 光照、曝光带来的色偏 加噪声(noise addition) 叠加随机噪声 输入质量参差(传感器噪声、压缩) 信息丢失(information loss) 随机遮掉图像的一部分 物体被部分遮挡 对比度变化(contrast change) 调整亮度与对比度 一天中不同时段的曝光差异 选哪几种,取决于部署时真的会出现哪些变化:只在白天固定机位拍摄的数据,对比度增强意义不大;手机随手拍的数据,旋转和颜色偏移通常有用。
NumPy 写法(单张图
(H, W, C),取值 $[0,1]$):1
2
3
4
5
6
7
8
9
10
11
12def augment(img, rng):
if rng.random() < 0.5:
img = img[:, ::-1, :] # 水平翻转
H, W, _ = img.shape
top, left = rng.integers(0, H // 8 + 1), rng.integers(0, W // 8 + 1)
img = img[top:top + H - H // 8, left:left + W - W // 8] # 随机裁剪 7/8
img = img * rng.uniform(0.8, 1.2) + rng.normal(0, 0.02, img.shape) # 对比度 + 噪声
if rng.random() < 0.5: # 信息丢失:遮一块
h, w = img.shape[0] // 4, img.shape[1] // 4
y, x = rng.integers(0, img.shape[0] - h), rng.integers(0, img.shape[1] - w)
img = img.copy(); img[y:y + h, x:x + w] = 0.0
return np.clip(img, 0.0, 1.0)PyTorch(torchvision)把表中各项写成一条流水线,只挂在训练集上:
1
2
3
4
5
6
7
8
9
10
11
12
13from torchvision import transforms as T
train_tf = T.Compose([
T.RandomResizedCrop(224, scale=(0.6, 1.0)), # 随机裁剪
T.RandomHorizontalFlip(), # 翻转
T.RandomRotation(10), # 小角度旋转
T.ColorJitter(brightness=0.3, contrast=0.3, saturation=0.3, hue=0.05), # 颜色、对比度
T.ToTensor(),
T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
T.RandomErasing(p=0.25), # 信息丢失(作用在张量上)
])
eval_tf = T.Compose([T.Resize(256), T.CenterCrop(224), T.ToTensor(),
T.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])])dev/test 只做确定性的缩放、裁剪和归一化。
DataLoader每次取样都会重新随机增强,这就是速查表说的 on the fly。
- Early stopping:训练过程中监控 dev 损失,在它开始上升时停止,回滚到最优检查点。它把有效训练步数当成超参数,与 $L_2$ 的作用有重叠(训练越早停,权重离初始的小值越近)。缺点是把“优化 $J$”和“防止过拟合”两件事耦合在一起,违背正交化。
- 输入归一化:每维减均值、除标准差。各维尺度一致后,损失函数的等高线从狭长的椭圆变圆,梯度下降可以用更大的学习率、更快收敛。训练集与测试集必须使用同一组 $\mu,\sigma$。
- 标签平滑:把 one-hot 换成 $(1-\varepsilon)y+\varepsilon/K$,减轻过度自信。
- 噪声注入(noise injection):训练时用 $\tilde{x}=x+\varepsilon$,$\varepsilon\sim\mathcal{N}(0,\sigma^{2}I)$,迫使模型在样本邻域保持稳定。输入噪声、Dropout 和随机增强都属于随机正则(stochastic regularization),但三者作用位置不同。
Early stopping 与标签平滑的实现:
1 | import copy |
▸加噪为什么能正则(why noise regularizes)
对小噪声作二阶 Taylor 展开,线性项在零均值噪声下取期望后消失,留下与曲率有关的二阶项:
$$ \mathbb{E}_{\varepsilon}[\mathcal{L}(x+\varepsilon)] \approx \mathcal{L}(x) +\frac{\sigma^{2}}{2}\operatorname{tr} \big(\nabla_x^{2}\mathcal{L}(x)\big). $$
因而训练不仅压低样本点处的损失,还惩罚输入附近过大的弯曲,使决策函数更平滑(smoother decision function)。噪声过大会改变标签语义,形成分布偏移而不是正则。
▸正则不能修复错误标签或泄漏
- test 经增强后泄漏进训练集:dev 指标虚高。
- Dropout 不能补偿训练与部署的分布差。
- 先检查划分与预处理,再加正则。
▸衔接
到这里引入了一批不能由梯度学出来的量:学习率 $\alpha$、动量 $\beta$、正则强度 $\lambda$、保留概率 $p$、batch 大小、层数与层宽。下一节讨论如何在验证集上系统地选择它们。
超参数(Hyperparameter Tuning)
定义
超参数(hyperparameter)不能由梯度直接学习,但控制着训练过程和模型结构:$\alpha$、$\beta$、$\lambda$、层宽、层数、batch 大小、keep_prob 等。设置不当,模型性能会很差;而寻找好的取值通常需要大量试错。
验证数据
不能用测试数据调超参数。如果用测试集判断超参数的好坏,超参数就会被调成只适合测试集,测试集上的成绩不再代表泛化能力。因此要专门留出一份数据用于调超参数,称为验证数据(validation data,CS230 中称为 dev set):
- 训练数据:学习参数(权重和偏置);
- 验证数据:评估超参数;
- 测试数据:最后评估泛化能力,理想情况下只用一次。
每在 test 上看一次并据此改配置,test 就变成了第二块 dev,最终报告的泛化能力会被高估。若数据集只分了训练集和测试集,最简单的做法是先打乱训练集(数据可能按类别排序),再切出 20% 作为验证集:
1 | x_train, t_train = shuffle_dataset(x_train, t_train) |
重要性排序
不是所有超参数都同等重要。大致分层:
- 学习率 $\alpha$(最重要)。
- Momentum $\beta$、隐藏层宽度、mini-batch 大小。
- 层数、学习率衰减、Adam 的 $\beta_1,\beta_2$、$\varepsilon$(后两者几乎总用默认值)。
搜索方法
- 随机搜索优于网格搜索。网格搜索在低维且参数同等重要时可用;超参数很多时,若按网格取 $5\times 5$ 共 25 组,最重要的参数(如 $\alpha$)只试了 5 个不同值;随机采样 25 组,$\alpha$ 就试了 25 个不同值。因为各超参数对结果的影响程度不同,随机采样能在“重要的轴”上探索更多取值。
- 由粗到细:先在大范围内随机采样,找到表现好的区域,再在这个区域内更密集地采样。
- 在对数尺度上采样:范围以“10 的幂”指定。例如学习率在 $10^{-4}$ 到 $10^{-1}$ 之间时,若均匀采样,90% 的样本落在 $[0.01,0.1]$;应取 $\alpha=10^{u}$,$u\sim\mathrm{Unif}(-4,-1)$,使每个数量级获得同样多的样本。
- $\beta$ 的采样:$\beta=0.9,0.99,0.999$ 分别对应平均约 10、100、1000 步,对 $1-\beta$ 在对数轴上采样。原因是 $\beta$ 接近 1 时极其敏感:从 0.9 变到 0.9005 几乎没影响,从 0.999 变到 0.9995 却让平均窗口从 1000 步变成 2000 步。
- 缩短单次评估:深度学习一次训练可能要几天,搜索时应减少 epoch,尽早放弃明显不好的配置。
- 贝叶斯优化(Bayesian optimization):以贝叶斯定理为基础,比随机搜索更严密、高效。
鱼书总结的流程:
- 设定超参数的范围;
- 从范围中随机采样;
- 用采样到的值训练(epoch 设小),在验证集上评估;
- 重复 2、3 步(如 100 次),根据结果缩小范围,再重复,直到范围足够小后选定一个值。
▸例12 学习率与权值衰减系数的搜索(鱼书 6.5.3 节,参考 CS231n)
在 MNIST 上搜索两个超参数,初始范围为权值衰减系数 $10^{-8}$ 到 $10^{-4}$、学习率 $10^{-6}$ 到 $10^{-2}$,在对数尺度上随机采样:
1
2weight_decay = 10 ** np.random.uniform(-8, -4)
lr = 10 ** np.random.uniform(-6, -2)
按验证准确率排序,前 5 名为:
| 排名 | val acc | lr | weight decay |
|---|---|---|---|
| 1 | 0.83 | 0.0092 | $3.86\times 10^{-7}$ |
| 2 | 0.78 | 0.00956 | $6.04\times 10^{-7}$ |
| 3 | 0.77 | 0.00571 | $1.27\times 10^{-6}$ |
| 4 | 0.74 | 0.00626 | $1.43\times 10^{-5}$ |
| 5 | 0.73 | 0.0052 | $8.97\times 10^{-6}$ |
可见学习率在 0.001 到 0.01、权值衰减系数在 $10^{-8}$ 到 $10^{-6}$ 之间时学习顺利。下一轮就在这个缩小的范围内重复搜索。
两种策略
- Panda 策略(熊猫一次只养一个孩子):同一时间只训练一个模型,每天观察曲线、手动调整。计算资源少时使用。
- Caviar 策略(鱼一次产很多卵):并行训练多组配置,最后挑 dev 最好的。有集群时使用。
- 无论哪种,所有试验都要记录 seed、代码版本、数据版本与最终 dev 指标,否则无法复现“偶然得到的好点”。超参数也会随数据和硬件变化而“过期”,需要定期重新评估。
编程框架
C2M3 用编程框架搭建同一个模型。框架把 GradientTape 或静态图当成计算图,自动完成反向传播;optimizer.apply_gradients 对应手写的 W -= lr * dW。但以下几点仍须手动保证:
- 输入 shape 与作业约定一致,或显式
transpose; - 用
training=True/False切换 Dropout 与 BatchNorm 的行为; - 分类使用
from_logits=True的交叉熵,避免先softmax再log的数值不稳定; - 指标在 epoch 结束时用完整 dev 集计算,不要只用最后一个 mini-batch。
1 | import tensorflow as tf |
- Keras 默认输入形状为
(m, n_x)(行样本),与 NumPy 作业的(n_x, m)相反;把同一组权重搬到 Keras 时需要转置 $W$。
TensorFlow 的 GradientTape 与 PyTorch 的 autograd 是同一件事的两种写法:都在前向时记录计算图,反向时按链式法则回放。
1 | # TensorFlow:显式“录像” |
一个完整的 PyTorch 训练与评估骨架,后面各章的模型都可以套进去:
1 | def train_epoch(model, loader, loss_fn, opt, device="cpu"): |
torch.manual_seed(0)与np.random.seed(0)一起设,实验才可复现。- 在 GPU 上训练时,模型与数据都要
.to(device),两者不在同一设备会直接报错。
▸衔接
到这里已经有了一个可以训练、可以正则、超参数可以搜索的网络。但在真实项目中,“下一步该做什么”往往比“怎么实现”更难:收集更多数据?换更大的网络?调正则?下一部分把训练误差、开发集误差和部署误差分开看,用正交化的思路决定每次只改哪一类问题。
项目策略(ML Strategy)
动机
前两部分给出了一个能训练、能正则的网络。真实项目中更难的问题是:模型效果不够好时,下一步该做什么?可选的想法很多:
- 收集更多数据,或收集更多样的数据;
- 训练更久,换 Adam,换更大或更小的网络;
- 加 Dropout 或 $L_2$;
- 改网络结构、激活函数、隐藏单元数……
每个想法都可能要花几天到几个月,选错方向就白费时间。机器学习策略(ML strategy)讨论的不是某一层怎么实现,而是实验的次序:根据指标变化,判断下一步应该改数据、改正则还是改结构。
做法分两步:
- 固定一个评估指标,以及一份与部署同分布的开发集(相当于先立好靶子);
- 根据训练误差、开发集误差和误差分析表,只安排下一件实验(再瞄准射击)。
同一轮改两件不相关的事,结果无法归因,这就是正交化要避免的。
正交化
正交化(orthogonalization):把影响结果的因素分成几类,每一类只由一个对应的手段调节,一次实验只动一类。这样指标上升或下降时,才能把结果归因到那一类,而不是若干改动叠在一起。
Ng 的比喻是老式电视机:一个旋钮只调高度,一个只调宽度,一个只调梯形失真。如果一个旋钮同时改变高度、宽度和亮度,几乎不可能把画面调正。汽车也一样:方向盘管方向,油门和刹车管速度,两者分开才好控制。
监督学习项目要依次满足四个目标,每个目标只用表里的手段:
| 目标 | 只用这些手段 |
|---|---|
| 降低训练误差 | 加大网络、换优化器、加长训练 |
| 缩小 dev 与训练的差距 | 正则、增加与 train 同分布的数据 |
| 让 test 上的数字可信 | 保证 dev 与 test 同分布,并且两边都够大 |
| 让数字对部署有意义 | 保证 dev/test 的采集方式与部署数据一致 |
若 test 上好但实际效果差,要么 dev/test 分布不对,要么指标不对。
Early stopping 是一个“不正交”的例子:它同时影响训练误差(停得早,训练集拟合得差)和开发集误差,一个旋钮调两件事,所以 Ng 更倾向于用其他正则化手段。
▸反例
同一轮既把隐藏层从 64 加到 512,又把 $\lambda$ 从 $10^{-4}$ 调到 $10^{-3}$。dev 无论变好还是变差,都无法判断是容量还是正则在起作用。训练误差仍然高时就加 Dropout,也会把两件事搅在一起。
评估指标
单一数字指标
评估指标(evaluation metric)是用来比较模型的数字。没有事先约定的指标,就无法判断一次改动是进步还是退步。理想情况是一个数字,这样可以立刻排出模型的好坏,快速迭代。
▸分类指标(classification metrics)
混淆矩阵(confusion matrix)包含真阳性(true positive, TP)、假阳性(false positive, FP)、真阴性(true negative, TN)与假阴性(false negative, FN)。
$$ \begin{aligned} \mathrm{precision} &= \frac{TP}{TP+FP},& \mathrm{recall} &= \frac{TP}{TP+FN},\\ \mathrm{sensitivity} &= \mathrm{recall},& \mathrm{specificity} &= \frac{TN}{TN+FP},\\ F_1 &= \frac{2\,\mathrm{precision}\,\mathrm{recall}} {\mathrm{precision}+\mathrm{recall}}.& \end{aligned} $$
Precision(查准率)回答“判为正的样本里有多少真是正类”;recall(查全率)回答“全部正类里找回了多少”。$F_1$ 是两者的调和平均,任何一个很低都会把它拉低。调高二分类阈值通常提高 precision、降低 recall,但具体结果取决于分数排序。
ROC 曲线(receiver operating characteristic curve)画 true positive rate 对 false positive rate;AUROC 衡量随机抽一个正样本与负样本时,正样本得分更高的概率。正类极少时,precision-recall curve 与 PR AUC 通常比 ROC AUC 更能暴露假阳性。
多分类的 macro average 先逐类算再等权平均,强调少数类;micro average 先汇总所有类别的 TP、FP、FN 再计算,更受大类影响。
▸例1 两个指标无法直接比较
猫分类器 A:precision $95\%$,recall $90\%$;分类器 B:precision $98\%$,recall $85\%$。A 的 recall 高,B 的 precision 高,看不出谁更好。合成为 $F_1$:A 为 $92.4\%$,B 为 $91.0\%$,于是选 A。
- 类别不平衡时准确率失效(99% 都是负类时,全判负也有 99% 准确率):改用 precision、recall、$F_1$、PR AUC、代价加权错误率。
- 检测用 mAP;分割用 IoU 或 Dice;检索用 Recall@$k$。
- 多个地区、多个子集各有一个误差时,取平均作为单一数字。
1 | def binary_metrics(y_true, y_score, threshold=0.5): |
例 1 的两个分类器用 binary_metrics 算出的 $F_1$ 分别为 $0.924$ 与 $0.910$。工程上也可以直接用 sklearn.metrics 的 precision_recall_fscore_support、roc_auc_score、average_precision_score(PR AUC)对拍。
优化指标与满意度指标
有些要求本质上不是“越大越好”,而是“达标即可”。Ng 把指标分成两类:
- 优化指标(optimizing metric):只留一个,例如准确率,在满足约束的模型里越高越好。
- 满意度指标(satisficing metric):设阈值,例如运行时间 $<100\,\mathrm{ms}$、内存 $<1\,\mathrm{GB}$。达不到阈值的模型直接淘汰,达到之后再好也不加分。
一般地,$N$ 个指标中选 1 个作为优化指标,其余 $N-1$ 个作为满意度指标。多个优化指标若必须同时考虑,应加权成单一数字,权重必须在看结果之前写进提案。
▸例2 满意度约束优先
三个模型:A 准确率 $90\%$、延迟 $80\,\mathrm{ms}$;B 准确率 $92\%$、延迟 $95\,\mathrm{ms}$;C 准确率 $95\%$、延迟 $1500\,\mathrm{ms}$。要求延迟 $\le 100\,\mathrm{ms}$ 时,C 被淘汰,在 A、B 中比准确率,选 B。
又如唤醒词检测(”Hey Siri”):优化指标是唤醒准确率,满意度指标是“每 24 小时误唤醒不超过 1 次”。
何时修改指标
指标与真实需求不一致时,要果断改指标。
▸例3 加权错误率
猫图推荐应用中,算法 A 错误率 $3\%$,但会把色情图片当成猫推给用户;算法 B 错误率 $5\%$,不会。按错误率应选 A,但用户和公司都会选 B,说明指标错了。改成加权错误率:
$$ \mathrm{Error}=\frac{1}{\sum_i w^{(i)}}\sum_{i}w^{(i)}\,\mathbb{1}\{\hat{y}^{(i)}\ne y^{(i)}\},\qquad w^{(i)}=\begin{cases}1 & x^{(i)}\text{ 非色情}\\ 10 & x^{(i)}\text{ 色情}\end{cases}. $$
色情图片被误判的代价是普通错误的 10 倍。实现时需要把这类图片标出来。
这本身也是正交化:定义指标(立靶子)与如何在指标上做好(瞄准)是两件独立的事,分开处理。
- 指标必须在项目开始时与业务代价对齐。训练后再挑选当时最高的那条曲线,等于用 test 调参。
- 在“指标 + dev/test”上表现好,但在实际应用中表现差,就改指标或改 dev/test。例如 dev/test 都是高清图,用户上传的却是模糊图。
数据划分
三个子集
划分(split)把带标签样本分到互不重叠的子集,避免用同一批数据既训练又评估。
- 训练集 train:估计参数 $W,b$。
- 开发集 dev(hold-out / validation):选超参数、比较模型、做误差分析。日常迭代看的就是这块上的指标。
- 测试集 test:最终评估用一次,无偏地估计模型在未见样本上的表现。
若只有 train/test,又在 test 上调学习率和结构,test 就失去了“未见”的含义,报告中的泛化会被高估。可以暂时不设 test、只留 dev,但终稿需写明没有盲测集。
按规模选比例
小数据年代常用 70/30 或 60/20/20。样本到百万以后,再把三成留给 test 会浪费训练数据。C3 的做法是:先确定 dev、test 需要多少条才够比较两个模型,其余全部放入 train。
| 总样本大约 | 常见划法 | 理由 |
|---|---|---|
| 几百到约 $10^{4}$ | 60/20/20 或 70/15/15;更老的写法是 70/30(train/test,再从 train 划 dev) | 每一块都要有足够样本,误差估计才稳 |
| $10^{4}$–$10^{5}$ | 80/10/10 或 90/5/5 | 开始把更多样本留给训练 |
| 约 $10^{6}$ | 98/1/1,例如 98 万 / 1 万 / 1 万 | 1 万条 dev 通常能看出约 $0.1\%$ 的差别 |
| 更大,到亿级 | 99.5/0.25/0.25,或固定划出 1 万–10 万做 dev/test,其余全进 train | 比例继续缩小,绝对数量不动 |
- 几百条还做深度网络:优先加数据或用强预训练,不先纠结 2% 的划分差。
- 约 1000 条 dev:大致能分辨 $1\%$ 的指标差;要稳稳看出 $0.1\%$,课上按约 1 万条估。
- 广告、搜索这类 $0.01\%$ 也值钱的任务,dev 可以远大于 1 万。
- test 的大小按“对最终数字有没有信心”定,不是按总数据的固定百分比。
- 类别不平衡时做分层抽样(stratified split),保证少数类在三块里都出现。正类只有几十个时,随机切可能让 test 里一个正类都没有。
▸训练、dev 与 test
- 训练误差高:模型还没拟合,先查学习率、bug、容量。
- 训练低、dev 高,且两块同分布:方差,加数据或正则。
- 训练和 dev 都低、test 突然高:多半在 test 上调过参(对 dev 过拟合了),或 test 被换过分布。
- Dev 只有两三百条时,$0.8\%$ 的波动常被采样噪声淹没,不足以支持换架构。
▸例3a 课上的昼夜分类:1 万张怎么切
CS230 Lecture 2 的热身题:给一张户外照片,判断白天($0$)还是夜晚($1$)。
- 要多少数据:参照猫分类器约 1 万张图就能做好,估计这个任务难度相当,先收集约 1 万张。任务定义会改变这个数:只在一个固定机位判断昼夜很容易;要求世界任何地点、室内、黎明黄昏、极昼地区都能判断,1 万张远远不够。
- 怎么切:约 $80\%$ 进 train,其余做 dev/test。数据更多时,留给评估集的比例更小、留给 train 的更大。
- 分层:不是整体随机切,而是按类别分别切:白天图的 $80\%$ 和夜晚图的 $80\%$ 各自进 train,保证每块里两类比例与总体一致。
- 输入分辨率:把同一批图缩成不同分辨率给人看,找出人还能稳定判断的最低分辨率,结果约 $64\times 64\times 3$。颜色要保留,因为蓝天本身就是白天的线索,去掉颜色后人也更难判断。分辨率太低会丢信息(例如看不清画面里的钟),太高则参数多、训练慢、迭代周期长。
- 输出与损失:输出 $0/1$,末层 sigmoid,二元交叉熵;任务简单,浅层网络或小 CNN 即可。
Dev 要多大
“1 万条 dev 能看出 $0.1\%$ 的差别”是经验说法,可以用误差估计的标准误来核对。
在 $n$ 条 dev 上测得错误率 $\hat{p}$,它是 $n$ 个独立 $0/1$ 变量的平均,标准误(standard error)为
$$ \mathrm{SE}(\hat{p})=\sqrt{\frac{p(1-p)}{n}},\qquad \text{95\% 置信区间}\approx\hat{p}\pm 1.96\,\mathrm{SE}. $$
取真实错误率 $p=10\%$:
| dev 大小 $n$ | $\mathrm{SE}$ | 95% 区间半宽 |
|---|---|---|
| $100$ | $3.0\%$ | 约 $\pm 5.9\%$ |
| $1000$ | $0.95\%$ | 约 $\pm 1.9\%$ |
| $10^{4}$ | $0.30\%$ | 约 $\pm 0.59\%$ |
| $10^{5}$ | $0.095\%$ | 约 $\pm 0.19\%$ |
单看一个模型,1 万条 dev 的误差估计仍有约 $\pm 0.6\%$ 的不确定性。但比较两个模型时,两者是在同一批 dev 上评估的,大部分样本两个模型同对或同错,抵消掉了。真正起作用的只有“两者判断不同”的样本:记 $n_{10}$ 为 A 错 B 对的条数,$n_{01}$ 为 A 对 B 错的条数,则
$$ \hat{\Delta}=\frac{n_{10}-n_{01}}{n},\qquad z=\frac{n_{10}-n_{01}}{\sqrt{n_{10}+n_{01}}}. $$
$|z|>1.96$ 时,大约可以认为差别不是采样噪声(这就是 McNemar 检验的正态近似)。
▸例3b 1 万条 dev 上差 $0.1\%$ 算不算数
- 两个模型只在 $30$ 条样本上判断不同,其中 A 错 B 对 $20$ 条、A 对 B 错 $10$ 条:$\hat\Delta=10/10^{4}=0.1\%$,$z=10/\sqrt{30}\approx 1.8$,接近显著。
- 两个模型在 $300$ 条样本上判断不同,A 错 B 对 $155$、A 对 B 错 $145$:$\hat\Delta$ 同样是 $0.1\%$,但 $z=10/\sqrt{300}\approx 0.58$,完全可能是噪声。
所以“dev 多大才够”不只看总条数,还看两个候选模型的分歧有多大。改动越小(只调一个超参数),分歧越少,同样的 dev 越容易看出差别。
- 反过来估算:希望单个模型的 $\mathrm{SE}$ 不超过 $s$,需要 $n\ge p(1-p)/s^{2}$。$p=10\%$、$s=0.1\%$ 时 $n\ge 9\times 10^{4}$。
- 错误率越低,同样的 $n$ 能看出的差别越小:$p=1\%$ 时 1 万条的 $\mathrm{SE}$ 约 $0.1\%$。
- test 只评一次,按“最终报告的数字需要多大的置信区间”来定大小,再写进报告。
- 正类极少时,上式中的 $n$ 应换成正类的条数来估 recall 的不确定性:1 万条 dev 里只有 50 个正类,recall 的 $\mathrm{SE}$ 约为 $\sqrt{0.5\times 0.5/50}\approx 7\%$。
小数据:k 折交叉验证
样本只有几百到几千条时,固定切出 $20\%$ 做 dev,dev 小到噪声很大,train 也少了一块。这时常用 k 折交叉验证(k-fold cross-validation):
- 把数据(先扣除 test)随机分成 $k$ 份,常取 $k=5$ 或 $10$;
- 轮流用其中 $1$ 份做验证、其余 $k-1$ 份训练,共训练 $k$ 次;
- 报告 $k$ 次验证误差的均值与标准差,用均值选超参数;
- 选定超参数后,在全部训练数据上重训一次,最后在 test 上评一次。
- $k=m$(每次只留一个样本)称为留一法(leave-one-out),偏差最小但要训练 $m$ 次。
- 代价是训练 $k$ 次。深度学习里数据多、单次训练贵,一般只用固定 dev;医学影像、小样本科研数据才更常用交叉验证。
- 若交叉验证同时用来选超参数和报告最终性能,结果会偏乐观。要么另留 test,要么用嵌套交叉验证(nested CV):外层折估计性能,内层折选超参数。
- 前面“常见切法错误”里的规则同样适用于每一折:
- 分层 k 折(stratified k-fold):每折里类别比例一致;
- 分组 k 折(group k-fold):同一病人、同一用户的样本只进同一折;
- 时间序列用前向滚动(forward chaining):第 $i$ 次用前 $t_i$ 段训练、紧接着的一段验证,绝不让验证段早于训练段。
1 | def kfold_indices(m, k=5, seed=0): |
Dev 与 test 的分布
- Dev 和 test 必须取自同一分布,并且尽量就是部署后真正要处理的数据。否则团队花几个月在 dev 上优化,到 test 上才发现瞄错了靶。课上的例子:dev 来自美国、英国等地区,test 来自其他地区,结果白忙。
- 部署输入是手机模糊图,dev 就不能只放单反爬图。
- Train 可以更大,也可以来自网上爬取;来源不同时,另做训练-开发不匹配分析(见“分布不匹配”)。
- 随机打乱再按比例切,隐含三块同分布。来源不同时,这个假设不成立。
▸例4 课上的猫图:20 万网上 + 1 万用户上传
网上图清晰,用户上传的是手机拍照,部署后要分的是后者。
- 方案一:混在一起随机切成 20.5 万 / 2500 / 2500。dev 中平均只有 $2500\times 10000/210000\approx 119$ 张手机图,绝大多数仍是网上图,团队实际上在优化网上图,部署到手机拍照时误差会明显升高。
- 方案二(课上推荐):20 万网上图加 5000 张用户图进 train;剩下 5000 张用户图对半切成 dev 和 test(各 2500)。dev/test 对准了目标分布,train 里也出现目标分布样本,后面分析不匹配时更好用。
方案二的代价是 train 与 dev 分布不同,需要用后文的 train-dev 集来区分方差和不匹配。
- 方案二的变体:20 万网上图全部进 train,1 万张用户图对半切成 dev 和 test(各 5000),train 里不放用户图。dev/test 更大、比较模型更稳,但 train 中完全没有目标分布样本,不匹配误差会更大。目标分布样本较多时,再从中拿出约 5000 张放进 train,就回到方案二。
- 选哪种取决于目标分布样本有多少:先保证 dev/test 够用来比较模型(见上文“Dev 要多大”),剩下的目标分布样本放进 train。
项目里常见的切法错误
- 泄漏(data leakage):本应只出现在评估集里的信息,在训练时已经被模型看见。同一病人的多张片子、同一段视频的相邻帧、同一篇文章切出来的句子,分别进了 train 和 test,就属于这一类。按“组”整段划分,不要按单张图随机。
- 时间序列、日志、股价:按时间切,前面训、后面测。打乱等于把未来泄漏给训练。
- 先增强再划分:同一张图的两个裁剪分别进 train 和 test,等于抄作业。先划分,增强只做在 train 上。
- 用 test 估均值方差或建词表:预处理统计只在 train 上算,dev/test 复用同一套。
- 每次实验重新随机切:数字在跳,不是模型变强。写死随机种子,把 index 存进仓库。
1 | def stratified_split(y, train_frac=0.8, dev_frac=0.1, seed=0): |
train_frac + dev_frac应小于 1,剩余进 test。- 某类只有 3 条时,分层也会把某块切空,这时先合并稀有类或改用交叉验证,不要硬切三块。
何时改划分
- 产品目标变了:从网页猫图改成 App 拍照,旧的互联网 dev 不能再用来选模型。
- 指标不反映真实代价(例 3):改加权误差或加满意度约束,并重建 dev/test。
- 改了划分或指标之后,历史模型要在新集合上重评。旧表上的数字不能和新表混着比。
人类水平
为什么要和人比
模型准确率随时间的典型曲线是:快速上升直到接近人类水平,然后放缓,渐近逼近一个永远达不到的上限——Bayes 误差(Bayes error),即任何分类器在该数据分布上能达到的最低错误率。标签本身有噪声、或输入信息不足以区分两类(图片太模糊、音频噪声太大)时,它大于 0。这个量通常无法直接计算。
超过人类水平后进展变慢,原因有二:一是人类水平在很多任务上已经接近 Bayes 误差,剩余空间很小;二是只要模型还不如人,就有一套好用的工具——让人来标更多数据、让人分析错误原因、更准确地估计偏差与方差,超过人类后这些工具都失效了。
人类水平作为 Bayes 误差的代理
人类水平误差(human-level error)$h$ 是一组标注者在同一任务上的错误率,当作 Bayes 误差的可观测上界(近似)。取普通用户还是专家委员会,数值差很大,需要与目的一致。
▸例5 医学影像中的“人类水平”取哪个
某放射影像分类任务:普通人 $3\%$,普通医生 $1\%$,经验丰富的医生 $0.7\%$,经验丰富的医生团队讨论后 $0.5\%$。
若目的是估计 Bayes 误差,应取 $0.5\%$:Bayes 误差不可能高于已经达到的最好水平。若目的是写论文或部署(“超过普通医生即可用”),可以取 $1\%$。
可避免偏差
有了 $h$,就能把“偏差”说得更精确:
- 可避免偏差(avoidable bias)$=$ 训练误差 $-\ h$。训练误差不可能低于 Bayes 误差,所以只有超出 $h$ 的部分才“可避免”。
- 方差差距(variance gap)$=$ 开发集误差 $-$ 训练误差(训练与开发集同分布时;若分布不同,改用 train-dev 误差 $-$ 训练误差,见下文「Train-dev 集」)。
Andrew Ng 在 Deep Learning Specialization 里强调:训练误差与开发误差可以完全相同,但只要人类水平 $h$ 不同,该先降偏差还是先降方差就会完全相反。不能只看“训练 $4\%$、dev $4.5\%$”就断定是 high bias 还是 high variance——必须同时看 $h$。
▸原理:为什么要用 $h$ 把 dev 误差拆成两项
要回答的问题:下一周该加数据/正则,还是加大模型/多训几轮?这对应两类不同的失败模式——在训练集上还没学好(高偏差 / underfitting),与在训练集上学好了但换一批同分布数据就变差(高方差 / overfitting)。只看 $E_{\text{train}}$ 与 $E_{\text{dev}}$ 的差,只能看到第二种;第一种必须知道“训练误差离理论下限还有多远”。
理论下限:Bayes 误差 $E^*$ 是任何模型在该任务、该数据分布上能达到的最低期望错误率(标签噪声、输入模糊、类间不可分等都会把它抬高)。$E^*$ 算不出来,用人类水平 $h$ 当可观测的上界:$E^*\le h$(人都能错 $h$,模型不可能长期稳定地比 Bayes 还低)。
第一项:可避免偏差 $E_{\text{train}}-h$。
- 含义:当前模型在已见过的训练数据上,比“人类/Bayes 所能达到的最好水平”还多错多少。
- 若这项大:说明训练集上仍有大量“本可以学对”的错误——常见原因是模型容量不够、训练步数不够、优化没收敛、实现有 bug,或损失/标签与任务不对齐。手段是加容量、训更久、改优化/架构。
- 若 $E_{\text{train}}\approx h$:在训练集上已接近 Bayes 代理,再堆大模型往往降不了多少 train,继续加容量主要是浪费算力。
第二项:方差差距 $E_{\text{dev}}-E_{\text{train}}$(train 与 dev 同分布时)。
- 含义:模型在同一分布下,从“见过的 train”到“没见过的 dev”,错误率又升高多少。
- 若这项大:train 已经拟合得不错,但泛化差——常见原因是数据太少、模型相对数据过大、过拟合。手段是更多数据、正则、数据增强。
- 若这项小:同分布泛化不是主矛盾;若 dev 仍远高于 train,要怀疑 train 与 dev 不同分布(改用 train-dev 诊断,见后文)。
分解式 $E_{\text{dev}}\approx h+(E_{\text{train}}-h)+(E_{\text{dev}}-E_{\text{train}})$ 只是把 dev 上的总错误拆成三层:
- $h$:任务本身难度(Bayes 代理,改模型也消不掉);
- $E_{\text{train}}-h$:训练集上还没拟合到位的部分(可避免偏差);
- $E_{\text{dev}}-E_{\text{train}}$:拟合 train 之后,同分布泛化还损失多少(方差差距)。
为何 train、dev 相同而 $h$ 不同,策略会相反(例 6a vs 6b 都是 $4.0\%/4.5\%$):
- $h=0.5\%$:$E_{\text{train}}=4\%$ 远高于 $h$,主矛盾是“train 上还能学很多”(可避免偏差 $3.5\%$),dev 只比 train 高 $0.5\%$ 是次要的。
- $h=3.9\%$:$E_{\text{train}}=4\%$ 几乎贴住 $h$,不是“再加十层就能在 train 上掉到 $1\%$”——任务/标签噪声下人类也就 $3.9\%$。此时 dev 仍比 train 高 $0.5\%$,主矛盾变成方差(数据、正则),而不是容量。
没有 $h$ 时:只能算 $E_{\text{dev}}-E_{\text{train}}$,无法知道 $4\%$ 的 train 是“离 Bayes 还很远”还是“已经贴顶”。因此不能单凭 train $4\%$ 就判 high bias。
与经典 bias–variance 分解的关系:理论上期望泛化误差可写成偏差平方 + 方差 + 不可约噪声;CS230 这套是工程上的可操作版本——用 $h$ 代替不可约噪声,用 train/dev 两个数代替“拟合 vs 泛化”,便于决定下一实验。两项哪个大,通常先动哪类(也可能两个都改)。
▸三个常用公式(以 $h$ 为 Bayes 误差的代理时)
记 $E_{\text{train}}$、$E_{\text{dev}}$ 为训练集、开发集上的错误率(error,不是 accuracy),$h=E_{\text{human}}$:
$$ \boxed{\text{Avoidable Bias}\approx E_{\text{train}}-h} $$
$$ \boxed{\text{Variance Gap}=E_{\text{dev}}-E_{\text{train}}} $$
$$ \boxed{E_{\text{dev}}\approx h+(E_{\text{train}}-h)+(E_{\text{dev}}-E_{\text{train}})} $$
即 $E_{\text{dev}}\approx h+\text{可避免偏差}+\text{方差差距}$(在 $h$ 近似 Bayes 误差、且 train/dev 同分布时成立)。哪一项数值更大,通常就先动哪一类手段(见下表)。
▸例6 相同的 $E_{\text{train}}$、$E_{\text{dev}}$,不同的 $h$(Andrew Ng, DLS)
下列三例默认 train 与 dev 同分布;方差差距 $=E_{\text{dev}}-E_{\text{train}}$。
例 6a:high bias(高偏差)
| 指标 | Error |
|---|---|
| Human-level | $0.5\%$ |
| Training | $4.0\%$ |
| Dev | $4.5\%$ |
$$ \text{Avoidable Bias}=4.0\%-0.5\%=3.5\%,\qquad \text{Variance Gap}=4.5\%-4.0\%=0.5\%. $$
可避免偏差明显大于方差差距 → 先降偏差:更大模型、训练更久、更好的优化器(Momentum、Adam 等)、检查实现 bug。
例 6b:high variance(高方差)
| 指标 | Error |
|---|---|
| Human-level | $3.9\%$ |
| Training | $4.0\%$ |
| Dev | $4.5\%$ |
$$ \text{Avoidable Bias}=4.0\%-3.9\%=0.1\%,\qquad \text{Variance Gap}=4.5\%-4.0\%=0.5\%. $$
方差差距大于可避免偏差 → 先降方差:更多训练数据、$L_2$/Dropout、数据增强;train 已接近 $h$,再加容量收益有限。
例 6c:偏差与方差都偏大
| 指标 | Error |
|---|---|
| Human-level | $0.5\%$ |
| Training | $4.0\%$ |
| Dev | $8.0\%$ |
$$ \text{Avoidable Bias}=3.5\%,\qquad \text{Variance Gap}=4.0\%. $$
两项都不小:训练集尚未拟合到接近 $h$,dev 上又比 train 差很多。实践中常先处理数值更大的一项(此处方差差距略大,可先加数据/正则),再回头加容量;也可分两轮实验,分别验证“只加数据”与“只加大模型”哪条曲线降得更快。
三例对照(单位:百分点;差距越大,对应方向上的改进空间通常越大):
| $h$ | $E_{\text{train}}$ | $E_{\text{dev}}$ | 可避免偏差 | 方差差距 | 优先方向 | |
|---|---|---|---|---|---|---|
| 6a | $0.5$ | $4.0$ | $4.5$ | $3.5$ | $0.5$ | 降偏差 |
| 6b | $3.9$ | $4.0$ | $4.5$ | $0.1$ | $0.5$ | 降方差 |
| 6c | $0.5$ | $4.0$ | $8.0$ | $3.5$ | $4.0$ | 两项都需处理 |
另一组常见数字(训练 $8\%$、dev $10\%$ 不变):$h=1\%$ 时可避免偏差 $7\%$、方差 $2\%$,先降偏差;$h=7.5\%$ 时可避免偏差仅 $0.5\%$、方差仍 $2\%$,先降方差。与 6a/6b 是同一逻辑。
▸只有 $E_{\text{train}}$、$E_{\text{dev}}$、没有 $h$ 时
例如只给出 Training $=4.0\%$、Dev $=4.5\%$:可以算方差差距 $0.5\%$,但无法算可避免偏差,也就不能判断 high bias 还是 high variance。这也是为什么不能一见“训练误差 $4\%$”就默认 high bias。
▸怎么用 $h$
训练误差明显高于 $h$:可避免偏差大,应加容量或检查优化。训练误差已经接近 $h$、dev 仍高:按方差处理。标注者互相矛盾时,$h$ 会被抬高,模型可能只是在拟合噪声。
- 两项都大时,先处理数值更大的那一项。
- 训练和 dev 都已经接近 $h$:再加大模型收益很小,应改任务定义、输入信号或产品范围。
- 超过人类水平之后:例如人类团队 $0.5\%$,训练误差 $0.3\%$,开发集 $0.4\%$。这时无法判断还有多少可避免偏差(Bayes 误差可能是 $0.1\%$,也可能是 $0.3\%$),方向不再清晰。误差分析仍有用,只是不宜再把 $h$ 当成硬上限。
- 机器已明显超过人类的领域多是结构化数据:在线广告、商品推荐、物流时间预测、贷款审批。它们数据量巨大,且不是人类擅长的自然感知任务。在视觉、语音等感知任务上超过人类要难得多,但也已在部分任务上实现。
小结:提升模型表现的两条路
监督学习要做好,依赖两个基本假设:
- 能把训练集拟合得很好(可避免偏差小);
- 训练集上的表现能推广到开发集和测试集(方差小)。
| 问题 | 手段 |
|---|---|
| 可避免偏差 | 更大的模型;训练更久或更好的优化算法(Momentum、RMSprop、Adam);更好的架构(RNN、CNN)或超参数搜索 |
| 方差 | 更多数据;正则化($L_2$、Dropout、数据增强);更好的架构或超参数搜索 |
误差分析
做法
误差分析(error analysis):在 dev 的错误样本上人工统计失败类型,用各类所占比例估计“若该类被完全修好,指标最多升多少”,再决定下一实验。
▸例7 要不要做狗分类器
猫分类器在开发集上错误率 $10\%$。同事发现一些狗被误认为猫,提议花几个月专门处理狗。先别动手:从开发集中抽 100 个误判样本,数一数其中有几只狗。
- 若只有 5 只:这类问题彻底解决,错误率最多从 $10\%$ 降到 $9.5\%$,不值得花几个月。
- 若有 50 只:最多从 $10\%$ 降到 $5\%$,值得做。
这个“最多能改善多少”称为该方向的性能上限(ceiling)。
- 从 dev 里抽出约 100 个错误样本(错误很少就全看)。
- 同一张表上并行评估多个想法,打勾统计:标注错、狗、大型猫科动物(狮子、豹)、模糊、滤镜、过曝、框不准、光线等。一张图可以属于多列,表中还可加备注列。
- 某列只占错误的 $2\%$:这列做到完美,总体也只改善约 $2\%$ 的错误,不应成为主攻。
- 上限 $=$ 该列占比 $\times$ 当前错误率。下一实验优先做上限更高的那一列。
- 这比凭直觉加新模块便宜得多,也是期中案例题的标准答法。
误差表本身就是一张“错误样本 × 标签”的布尔矩阵,算上限只需几行代码:
1 | def error_ceiling(tags, dev_error): |
各列可以重叠,所以“占比”之和可以超过 $100\%$;每一列的上限要单独看,不能相加。
▸例8 猫识别器的误差表
100 张误分类中:狗 8、模糊 61、滤镜 21、标注错误 10。即使狗分类器做到完美,上限约 $8\%$ 的错误。优先收集模糊与滤镜数据,或在训练中加模糊增强,比设计狗检测器更合理。
标错的标签
数据中有标签本身是错的(例如把狗标成了猫),怎么办?
- 训练集:深度学习对随机标签错误相当稳健,只要错误比例不高、数据量够大,往往不必修正;但对系统性错误(例如标注员把所有白色的狗都标成猫)不稳健。
- 开发 / 测试集:在误差表里单开一列“标签错”,按其占比决定是否值得修正。
▸例9 标签错误值不值得修
- 开发集整体错误 $10\%$,其中标签错误导致 $0.6\%$,其他原因 $9.4\%$:标签错误只占 $6\%$ 的错误,先解决其他问题。
- 开发集整体错误降到 $2\%$,标签错误仍导致 $0.6\%$:已占 $30\%$ 的错误,而且会干扰对模型 A、B 的比较(A 错 $2.1\%$、B 错 $1.9\%$,已分不清谁更好),这时值得修正。
修正开发 / 测试集标签时的原则:
- 对 dev 和 test 同时修正,保证两者仍同分布;
- 不仅检查模型判错的样本,也检查判对的样本(模型可能因标签错而“碰巧”判对),虽然后者数量大、成本高;
- train 可以不修,于是 train 与 dev/test 的分布会略有不同,这通常可以接受;
- 错标集中在某类、或占错误的大头:回头改标注协议,再重标这批;
- 改标签后重新算 $h$ 和误差表,旧的“已经超过人类”可能消失;
- 清洗标签的成本要和它在误差表上的上限比较,不必无期限洗全部数据。
先快速搭一个系统
面对新问题(例如语音识别),可改进的方向非常多:嘈杂背景(咖啡馆、车内)、口音、离麦克风远、儿童语音、口吃……不可能一开始就全部考虑。Ng 的建议是:
- 快速确定 dev/test 和指标;
- 快速搭出第一个系统(几天之内);
- 用偏差/方差分析和误差分析决定下一步优先做什么。
若问题已有大量成熟研究(如人脸识别),可以直接从文献起步,不必从简单系统开始。
分布不匹配
问题
数据量的需求越来越大,常常只能把来源不同的数据混在一起训练(如例 4 的网上图 + 手机图),于是训练集与开发集不再同分布。这时 dev 高于训练误差,不能直接当成方差:一部分来自过拟合,一部分来自两套数据本身不同,这称为数据不匹配(data mismatch)。
▸例10 车载语音助手
要做车内后视镜上的语音助手。已有 50 万条各类语音(购买的数据、智能音箱、其他语音识别项目),但车内后视镜场景的语音只有 2 万条。按例 4 的思路:50 万条全部进 train,2 万条车内语音分给 dev 和 test(也可以拿出 1 万条放进 train)。
Train-dev 集
为了区分方差和数据不匹配,从训练集中再随机划出一块 训练-开发集(train-dev):与训练集同分布,但不参与训练。
比较四条误差:
| 量 | 含义 |
|---|---|
| 人类水平 $h$ | Bayes 误差的代理 |
| 训练误差 | 模型装训练数据的能力 |
| 训练-开发误差 | 同分布但未见过的数据上的表现 |
| 真实 dev 误差 | 再加上分布不匹配 |
- 训练误差 $-\ h$:可避免偏差。大则加容量、修优化。
- 训练-开发 $-$ 训练误差:方差。大则加与 train 同分布的数据,或加正则。
- 真实 dev $-$ 训练-开发:数据不匹配。大则让训练数据更接近部署分布。
- 真实 test $-$ 真实 dev:对 dev 的过拟合程度。这里再跳,多半是 test 被看过或切错,需要更大的 dev。
1 | def make_train_dev(train_idx, frac=0.05, seed=0): |
▸例11 四种误差组合(人类水平约 $0\%$)
| 训练 | 训练-开发 | 开发 | 诊断 |
|---|---|---|---|
| $1\%$ | $9\%$ | $10\%$ | 方差:同分布的新数据上就已经差了 |
| $1\%$ | $1.5\%$ | $10\%$ | 数据不匹配:同分布泛化得好,换分布才变差 |
| $10\%$ | $11\%$ | $12\%$ | 可避免偏差 |
| $10\%$ | $11\%$ | $20\%$ | 可避免偏差 + 数据不匹配 |
开发集误差也可能低于训练误差,说明开发集分布比训练集“容易”(例如车内语音反而更清晰)。
如何处理数据不匹配
数据不匹配没有像偏差、方差那样系统的解法,但有几条实用办法:
- 人工分析差异:看开发集样本,理解它和训练集差在哪里(例如车内语音多了汽车噪声、很多是门牌号)。注意只看 dev,不看 test,避免过拟合 test。
- 让训练数据更像 dev:收集更多接近 dev 的数据(更多手机图,而不是更多网上图;更多车内录音),或者人工合成。
- 人工合成数据(artificial data synthesis):例如把干净语音和车内噪声叠加,得到“车内语音”。要警惕合成数据只覆盖了真实分布的一小块:
- 1 万小时语音配 1 小时车噪声循环叠加,人耳听不出区别,但模型可能过拟合这 1 小时的噪声;
- 从赛车游戏中截取汽车图片,游戏里可能只有 20 种车型,模型会过拟合这 20 种车。
- 合成要在 dev 上验证真的降低了不匹配误差;加了车载噪声却没降低不匹配项,合成无效。
- 让 train 里混入一部分目标分布样本,分析时更稳。不要把网上图和手机图混洗后再随机切,否则 dev 不再代表部署分布。
- 领域自适应、相关对齐等方法可以后做。课上先要求把四条误差写清楚,再决定要不要上这些方法。
迁移、多任务与端到端
迁移学习
迁移学习(transfer learning):把在任务 A 上学到的知识用到任务 B 上。例如用 ImageNet 上训练好的图像识别网络做放射影像诊断:换掉最后的输出层,用影像数据重新训练。
- 预训练(pre-training):在任务 A 上训练;微调(fine-tuning):在任务 B 上继续训练。
- 目标数据很少时,冻结骨干只训新的输出头;数据变多再解冻后几层;数据很多时全部重新训练,学习率比从头训练小约一个数量级。
- 为什么有效:低层特征(边缘、曲线、纹理;语音中的音素)在很多任务间通用。
迁移学习有意义的条件:
- 任务 A 和 B 的输入类型相同(都是图像,或都是音频);
- 任务 A 的数据比任务 B 多得多(例如 A 有 100 万张图,B 只有 100 张);
- A 学到的低层特征对 B 有帮助。
反过来,A 只有 1 万张而 B 有 1 万张,迁移就没有多少意义。源和目标差太远(自然图像 $\rightarrow$ 病理切片)仍可作初始化,但要更快解冻,或换领域内预训练。
多任务学习
多任务学习(multitask learning):一个网络同时做多个任务,一个共享的骨干接多个输出头。
▸例12 自动驾驶中的多标签检测
每张图要判断是否有行人、汽车、停车标志、交通灯,标签 $y^{(i)}\in\{0,1\}^{4}$。与 softmax 不同,一张图可以同时有多个 1。损失是 4 个逻辑回归损失之和:
$$ J=\frac{1}{m}\sum_{i=1}^{m}\sum_{j=1}^{4}\mathcal{L}\big(\hat{y}_j^{(i)},y_j^{(i)}\big), $$
其中 $\mathcal{L}$ 是二元交叉熵。若某些图片只标了一部分(例如只标了有没有行人,其他标“?”),求和时只对标了 0/1 的项求和即可。
用一个网络做 4 件事,通常比训练 4 个独立网络效果更好,因为前几层学到的特征可以共享。
“只对标了 0/1 的项求和”用一个掩码实现。把未标注的项记为 $-1$:
1 | def multitask_bce(logits, Y): |
这里不能用 softmax:一张图可以同时有多个 $1$,每个输出单元是独立的二分类。
多任务学习有意义的条件:
- 各任务能从共享的低层特征中受益;
- 通常各任务的数据量相近(每个任务都能从其他任务的大量数据中获益);
- 能训练一个足够大的网络同时做好所有任务(网络不够大时,多任务才会比分开训练差)。
- 数据量差太多时小任务会被大任务淹没,可给小任务加权,或先单独训头。
- 任务互相干扰、合在一起比分开更差,称为负迁移(negative transfer);这时拆开比硬融更好。
- 实践中迁移学习比多任务学习常用得多;目标检测是多任务学习的典型应用。
端到端学习
端到端学习(end-to-end learning):用一个网络直接学 $x\mapsto y$,取代由多个手工设计阶段组成的流水线。
▸例13 什么时候端到端
- 语音识别:传统流水线是 音频 → 特征(MFCC)→ 音素 → 单词 → 文本;端到端直接 音频 → 文本。数据少(约 3000 小时)时流水线更好;数据多(1 万到 10 万小时)时端到端更好。
- 门禁人脸识别:直接从摄像头原图识别身份很难(人可能站在不同位置、距离不同)。分两步更好:先检测人脸并裁剪放大,再把裁剪后的脸与数据库比对。每一步都更简单,而且每一步都有大量数据。
- 机器翻译:英文 → 文本分析 → … → 法文的流水线已被端到端取代,因为有大量 (英文, 法文) 句对。
- 由手部 X 光片估计儿童年龄:直接 图像 → 年龄 的数据很少;分两步——先从图像中分割出骨头、测量长度,再按骨骼长度与年龄的统计关系估计——效果更好。
- 优点:让数据说话,不强加人类的先验(例如“音素”可能只是语言学家的概念,未必是最好的中间表示);需要手工设计的组件更少。
- 缺点:需要大量 $(x,y)$ 数据;排除了一些可能有用的手工设计组件。数据少时,手工设计的知识是注入先验的主要途径。
- 关键问题:是否有足够的数据,学到从 $x$ 映射到 $y$ 所需复杂度的函数?
- 数据不够时,应拆成检测再识别、声学模型再语言模型,每一段都有自己的误差表。像素直接映射到方向盘在课上被当作反例:错了无法判断错在感知还是规划。实际的自动驾驶系统是 图像 → 检测车辆和行人(深度学习)→ 路径规划 → 转向控制(运动规划),只在适合的环节用深度学习。
数据与迭代
学习曲线
学习曲线(learning curve)把训练误差和 dev 误差画成训练样本量 $m$ 的函数。它回答的是“再加数据有没有用”,而不是再换一种层。
- 两条曲线都高、且已经靠近:偏差大。加数据帮助有限,应加容量、换特征或修优化。
- 训练低、dev 高,dev 曲线仍随 $m$ 下降:方差大,继续加与 train 同分布的数据通常有效。
- 训练低、dev 高,但 dev 已经走平:再爬同类网页帮助变小,应改正则、增强,或改收集更接近部署的数据。
- 横轴必须是样本量,不能只画 epoch。epoch 曲线看的是优化是否在走,学习曲线看的是数据是否够。
数据规模与模型
| 带标签样本大约 | 常见做法 |
|---|---|
| 几十到几百 | 强预训练加线性头,或非深度基线;先把标注协议写稳 |
| 约 $10^{3}$–$10^{4}$ | 小网络或冻结骨干微调;dev 至少约 200–1000 条才比较得出 $1\%$ 级差别 |
| 约 $10^{5}$ | 可以从零训中等 CNN / 浅层 Transformer;仍建议用预训练起步 |
| 约 $10^{6}$ 及以上 | 更深的网才吃得下;dev/test 按绝对数量留 1 万级,不必再按 20% 切 |
- 小模型加数据很快到顶;容量足够时,数据继续增加,误差往往还能降。
- 样本很少时,先估计标注成本和增强上限,再决定是否加深网络。加深而数据不够,训练误差会降、dev 会升。
迭代节奏
- 先做一个能跑通的基线:逻辑回归、小 CNN、或冻结骨干加线性头。同一天把训练和 dev 评估管道打通。
- CS230 Section 3 的建议:先找一个与题目接近的开源代码库,复现它报告的结果作为基线(baseline)。基线既是精度的起点,也是后面更复杂模型的比较对象。代码先在本机或 Colab 上用一小部分数据跑通、确认没有 bug 且输出合理,再搬到 GPU 实例上跑全量,避免把算力额度花在调 bug 上。
- 一次迭代只做误差表支持的一件改动。第一周先跑通基线,不换未经验证的大模型。
- 增强(翻转、裁剪、颜色抖动、SpecAugment)只作用在 train 上,并且要在 dev 上确认有用。增强代替不了目标分布的真实样本。
- 标签质量差会形成误差地板:模型再强也超不过互相矛盾的标注。
- 人工标注:先写协议、抽一小批算标注者一致性,再铺开。一致性低就先改协议。
案例
Course 3 的两个书面案例是策略部分的考试重点。
- 鸟类识别(Peacetopia)
- 城市要识别鸟;
- 准确率是优化指标;运行时间、内存是满意度指标;
- 人类水平约 $0\%$;若训练误差 $4\%$、dev $9\%$,先降方差(数据、正则),不是无限制加深网络;
- 照片从互联网换成手机拍摄后,dev 分布变了:必须重建与部署一致的 dev/test;
- 不能继续用旧互联网 dev 做模型选择;
- 错误分析若显示“雾天”占大部分,优先收集雾天数据;
- 把测试集拿来调参会污染最终数字。
- 自动驾驶
- 检测交通灯、行人等;
- 可做成多任务:一个网络多个头(例 12);
- 某任务数据极少时,多任务可能被大数据任务主导,需要加权或分阶段训练;
- 端到端“像素到方向盘”在数据不足时不可诊断;
- 拆成检测、跟踪、规划后,每一段都有自己的误差分析;
- 雷达与摄像头融合时,传感器时间不同步属于数据对齐问题;换 Adam 或加大网络不能修复时间戳错位。
▸例14 避免不可比的指标
- 模型 A:准确率 $97\%$,延迟 $150\,\mathrm{ms}$。
- 模型 B:准确率 $95\%$,延迟 $40\,\mathrm{ms}$。
- 产品要求 $<100\,\mathrm{ms}$ 时,A 直接不合格。
- 先过滤满意度约束,再在合格者中比优化指标。
- 加权成单一数字也可以,但权重必须事先写进提案。
▸四类失败
- 训练误差高:偏差或优化失败。损失若不降,先查学习率与实现;下降后仍高,再加容量。
- 训练低、dev 高、且同分布:方差。加数据或正则。
- 训练-开发低、真实 dev 高:分布不匹配。
- 开发集指标高、部署差:dev 的采集方式与部署不一致。先重建划分,再改模型。
▸衔接
策略部分不指定用哪一种层。到目前为止网络都是全连接的,而图像上用全连接会丢掉“邻近像素更相关”这一先验,参数量也会爆炸。下一部分把 $WA$ 换成卷积,反向接口仍是 $\mathrm{d}W,\mathrm{d}X$。
卷积与视觉
前面的网络都是全连接的:每个神经元与上一层所有神经元相连。图像数据有两个特点让全连接很不合适:一是维度高(一张 $1000\times 1000$ 的彩色图有 300 万个输入),二是有空间结构(相邻像素关系密切,远处像素关系弱)。卷积网络(CNN)用“局部连接 + 权重共享”同时解决这两个问题。
这一部分的路线是:
- 卷积网络:卷积、填充、步幅、池化这些基本运算,以及它们的实现与反向传播;
- 深度卷积:为什么要加深,以及 VGG、ResNet、Inception、MobileNet 这些经典结构如何让深网络训得动、算得起;
- 目标检测与分割:输出从“一个标签”变成“若干个框”或“每个像素一个标签”;
- 人脸与风格:输出变成嵌入向量,或者干脆优化输入像素本身。
卷积网络(Convolutional Neural Network)
动机
▸卷积
一张图若先展平再全连接,参数随长宽暴涨,而且还假定任意两个像素同等相关。卷积用同一块小核在图上滑,邻近像素共享权重。LeNet-5(1998)已经这样用,AlexNet / VGG 之后成为视觉默认。作业和框架里说的“卷积”,多数其实是互相关,核不翻转。
全连接层的根本问题是忽视了数据的形状。图像是高 × 宽 × 通道的三维数据,空间上相邻的像素取值相近,RGB 各通道之间密切相关,相距很远的像素关系不大——这些模式都藏在三维形状里。但输入全连接层时,必须把它拉平成一维(MNIST 的 $(1,28,28)$ 被排成 784 个数),所有像素被当作“同一维度的神经元”平等对待,形状信息全部丢失。
卷积层则保持形状:以三维数据接收输入,同样以三维数据输出给下一层。卷积层的输入输出数据称为特征图(feature map),分为输入特征图与输出特征图。
卷积的两个关键性质:
- 权值共享(parameter sharing):同一个核扫完整张图。一个在左上角有用的特征检测器(如竖直边缘检测器),在右下角同样有用,没必要为每个位置学一套权重。
- 稀疏连接(sparsity of connections):每个输出只依赖输入中一个 $f\times f$ 的小区域,与其余像素无关。
- 由此得到平移等变(translation equivariance):输入平移后,特征图上的响应跟着平移,而不是整张图重算一套无关的权重。
▸例1 参数量对比
- 输入 $32\times32\times3$(3072 个数),输出 $28\times28\times6$(4704 个数)。全连接需要 $3072\times 4704\approx 1400$ 万个权重;用 6 个 $5\times5$ 卷积核只需 $(5\times5\times3+1)\times 6=456$ 个参数。
- 若全连接第一层有 1000 个单元,参数约 $3\times10^{6}$,且忽略了邻近像素更相关这一先验。
- 卷积核 $f\times f\times n_C$ 在所有位置共享,一层的参数量为 $f^{2} n_C n_C'$(再加偏置 $n_C'$),与输入的高宽无关;但计算量仍随空间尺寸线性增长。
卷积仍是线性运算,反向传播是这个线性算子的伴随(转置),层的接口(前向缓存、反向返回 $\mathrm{d}X,\mathrm{d}W,\mathrm{d}b$)与全连接层相同。
卷积运算
卷积运算相当于图像处理中的滤波器运算。滤波器(filter,也称核 kernel)以一定间隔在输入上滑动,在每个位置把滤波器元素与对应输入元素相乘再求和(乘积累加运算),结果写到输出的对应位置。
▸例2 二维卷积的数值计算(鱼书 7.2.2 节)
输入 $4\times 4$,滤波器 $3\times 3$:
$$ X=\begin{pmatrix}1&2&3&0\\0&1&2&3\\3&0&1&2\\2&3&0&1\end{pmatrix},\qquad K=\begin{pmatrix}2&0&1\\0&1&2\\1&0&2\end{pmatrix}. $$
滤波器从左上角开始,每次右移一格,共有 $2\times 2$ 个位置。左上角位置的计算为
$$ 1\cdot 2+2\cdot 0+3\cdot 1+0\cdot 0+1\cdot 1+2\cdot 2+3\cdot 1+0\cdot 0+1\cdot 2=15. $$
四个位置的结果为 $\begin{pmatrix}15&16\\6&15\end{pmatrix}$。CNN 中滤波器的参数就是权重,此外还有一个偏置:偏置只有一个数,加到所有输出元素上。若偏置为 3,输出变为 $\begin{pmatrix}18&19\\9&18\end{pmatrix}$。
▸例3 边缘检测(Ng 课上的例子)
$6\times 6$ 灰度图,左半边像素值为 10(亮),右半边为 0(暗),中间有一条竖直边缘。用竖直边缘检测器
$$ K=\begin{pmatrix}1&0&-1\\1&0&-1\\1&0&-1\end{pmatrix} $$
卷积,得到 $4\times 4$ 的输出,每一行都是 $(0,30,30,0)$:中间两列的大值正好标出了边缘位置,两侧平坦区域输出 0。若把图像左右反过来(左暗右亮),输出变为 $(0,-30,-30,0)$,正负号表示边缘是“由亮到暗”还是“由暗到亮”。
把核转置就得到水平边缘检测器。人工设计的变体还有 Sobel 核 $\begin{pmatrix}1&0&-1\\2&0&-2\\1&0&-1\end{pmatrix}$ 和 Scharr 核 $\begin{pmatrix}3&0&-3\\10&0&-10\\3&0&-3\end{pmatrix}$(给中间行更大权重)。深度学习的思路是:不手工设计这 9 个数,而是把它们当作参数,用反向传播学出来,网络可能学到 45°、70° 等任意方向的边缘检测器。
用公式写,单通道、步幅(stride)$s=1$、无填充(padding)时,核 $K\in\mathbb{R}^{f\times f}$ 与输入 $X$ 的运算为
$$ Z_{ij}=\sum_{u=0}^{f-1}\sum_{v=0}^{f-1}K_{uv}X_{i+u,j+v}+b. $$
数学上严格的卷积要先把核翻转 $180^{\circ}$ 再做上式,上式实际是互相关(cross-correlation)。由于核是学出来的,翻不翻转没有区别,深度学习中仍统称为卷积。
填充与步幅
填充
对 $4\times 4$ 的输入用 $3\times 3$ 的滤波器,输出缩小为 $2\times 2$。这带来两个问题:一是每卷积一次空间就缩小,深层网络卷几次就缩到 1,无法继续;二是边角像素只被少数几个窗口覆盖,信息被弱化。
填充(padding)在输入四周补上固定值(通常是 0)。幅度为 1 的填充让 $4\times 4$ 的输入变成 $6\times 6$,再用 $3\times 3$ 滤波器卷积,输出仍是 $4\times 4$,空间大小保持不变。填充幅度也可以设为 2、3 等任意整数($4\times4$ 变成 $8\times8$、$10\times10$)。
- valid:不填充,$p=0$,输出缩小。
- same:填充到输出与输入大小相同。$s=1$ 时需要 $p=(f-1)/2$,所以 $f$ 通常取奇数(3、5、7),这样两侧填充对称,而且滤波器有一个中心像素。
- full:填充 $p=f-1$,使滤波器与输入只要有一个像素重叠就计算一次,输出为 $n+f-1$,比输入还大。深度学习中很少直接用,但转置卷积的输出尺寸与它有关。
步幅 $s>1$ 时,“same”的含义推广为输出大小 $\lceil n/s\rceil$(TensorFlow 的 padding="SAME")。所需的总填充是
$$ p_{\text{总}}=\max\big((\lceil n/s\rceil-1)s+f-n,\ 0\big), $$
两侧各分一半,总数为奇数时多出的 1 像素放在右(下)侧。例如 $n=7$、$f=3$、$s=2$:$\lceil 7/2\rceil=4$,$p_{\text{总}}=3\cdot2+3-7=2$,两侧各填 1,输出 $4\times4$。
步幅
应用滤波器的位置间隔称为步幅(stride)。步幅为 2 时,窗口每次移动两格,兼具下采样效果。例如 $7\times 7$ 的输入、$3\times 3$ 滤波器、步幅 2,输出为 $3\times 3$。
增大步幅,输出变小;增大填充,输出变大。
输出尺寸公式
输入 $n_H\times n_W$、滤波器 $f\times f$、填充 $p$、步幅 $s$ 时:
$$ n_H'=\left\lfloor\frac{n_H+2p-f}{s}\right\rfloor+1,\qquad n_W'=\left\lfloor\frac{n_W+2p-f}{s}\right\rfloor+1. $$
推导:填充后长度为 $n+2p$,窗口左端可以落在 $0,s,2s,\dots$,只要窗口右端不超过边界,即 $ks+f\le n+2p$,所以 $k$ 最多取 $\lfloor(n+2p-f)/s\rfloor$,再加上 $k=0$ 这个位置。除不尽时向下取整,表示窗口一旦伸出边界就不再计算(有的框架会报错,有的会自动取整)。
▸例4 尺寸计算
鱼书的三个例子:
- 输入 $(4,4)$,$p=1$,$s=1$,滤波器 $(3,3)$:$\frac{4+2-3}{1}+1=4$,输出 $(4,4)$。
- 输入 $(7,7)$,$p=0$,$s=2$,滤波器 $(3,3)$:$\frac{7-3}{2}+1=3$,输出 $(3,3)$。
- 输入 $(28,31)$,$p=2$,$s=3$,滤波器 $(5,5)$:$n_H'=\frac{28+4-5}{3}+1=10$,$n_W'=\frac{31+4-5}{3}+1=11$,输出 $(10,11)$。
另一个例子:输入 $32\times32\times3$,核 $5\times5$,步幅 1,same padding:$p=2$,输出 $32\times32\times n_C'$。改为 valid、步幅 2:
$$ n'=\left\lfloor\frac{32-5}{2}\right\rfloor+1=14. $$
若再接 $2\times2$ 步幅 2 的池化,空间变为 $7\times7$。
多通道与多个滤波器
三维卷积
图像有 RGB 三个通道。三维数据的卷积要求滤波器的通道数与输入相同:输入 $n_H\times n_W\times n_C$,滤波器 $f\times f\times n_C$。在每个位置,把 $f\times f\times n_C$ 个元素逐一相乘后全部加起来(各通道分别卷积再相加),得到一个数。所以一个滤波器只输出一张特征图(通道数为 1)。
滤波器的空间大小可以任意($3\times3$、$5\times5$、$1\times1$),但通道数只能等于输入的通道数。若只想检测红色通道的竖直边缘,可以让绿、蓝通道的核全为 0。
多个滤波器
要在通道方向上得到多个输出,就用多个滤波器:$n_C'$ 个滤波器得到 $n_C'$ 张特征图,叠成 $n_H'\times n_W'\times n_C'$ 的输出,再传给下一层。每个滤波器检测一种特征(竖直边缘、水平边缘、某种颜色的斑块……)。
把数据想成长方体的“方块”更清楚(鱼书用通道在前的 $(C,H,W)$ 顺序):
- 输入 $(C,H,W)$,一个滤波器 $(C,FH,FW)$,输出 $(1,OH,OW)$;
- $FN$ 个滤波器组成四维权重 $(FN,C,FH,FW)$,输出 $(FN,OH,OW)$。例如 20 个通道数为 3、大小为 $5\times5$ 的滤波器,权重形状为 $(20,3,5,5)$;
- 每个滤波器一个偏置,偏置形状 $(FN,1,1)$,靠广播加到对应通道的每个位置上;
- 批处理时在最前面加批维:输入 $(N,C,H,W)$,输出 $(N,FN,OH,OW)$,$N$ 次处理汇成 1 次。
▸例5 一层的参数量
一层有 10 个 $3\times3\times3$ 的滤波器。每个滤波器有 $27$ 个权重加 $1$ 个偏置,共 $28$ 个参数;10 个滤波器共 $280$ 个参数。无论输入是 $64\times64$ 还是 $1000\times1000$ 的图像,参数都是 280 个,这正是卷积不易过拟合的原因之一。
第 $l$ 层的记号
CS230 对第 $l$ 层卷积的记号:
- 超参数:滤波器大小 $f^{[l]}$,填充 $p^{[l]}$,步幅 $s^{[l]}$,滤波器个数 $n_C^{[l]}$;
- 输入 $n_H^{[l-1]}\times n_W^{[l-1]}\times n_C^{[l-1]}$,输出 $n_H^{[l]}\times n_W^{[l]}\times n_C^{[l]}$,其中 $n_H^{[l]}=\lfloor(n_H^{[l-1]}+2p^{[l]}-f^{[l]})/s^{[l]}\rfloor+1$;
- 每个滤波器 $f^{[l]}\times f^{[l]}\times n_C^{[l-1]}$;全部权重 $f^{[l]}\times f^{[l]}\times n_C^{[l-1]}\times n_C^{[l]}$;偏置 $n_C^{[l]}$ 个;
- 激活 $A^{[l]}$:$m\times n_H^{[l]}\times n_W^{[l]}\times n_C^{[l]}$(作业中 batch 维在前,NHWC)。
实现
朴素实现
1 | def conv2d_forward(X, W, b, stride=1, padding=0): |
- 教学实现是 $O(m n_H' n_W' n_C' f^{2} n_C)$ 的多重循环,NumPy 中用 for 循环访问元素非常慢。
np.pad在高、宽两侧各加 $p$ 行/列零。same 且 $s=1$、$f$ 为奇数时两侧对称;$f$ 为偶数时 same 无法完全对称,框架把多出的 1 像素分到一侧,作业一般避开偶数核。
用 PyTorch 对拍朴素实现。两边的排布不同:作业是 X: (m, H, W, C)、W: (f, f, C_in, C_out);PyTorch 是 X: (m, C, H, W)、W: (C_out, C_in, f, f)。另外,深度学习里的“卷积”实际是互相关,两边都不翻转核,所以转置排布后结果就能一致:
1 | import torch.nn.functional as F |
nn.Conv2d(C_in, C_out, kernel_size=f, stride=s, padding=p) 是带参数的模块版本,参数量为 $(f^{2}C_{\mathrm{in}}+1)C_{\mathrm{out}}$;padding="same" 只在 stride=1 时可用。
im2col
生产环境把卷积转成一次大矩阵乘法。im2col(image to column)把输入中每个滤波器要覆盖的区域(一个 $C\times FH\times FW$ 的小方块)展开成一行,所有位置的行堆成一个二维矩阵;滤波器也展开,每个滤波器成为一列。于是卷积变成:
$$ \underbrace{\text{col}}_{(N\cdot OH\cdot OW,\ C\cdot FH\cdot FW)}\times\underbrace{\text{col_W}}_{(C\cdot FH\cdot FW,\ FN)}=\underbrace{\text{out}}_{(N\cdot OH\cdot OW,\ FN)}, $$
再 reshape 回 $(N,OH,OW,FN)$ 并转置成 $(N,FN,OH,OW)$。这与全连接的 Affine 层完全相同。
▸例6 im2col 的形状
- 输入 $(1,3,7,7)$,滤波器 $5\times5$,步幅 1,无填充:输出空间 $3\times 3=9$ 个位置,每个位置展开 $3\times5\times5=75$ 个元素,
col形状 $(9,75)$。 - 批大小改为 10,输入 $(10,3,7,7)$:
col形状 $(90,75)$。 - 滤波器 $(10,3,5,5)$ 共 750 个元素,
reshape(10, -1)得 $(10,75)$,转置后为 $(75,10)$。
1 | class Convolution: |
- 代价:相邻窗口重叠时,同一个输入元素会被复制到多行,内存消耗比朴素实现大。
- 好处:归结为大矩阵乘法后,可以利用高度优化的线性代数库(BLAS),GPU 也更擅长处理大块汇总数据。Caffe、Chainer 等框架的卷积层都基于 im2col。
- 反向传播与 Affine 层相同,最后用逆操作 col2im 把梯度加回原位置。
- 其他加速方法:Winograd、FFT、cuDNN。
$1\times 1$ 卷积
$1\times 1$ 卷积不看邻域,只在通道维做线性组合(再加非线性),相当于对每个像素位置做一次全连接,参数 $n_C n_C'$。用途是改变通道数:例如 $28\times28\times192$ 的输入经过 32 个 $1\times1\times192$ 的滤波器,得到 $28\times28\times32$。它不是“没用的卷积”,而是 Inception 与 bottleneck 结构中控制计算量的开关(见后文)。
反向传播
▸卷积反向
记前向 $Z=X * K$。$\partial J/\partial K$ 是 $X$ 与 $\mathrm{d}Z$ 的互相关:每个核位置把所有窗口与对应输出梯度相乘再求和。$\partial J/\partial X$ 是 $\mathrm{d}Z$ 与 $180^{\circ}$ 翻转核的卷积,并处理步幅造成的空洞(把 $\mathrm{d}Z$ 的像素之间插入 $s-1$ 个零)。偏置梯度是 $\mathrm{d}Z$ 在 batch 与空间维上的和。池化反向不学习参数,只路由梯度。
直观理解:前向时每个输出 $Z_{hw}$ 是一个窗口与核的内积。按乘法节点的规则,$Z_{hw}$ 的梯度会流回两处:
- 流向核:$\mathrm{d}K\mathrel{+}=\text{窗口}\times\mathrm{d}Z_{hw}$(核在所有位置共享,所以梯度要把所有位置累加);
- 流向输入:$\mathrm{d}\text{窗口}\mathrel{+}=K\times\mathrm{d}Z_{hw}$(窗口重叠处的梯度也要累加)。
1 | def conv2d_backward(dZ, cache): |
- 卷积层是否除以 $m$,取决于损失是否已对 batch 平均。与全连接保持同一约定:损失含 $1/m$ 则梯度也含 $1/m$。
池化
▸池化
池化在 $f\times f$ 窗口内取最大或平均,降低空间分辨率,一般没有可学参数。max 的反向只把梯度送到 argmax。较新的骨干常用步幅卷积做下采样,分类头仍常用全局平均池化。
池化(pooling)是缩小高、宽方向空间的运算。最大池化(max pooling)取窗口中的最大值,平均池化(average pooling)取均值。图像识别中主要用最大池化。窗口大小一般与步幅相同($2\times2$ 配步幅 2,$3\times3$ 配步幅 3)。
▸例7 最大池化(鱼书 7.3 节)
对 $4\times4$ 输入做 $2\times2$、步幅 2 的最大池化:
$$ \begin{pmatrix}1&2&1&0\\0&1&2&3\\3&0&1&2\\2&4&0&1\end{pmatrix} \ \longrightarrow\ \begin{pmatrix}2&3\\4&2\end{pmatrix}. $$
每个 $2\times2$ 区域只保留最大值。
池化层的三个特征:
- 没有要学习的参数:只是取最大值或平均值。超参数 $f,s$ 是固定的。
- 通道数不变:每个通道独立计算,$n_H\times n_W\times n_C\rightarrow n_H'\times n_W'\times n_C$。
- 对微小位置变化稳健:输入在宽度方向偏移 1 个像素时,最大池化往往返回相同结果。直观上,最大池化表示“这个区域里只要某处检测到该特征就保留”。
反向传播:最大池化只把梯度送到前向时最大值所在的位置,其余位置为 0(与 ReLU 的反向类似,前向时记下 argmax 掩码);平均池化把梯度均分给窗口内每个位置。
1 | def pool_forward_cached(A_prev, f=2, s=2, mode="max"): |
窗口内有并列最大值时,上面的掩码会把梯度同时给所有最大值;C4 作业与 PyTorch 只给其中一个。要对拍时可以改用
argmax只取第一个。PyTorch 对应
nn.MaxPool2d(kernel_size=2, stride=2)与nn.AvgPool2d(2, 2),输入是 NCHW:x.permute(0, 3, 1, 2)把 NHWC 转成 NCHW。现代网络常用步幅卷积代替大范围池化。
分类头前仍广泛使用全局平均池化(global average pooling)。
典型结构
一个 CNN 由三种层组成:卷积层(CONV)、池化层(POOL)、全连接层(FC)。全连接网络中的 “Affine → ReLU” 被替换为 “Conv → ReLU →(Pool)”(池化有时省略);靠近输出的层仍使用 “Affine → ReLU”,最后用 “Affine → Softmax” 输出。
$$ \mathrm{Conv}\rightarrow\mathrm{ReLU}\rightarrow\mathrm{Conv}\rightarrow\mathrm{ReLU}\rightarrow\mathrm{Pool} $$
重复若干次后展平或全局平均,再接全连接或卷积分类头。整体趋势是空间逐渐变小、通道逐渐变多(LeNet、AlexNet、VGG 都是如此)。
▸例8 一个类 LeNet-5 的网络(Ng 课上的例子)
输入 $32\times32\times3$:
| 层 | 输出 | 激活大小 | 参数量 |
|---|---|---|---|
| 输入 | $32\times32\times3$ | 3072 | 0 |
| CONV1($f=5,s=1$,6 个) | $28\times28\times6$ | 4704 | $(5\cdot5\cdot3+1)\cdot6=456$ |
| POOL1($f=2,s=2$) | $14\times14\times6$ | 1176 | 0 |
| CONV2($f=5,s=1$,16 个) | $10\times10\times16$ | 1600 | $(5\cdot5\cdot6+1)\cdot16=2416$ |
| POOL2($f=2,s=2$) | $5\times5\times16$ | 400 | 0 |
| FC3 | 120 | 120 | $400\cdot120+120=48120$ |
| FC4 | 84 | 84 | $120\cdot84+84=10164$ |
| Softmax | 10 | 10 | $84\cdot10+10=850$ |
规律:池化层没有参数;卷积层参数很少;大部分参数在全连接层;激活大小随深度逐渐减小,但不能减得太快。
例 8 的网络用 PyTorch 写出来,并核对表中的参数量与形状:
1 | lenet = nn.Sequential( |
▸例9 鱼书的 SimpleConvNet
结构为 Conv(30 个 $5\times5$ 滤波器,$p=0$,$s=1$)→ ReLU → Pool($2\times2$)→ Affine(100)→ ReLU → Affine(10)→ Softmax。在 MNIST 上训练集识别率 $99.82\%$,测试集 $98.96\%$,对小网络而言已经很高。
感受野
感受野(receptive field)指输出中一个像素所依赖的输入区域。
- 一层 $f\times f$、步幅 1 的卷积:感受野增加 $f-1$。
- 一般公式(第 $k$ 层,$F_j$ 为第 $j$ 层核大小,$S_i$ 为第 $i$ 层步幅,约定 $S_0=1$):
$$ R_k=1+\sum_{j=1}^{k}(F_j-1)\prod_{i=0}^{j-1}S_i. $$
例如两层 $3\times3$、步幅 1:$R_2=1+2+2=5$。
- 步幅与池化会快速扩大感受野(后面层的增量要乘以前面所有步幅)。
- 过早下采样会丢掉定位信息,对检测与分割不利。
小核堆叠
VGG 用堆叠的 $3\times3$ 代替大核,原因可以定量说明:
两层 $3\times3$ 的感受野等于一层 $5\times5$;参数 $2\times9=18$ 对 $25$(单通道)。
三层 $3\times3$ 的感受野为 7,与一层 $7\times7$ 相同;参数 $3\times9=27$ 对 $49$。考虑通道时为 $3\cdot 9\cdot C^{2}$ 对 $49 C^{2}$。
而且多了两次 ReLU,非线性表达能力更强。
通道通常按阶段(stage)倍增:64 → 128 → 256 → 512,同时空间减半,使每层计算量大致均衡。
全局平均池化:最后一张特征图每通道求平均,得到 $n_C$ 维向量再分类;去掉大全连接层,减轻过拟合。
全连接层可以写成卷积
全连接层的每个输出与全部输入相连,这可以用卷积等价实现:对 $32\times10\times10$(通道 32、高宽 10)的输入,一个输出 100 个节点的全连接层,等价于 100 个 $32\times10\times10$ 的滤波器。这个事实在后面的“卷积化滑动窗口”和 FCN 分割中都会用到。
1D 与 3D 卷积
卷积不限于二维图像。心电图等一维信号可以用一维卷积(例如长度 14 的信号用 16 个长度 5 的核,得到 $10\times16$);CT 等三维体数据或视频(时间作为第三维)可以用三维卷积,滤波器为 $f\times f\times f\times n_C$。
可视化
卷积层到底在“看”什么?
- 第一层权重:鱼书 SimpleConvNet 第一层有 30 个 $5\times5$ 的单通道滤波器,可以直接画成灰度图。学习前是随机噪声;学习后变成有规律的图案,如从白到黑渐变的滤波器(响应竖直或水平边缘)和含块状区域的滤波器(响应斑块,blob)。
- 深层:Zeiler & Fergus 等的可视化研究表明,层越深提取的信息越抽象。在 8 层的 AlexNet 中,第 1 层对边缘和斑块响应,第 3 层对纹理响应,第 5 层对物体部件响应,最后的全连接层对物体类别(狗、车)响应。
这与人理解事物“含义”的方式类似:从简单形状逐渐组合成高级概念。
经典网络
- LeNet(LeCun, 1998):最早的 CNN,用于手写数字识别,约 6 万参数。连续的卷积层与子采样层,最后接全连接层。与现在的 CNN 相比,激活函数用 sigmoid(现在用 ReLU),用子采样(subsampling)缩小特征图(现在主流是最大池化)。
- AlexNet(Krizhevsky et al., 2012):引发深度学习热潮的网络,结构与 LeNet 基本相同,约 6000 万参数。不同点:激活函数用 ReLU;使用局部响应归一化(LRN,后来被证明作用不大);使用 Dropout。更大的变化在环境:大规模数据(ImageNet)可得,擅长大规模并行计算的 GPU 普及。大数据和 GPU 是深度学习发展的原动力。
▸衔接
卷积的尺寸公式、实现与反向已经对齐。下一步自然是把网络加深。但直接再堆很多层时,训练误差可能不降反升。下一节先说明加深的好处,再介绍让深网络训得动(残差)、算得起(Inception、深度可分卷积)的结构。加 Dropout 压的是方差,修不了训练误差上升。
深度卷积(Deep CNN Architectures)
加深的动机
单层卷积可以堆很多层,但训练误差可能不降反升,计算量也会涨得很快。残差给反向一条捷径;Inception 和深度可分卷积用结构换计算量;迁移学习把 ImageNet 上训好的骨干接到新任务上。在讨论这些结构之前,先说明为什么要加深。
加深的重要性在理论上尚不透彻,但有几点可以从实验和直觉解释:
- 参数更少:如上节所示,堆叠小核可以用更少的参数达到同样的感受野。
- 表现力更强:每层之间夹着 ReLU,非线性函数叠加得越多,能表示的函数越复杂。
- 学习更高效:网络分层提取信息,浅层只需学边缘这样的简单模式。识别“狗”时,浅层网络必须一下子理解狗的所有特征,狗的种类与拍摄环境千差万别,需要大量多样的数据;深层网络把问题分解,第一层只学边缘——包含边缘的图像远多于包含狗的图像,边缘的模式也简单得多——后一层再利用边缘信息学更高级的模式,每层要学的问题都变简单了。
注意:近年的深层化是由大数据和计算能力支撑的,没有这些,加深层也学不好。
▸例10 鱼书的深层 CNN(MNIST)
参考 VGG 搭建的网络:卷积层全部用 $3\times3$ 小滤波器,通道数依次为 16、16、32、32、64、64,每两层卷积后接池化;全连接层后接 Dropout;He 初始化;Adam 优化。
测试集识别率 $99.38\%$,错误率仅 $0.62\%$。被识别错的图像连人也难以判断:“1”和“7”、“0”和“6”、“3”和“5”最容易混淆。
截至 2016 年 6 月,MNIST 上的最高识别率为 $99.79\%$,所用的 CNN 并不深(2 个卷积层 + 2 个全连接层):手写数字识别这类简单任务不需要很强的表现力,加深的好处不大;而大规模一般物体识别问题复杂,加深层才大有裨益。进一步提高精度的技巧有集成学习、学习率衰减和数据增强(Data Augmentation),其中数据增强方法简单但效果显著。
ImageNet 与 ILSVRC
ImageNet 是拥有超过 100 万张带标签图像的数据集,每年举办的 ILSVRC 大赛中有一项是 1000 类分类,以 top-5 错误率(前 5 个预测中都不含正确类别的比例)评价。2012 年 AlexNet 以压倒性优势胜出(top-5 错误率约 $15\%$,第二名约 $26\%$),此后冠军一直是深度学习方法,且网络越来越深。2015 年超过 150 层的 ResNet 把错误率降到 $3.5\%$,据说超过了普通人的识别能力。
VGG
VGG(Simonyan & Zisserman, 2014)结构非常规整:
- 卷积层全部是 $3\times3$、步幅 1、same 填充;池化全部是 $2\times2$、步幅 2;
- 重复“卷积层堆叠 2 到 4 次,再用池化把空间减半”,通道依次为 64、128、256、512、512;
- 有权重的层共 16 层(VGG-16)或 19 层(VGG-19),VGG-16 约 1.38 亿参数,大部分在最后的全连接层。
VGG 在 2014 年 ILSVRC 中获得第 2 名(第 1 名是 GoogLeNet),性能稍逊,但因结构简单、应用性强,很多工程师喜欢以它为基础。
残差
▸残差
残差块(He et al., 2016)的输出是 $y=F(x)+x$。再往上堆层时,若训练误差不降反升,原因通常是优化,不是过拟合。捷径给反向一条不经过 $F$ 的通路;若最优映射接近恒等,$F$ 只需学接近 0。
退化问题
理论上,更深的网络至少不会比浅的差:多出来的层只要学成恒等映射即可。但实验中,普通网络(plain network)层数超过一定程度后,训练误差反而上升。这不是过拟合(过拟合是训练误差低、测试误差高),而是优化困难:让一串非线性层精确地学出恒等映射并不容易,梯度也会在长链上消失或爆炸。
残差块
ResNet(微软研究院)引入快捷连接(shortcut / skip connection):把输入 $x$ 跳过两层卷积,直接加到输出上。原来两层卷积的输出 $F(x)$ 变成 $F(x)+x$:
$$ y=F(x)+x. $$
用 CS230 的记号,对两层的残差块:
$$ a^{[l+2]}=g\big(z^{[l+2]}+a^{[l]}\big). $$
为什么好学:若最优映射接近恒等,只需让 $F$ 学成接近 0。权重衰减本来就会把 $W^{[l+2]}$、$b^{[l+2]}$ 往 0 推,此时 $a^{[l+2]}=g(a^{[l]})=a^{[l]}$(ReLU 下 $a^{[l]}\ge 0$)。所以加一个残差块,最坏也不会让网络变差,好的话还能学到有用的东西。
反向传播时梯度可以“无衰减”地传递:
$$ \frac{\partial J}{\partial x}=\frac{\partial J}{\partial y}\cdot\left(1+\frac{\partial F}{\partial x}\right). $$
即使 $F$ 的雅可比很小,仍有 $1$ 这条路:上游梯度原封不动地传向下游,不必担心梯度在深层中变小。这与 LSTM 的 $c^{\langle t\rangle}=c^{\langle t-1\rangle}+\cdots$ 是同一思想:加法路径保梯度。实验表明,ResNet 即使加深到 150 层以上,识别精度仍持续提高。
- 残差块学习 $F(x)$,$F$ 与 $x$ 通道或尺寸不同时,用 $1\times1$ 卷积或步幅卷积做投影 $W_s x$。
- 恒等捷径使反向梯度多一条完整通路,减轻消失。
1 | def residual_block_forward(X, conv1, conv2): |
PyTorch 版的 BasicBlock(ResNet-18/34 的构件),同时处理 identity shortcut 与 convolutional shortcut:
1 | class BasicBlock(nn.Module): |
Bottleneck 与实现细节
- ResNet-50/101 用 bottleneck:$1\times1$ 降维 $\rightarrow 3\times3 \rightarrow 1\times1$ 升维,降低 $3\times3$ 卷积的通道成本。
- 例:输入通道 $C=256$,瓶颈宽 $C/4=64$;
- 每个位置的乘加从 $9\cdot 256\cdot 256\approx 59$ 万降到 $256\cdot 64 + 9\cdot 64\cdot 64 + 64\cdot 256\approx 7$ 万。
- 降采样块:第一层卷积步幅 2;捷径同步用步幅 2 的 $1\times1$ 卷积。
- 作业:identity shortcut(形状不变,直接相加)与 convolutional shortcut(捷径上有 $1\times1$ 卷积)必须分支清楚,否则相加时 shape 不对。
1 | def conv_bn_relu(X, W, b, gamma, beta, bn_cache, stride, padding, train): |
- ResNet-18 的阶段:conv1 后 $56\times56$;layer1 保持;layer2–4 各把空间减半、通道倍增。
- 实现时先让一个 block 的梯度检查通过,再堆 stage。
Inception 与深度可分
▸Inception 与深度可分
Inception(Szegedy et al.)在同一层并行 $1\times1$、$3\times3$、$5\times5$ 和池化,再沿通道拼接,让网络自己选尺度。$5\times5$ 之前先用 $1\times1$ 降维,否则通道乘加过贵。MobileNet 的深度可分卷积先逐通道做空间卷积,再用 $1\times1$ 混合通道,参数约为普通卷积的 $1/C+1/f^{2}$。
Inception(GoogLeNet)
设计卷积层时要决定用 $1\times1$、$3\times3$ 还是 $5\times5$,要不要池化。Inception 的思路是:全都要,在同一层并行使用多种大小的滤波器和池化,再把结果沿通道拼接,让网络自己学习用哪种尺度。GoogLeNet 以 Inception 模块为构件,不仅在纵向上有深度,在横向上也有“宽度”,获得了 2014 年 ILSVRC 第 1 名。
问题是计算量。
▸例11 $1\times1$ 瓶颈层节省的计算量
输入 $28\times28\times192$,用 32 个 $5\times5$ same 卷积得到 $28\times28\times32$。每个输出要做 $5\times5\times192$ 次乘法,共有 $28\times28\times32$ 个输出:
$$ 28\cdot28\cdot32\times5\cdot5\cdot192\approx 1.2\times10^{8}. $$
先用 16 个 $1\times1$ 卷积降到 $28\times28\times16$(称为瓶颈层,bottleneck layer),再做 32 个 $5\times5$ 卷积:
$$ 28\cdot28\cdot16\times192\approx 2.4\times10^{6},\qquad 28\cdot28\cdot32\times5\cdot5\cdot16\approx 1.0\times10^{7}, $$
合计约 $1.24\times10^{7}$,降为原来的十分之一。只要瓶颈层不压得太狠,对性能影响不大。
- 一般地,参数从 $25 C C'$ 变为 $C n_{\mathrm{bot}}+25 n_{\mathrm{bot}} C'$。
- 池化分支后也要接 $1\times1$ 卷积,否则池化保持通道数(192),会让拼接后的通道过多。
- GoogLeNet 还在中间层接了辅助分类器(side branch),用中间特征也做预测,起正则作用。
- 作业不要求手写 Inception,但应能指出:并行分支的空间尺寸必须一致才能拼接,因此 same padding 与步幅要匹配。
深度可分卷积(MobileNet)
MobileNet 面向手机等算力有限的设备,把标准卷积分解为两步:
- depthwise(逐通道卷积):每个输入通道单独用一个 $f\times f$ 核卷积,输出通道数不变;
- pointwise(逐点卷积):用 $1\times1$ 卷积混合通道,得到想要的输出通道数。
计算量从 $f^{2} C_{\mathrm{in}} C_{\mathrm{out}}$(每个输出位置)降到 $f^{2} C_{\mathrm{in}}+C_{\mathrm{in}} C_{\mathrm{out}}$,比值为
$$ \frac{f^{2}C_{\mathrm{in}}+C_{\mathrm{in}}C_{\mathrm{out}}}{f^{2}C_{\mathrm{in}}C_{\mathrm{out}}}=\frac{1}{C_{\mathrm{out}}}+\frac{1}{f^{2}}. $$
▸例12 深度可分卷积的计算量
输入 $6\times6\times3$,用 5 个 $3\times3$ 滤波器(valid)得到 $4\times4\times5$。
- 标准卷积:$(3\cdot3\cdot3)\times(4\cdot4\cdot5)=2160$ 次乘法。
- depthwise:3 个 $3\times3$ 核,输出 $4\times4\times3$,$(3\cdot3)\times(4\cdot4\cdot3)=432$ 次;pointwise:5 个 $1\times1\times3$ 核,$(1\cdot1\cdot3)\times(4\cdot4\cdot5)=240$ 次;合计 $672$ 次。
- 比值 $672/2160\approx 0.31=\frac{1}{5}+\frac{1}{9}$。实际中 $C_{\mathrm{out}}$ 常为几百,$f=3$ 时约降为 $1/9$,快近 10 倍。
PyTorch 用 groups 参数实现 depthwise:groups=C_in 表示每个输入通道单独一组、各用自己的核。
1 | def depthwise_separable(c_in, c_out, stride=1): |
- MobileNet v2 在此基础上加入瓶颈块:先用 $1\times1$ 卷积扩展通道(例如扩大 6 倍),在高维空间做 depthwise 卷积,再用 $1\times1$ 卷积投影回低维,并加残差连接。扩展让网络在块内学到更丰富的函数,投影让块之间传递的激活保持很小,节省内存。
- depthwise 本身不混合通道;没有随后的 $1\times1$,网络无法组合红/绿边缘。
- EfficientNet 进一步研究如何同时缩放输入分辨率 $r$、深度 $d$、宽度 $w$,在给定算力下取得最好效果。
- DenseNet:每层的输入是前面所有层输出的拼接,特征复用更强、参数更省,但拼接占用显存;公开大纲列为选读。
迁移学习
▸迁移学习
迁移学习:在数据量大的源任务上先训练骨干,再换上目标任务的输出头。低层核往往接近边缘与纹理检测,目标样本少时只训练头;样本多了再解冻后几层,并用更小的学习率。源域与目标域相差很大时,仍可作初始化,但应更快解冻或改用领域内权重。
在 ImageNet 上训练一个大网络要花几周,而别人已经训练好并公开了权重。实践中常把这些权重复制到自己的网络作为初始值,再在新数据集上继续训练(fine-tuning)。手头数据少时,迁移学习尤其有效。ImageNet 预训练的低层核接近 Gabor 式边缘检测器,对多数自然图像可复用。
步骤:
- 加载预训练骨干,去掉原分类头(例如 ImageNet 的 1000 类 softmax)。
- 加任务头,随机初始化。
- 目标数据少:冻结骨干,只训头。一个加速技巧是把训练集图像先过一遍冻结的骨干,把输出特征存到磁盘,之后只在这些特征上训练一个浅层分类器。
- 目标数据中等:冻结前面若干层,训练后面几层和头。
- 目标数据多:解冻全部或后几段,用预训练权重初始化,学习率比从头训练小一个数量级。
- 医学影像、卫星图与 ImageNet 域差大:仍常从预训练起步,但应更快解冻,或改用领域内预训练。
- 迁移不是免费性能:输入通道数不同(灰度、多光谱)时,第一层核需要适配或重训。
- 冻结骨干时,输入预处理必须与预训练一致(尺寸、均值、缩放),否则等于给网络看另一种分布。
- CS230 作业用 MobileNet 做迁移学习:冻结卷积骨干;替换并训练分类头;必要时用小学习率微调后几层。
PyTorch 中三档数据量对应三种冻结方式(以 torchvision 的 ResNet-18 为例):
1 | from torchvision import models |
- 冻结骨干时,骨干里的 BatchNorm 仍会在
train()模式下更新运行均值。数据很少时,可以在训练时把这些 BN 层单独设成eval(),保持预训练统计量。 - 预处理要与预训练一致:ImageNet 权重配 224 输入和上面
Normalize的均值方差。 - 第 3 步“先把特征存盘”的写法:
with torch.no_grad(): feats = backbone(x),存下feats后只训练一个线性层。
数据增强
计算机视觉几乎总是缺数据,数据增强(data augmentation)对视觉任务几乎总有帮助:
- 几何变换:镜像翻转、随机裁剪、小角度旋转、平移、缩放、剪切(shearing)、局部扭曲;
- 颜色变换:对 RGB 通道加不同的偏移(模拟光照变化),PCA 颜色增强(AlexNet 论文);亮度、对比度变化;
- 其他:加噪声、随机遮挡部分区域。
只有在不改变标签语义时才能使用(翻转对文字或左右不对称的场景无效)。大规模训练时,常用 CPU 线程实时做增强,同时 GPU 训练,两者并行。
计算加速
深度学习需要大量运算。在 AlexNet 的前向计算中,卷积层的时间占 GPU 总时间的 95%、CPU 的 89%。卷积归根结底是大量乘积累加运算,所以加速的核心是高效地做大规模乘积累加。
- GPU:GPU 擅长大规模并行数值计算(CPU 擅长连续的复杂计算)。用 16 核 Xeon CPU 训练 AlexNet 要 40 天以上,用 GPU 缩短到 6 天左右,再用 NVIDIA 为深度学习优化的 cuDNN 库还能更快。大多数框架基于 NVIDIA 的 CUDA 开发环境。im2col 把卷积汇总成大矩阵乘法,正好发挥 GPU 的优势。
- 分布式学习:在多个 GPU 或多台机器上并行。TensorFlow、CNTK 等框架重视分布式学习;基于 TensorFlow,100 个 GPU 相比 1 个 GPU 约快 56 倍,原本 7 天的训练 3 小时完成。难点在于机器间通信与数据同步。
- 降低数值精度:内存容量和总线带宽也会成为瓶颈。神经网络对噪声稳健,并不需要很高的数值精度:16 位半精度浮点数(half float)也能顺利训练,NVIDIA Pascal 架构开始支持 16 位运算,有望比上一代快约 2 倍。更激进的 Binarized Neural Networks 用 1 位表示权重和中间数据。位数缩减对嵌入式部署尤其重要。现代训练常用混合精度(权重主副本用 32 位,前向反向用 16 位)。
NumPy 中可以直接看到半精度的局限:表示范围窄,小梯度会下溢为 0。
1 | print(np.finfo(np.float16)) # max ≈ 65504,最小正规数 ≈ 6.1e-5 |
这就是 loss scaling 的原理:把损失乘一个大数 $S$ 再反向,梯度整体放大、不再下溢;更新前再除以 $S$。PyTorch 的自动混合精度(AMP)把两件事都自动化了:
1 | device = "cuda" |
- 支持 bfloat16 的 GPU(A100 及之后)可以用
dtype=torch.bfloat16:它与 fp32 的指数位相同、不会下溢,不需要GradScaler。 - 单机多卡用
torch.nn.parallel.DistributedDataParallel:每张卡一份模型、各算一部分 batch,反向时对梯度做 all-reduce 平均。
▸衔接
卷积骨干输出的是空间特征图。到目前为止的分类头假定一张图只有一个标签。下一节改成检测:输出个数不固定,每个物体对应一个类别和一个框。
目标检测(Object Detection)
任务
视觉任务按输出的复杂程度可以分为三级:
- 图像分类:整张图一个类别(“这是车”)。
- 分类 + 定位:一张图一个主要物体,输出类别和它的边界框。
- 目标检测(object detection):一张图中可能有多个、多类物体,要标出每一个的类别和边界框 $(b_x,b_y,b_h,b_w)$。
检测比分类难得多:输出的个数不固定,并且要同时做分类和定位。骨干仍是上一节的卷积特征图。
分类与定位
先看最简单的情况:每张图最多一个物体,类别为行人、汽车、摩托车或背景。约定图像左上角为 $(0,0)$、右下角为 $(1,1)$,网络输出
$$ y=\big[p_c,\ b_x,\ b_y,\ b_h,\ b_w,\ c_1,\ c_2,\ c_3\big]^{\top}, $$
其中 $p_c$ 表示是否有物体,$(b_x,b_y)$ 是框的中心,$b_h,b_w$ 是高和宽,$c_1,c_2,c_3$ 是类别。损失按 $p_c$ 分情况:
- $y_1=p_c=1$(有物体):所有 8 个分量都计入损失;
- $y_1=0$(背景):只计 $(\hat{y}_1-y_1)^2$,其余分量无意义,不计入。
实践中,$p_c$ 用逻辑回归损失,框坐标用平方误差,类别用 softmax 交叉熵。
特征点检测(landmark detection)是同一思路的推广:让网络输出若干关键点坐标,例如人脸的 64 个关键点(眼角、嘴角、下巴轮廓),输出 $1+2\times64=129$ 个数(是否有脸 + 每个点的 $x,y$)。可用于表情识别、AR 滤镜、人体姿态估计。所有训练图像中关键点的编号顺序必须一致。
滑动窗口
滑动窗口(sliding window)检测:先训练一个对裁剪好的小图做分类的 CNN,再在大图上按多种尺度、以一定步幅切出矩形窗口,每个窗口送进分类器,判断里面有没有物体。
- 在多尺度窗口上跑分类器,相邻窗口特征重复,计算量巨大;步幅大则定位粗糙,步幅小则更慢。
- 卷积化:把分类器中的全连接层改写成卷积,一次前向就能得到空间图上每个位置的分类结果,等价于所有对齐的滑动窗口,重叠部分的计算被共享。
▸例13 滑动窗口的卷积实现
分类器输入 $14\times14\times3$:16 个 $5\times5$ 卷积 → $10\times10\times16$ → $2\times2$ 最大池化 → $5\times5\times16$ → FC 400 → FC 400 → softmax 4 类。
把第一个 FC 改成 400 个 $5\times5\times16$ 的卷积(输出 $1\times1\times400$),第二个 FC 改成 400 个 $1\times1$ 卷积,softmax 层改成 4 个 $1\times1$ 卷积(输出 $1\times1\times4$)。
现在输入 $16\times16\times3$ 的图,同一个网络输出 $2\times2\times4$:4 个位置分别对应以步幅 2 滑动的 4 个 $14\times14$ 窗口。输入 $28\times28\times3$ 时输出 $8\times8\times4$,一次前向完成 64 个窗口。这也解释了检测网络为何是全卷积的。
- 仍难以精确回归框,且宽高比不灵活:窗口位置不一定正好框住物体。
两阶段检测:R-CNN 系列
R-CNN(Regions with CNN)的思路是先找候选区域,再分类:
- 输入图像;
- 提取约 2000 个“看起来像物体”的候选区域(region proposals),原论文用 Selective Search 等传统方法(例如基于图像分割的色块);
- 把每个候选区域变形为固定大小,用 CNN 计算特征;
- 用分类器(原论文用 SVM)判断类别,并修正框。
R-CNN 很慢,因为每个候选区域都要单独跑一次 CNN。Fast R-CNN 用卷积化的方法一次算出全图特征,再对各区域取特征;Faster R-CNN 进一步用一个 CNN(区域提议网络,RPN)来产生候选区域,整个流程都由 CNN 完成,可以高速处理。两阶段方法定位较细,但通常比一阶段方法慢。
IoU 与 NMS
▸IoU 与 NMS
IoU(intersection over union)是两框交集面积除以并集面积。检测里用它判定正样本,mAP 也用它,但阈值含义不同。一张图通常会对同一物体给出多个高度重叠的框;NMS(non-maximum suppression)只保留分数最高的那个。Soft-NMS 降低重叠框的分数,而不是直接删掉,密集目标少被误杀。
交并比衡量预测框与真实框的重合程度:
$$ \mathrm{IoU}(A,B)=\frac{|A\cap B|}{|A\cup B|}\in[0,1]. $$
- 完全重合为 1,不相交为 0。按惯例 $\mathrm{IoU}\ge 0.5$ 视为定位正确(更严格可取 0.6、0.7)。检测正样本通常要求与真值 IoU 超过 $0.5$。
非极大值抑制(NMS):同一物体往往被多个格子或窗口检测到,产生多个重叠框,NMS 只保留最可信的那个。
- 丢掉置信度低于阈值(如 0.6)的框。
- 选出剩余框中置信度最高的,作为一个检测结果输出;删除所有与它 IoU 高于阈值(如 $0.5$)的同类框。
- 重复第 2 步直至没有剩余框。多类别时对每一类分别做 NMS。
- NMS 默认一个物体对应一个框;物体密集重叠时会误删。
- Soft-NMS 等变体降低重叠框的分数,而不是直接删除。
YOLO
▸YOLO
YOLO(You Only Look Once, Redmon et al., 2016)把图像划成 $S\times S$ 网格,物体中心落入的格子同时预测框和类别。一次前向出全部检测结果,延迟低于先提候选框再分类的两阶段方法。作业要求格子、anchor 与 NMS 对应正确,不要求复现当时精度。
网格预测
YOLO 把“分类 + 定位”的输出向量用在网格的每个格子上:
- 把图划分为 $S\times S$ 网格(课上用 $3\times3$ 演示,实际常用 $19\times19$)。
- 物体中心落入的格子负责预测该物体,即使物体跨越多个格子,也只分配给一个格子。
- 每个格子输出一个 $[p_c,b_x,b_y,b_h,b_w,c_1,\dots,c_C]$ 向量。$3\times3$ 网格、3 类时,输出为 $3\times3\times8$。
- $(b_x,b_y)$ 相对于所在格子表示,在 $[0,1]$ 内;$b_h,b_w$ 相对于格子边长,可以大于 1。
- 由于是一个卷积网络一次前向得到所有格子的输出,速度很快,可以实时检测。
更一般地,每个格子预测 $B$ 个框及置信度和 $C$ 类概率,输出张量形状约为
$$ S\times S\times\big(B\cdot(5+C)\big), $$
或在后来的版本中把类别与框解耦。
Anchor box
一个格子只能检测一个物体。若行人和汽车的中心落在同一格子里怎么办?Anchor box(锚框)事先给定一组不同形状的框(如一个瘦高的适合行人,一个扁宽的适合汽车),每个格子对每个 anchor 各输出一组预测。2 个 anchor 时,$3\times3$ 网格的输出变为 $3\times3\times16$($2\times8$)。
- Anchor 是事先给定的宽高比和尺度,不是网络学出来的(可以用 k-means 对训练集的框聚类得到)。
- 匹配:每个真值框分配给中心所在的格子,以及该格子中与它 IoU 最高的 anchor。
- 除了处理重叠,anchor 还让每组输出专门化:瘦高的 anchor 输出专门学行人。
- 两个物体中心在同一格且形状又和同一个 anchor 最匹配,或物体数超过 anchor 数,算法处理不好,但这种情况很少。
▸例14 作业中的 YOLO 输出
输入 $608\times608\times3$,网格 $19\times19$,5 个 anchor,80 类(COCO)。每个 anchor 输出 $5+80=85$ 个数,所以输出形状为 $19\times19\times5\times85$,展平最后两维为 $19\times19\times425$。
后处理:对每个 anchor 计算类别得分 $p_c\times c_i$,取最大的类及其得分;丢掉得分低于阈值(如 0.6)的框;对剩下的框按类做 NMS(IoU 阈值 0.5)。
▸YOLO 框参数化(bounding-box parameterization)
设格子左上角坐标为 $(c_x,c_y)$,anchor 宽高为 $(p_w,p_h)$,网络输出原始数 $t_x,t_y,t_w,t_h$。常见解码为
$$ b_x=\sigma(t_x)+c_x,\qquad b_y=\sigma(t_y)+c_y,\qquad b_w=p_w e^{t_w},\qquad b_h=p_h e^{t_h}. $$
$\sigma$ 把中心限制在负责的格子附近,指数保证宽高为正。实现还会按网格或图像尺寸归一化。不同 YOLO 版本的具体参数化不同,考试若给了解码式,应按题目版本计算。
一阶段检测器(one-stage detector)如 YOLO 直接密集预测类别与框,速度快。两阶段检测器(two-stage detector)如 Faster R-CNN 先产生区域提案(region proposal),再分类与精修框,通常更慢但定位更细。
训练
训练损失包含三部分:
有物体格子的坐标回归(平方或平滑 $L_1$);
置信度(有物体 / 无物体,后者权重更小,否则大量背景格子淹没梯度);
分类交叉熵。
每个真值框只匹配一个格子(中心所在格)和一个 anchor(IoU 最大者)。
坐标:sigmoid 把中心约束在格内;指数把 anchor 宽高缩放到正数。
损失是多项之和;权重不匹配会出现“分类还行、框乱飘”或反过来。
Anchor 与特征图步幅共同决定最小可检物体。物体小于一个格子时,中心仍只能进一个格,但回归难度上升。
1 | def iou(box1, box2): |
上面逐对算 IoU,是 $O(N^{2})$ 次 Python 调用。向量化写法一次算出 $N\times M$ 的 IoU 矩阵,NMS 每轮只需一行比较:
1 | def iou_matrix(A, B): |
torchvision 提供 C++/CUDA 实现,可以用来对拍。YOLO 作业里按类别分别做 NMS,对应 batched_nms:
1 | from torchvision.ops import nms, batched_nms, box_iou |
▸例15 IoU 与 NMS 的数值
框 $A=[0,0,10,10]$,$B=[0,0,10,8]$,交集面积 $80$,并集 $100+80-80=100$,$\mathrm{IoU}=0.8$。若 NMS 阈值为 $0.5$ 且二者同类,低分框被删。若其实是并排两辆车,阈值过低会误删,这是密集场景换 Soft-NMS 或更小阈值的原因。NMS 阈值与 IoU 评估里的 $0.5$ 不是同一件事:一个用于后处理,一个用于算 mAP。
评估:AP 与 mAP
- mAP:对每类按置信度排序,算 precision-recall 曲线下面积,再对类平均。
- IoU 阈值集合(如 $0.5$ 到 $0.95$)决定定位严格程度。
▸AP 与 mAP(average precision and mean average precision)
对某一类别,把全部预测框按 confidence score 从高到低排序。每加入一个预测,按它是否与未匹配真值达到指定 IoU 阈值更新 TP 或 FP,由此得到 precision-recall curve。平均精度(average precision, AP)是该曲线下的插值面积:
$$ \mathrm{AP}=\int_{0}^{1}p_{\mathrm{interp}}(r)\,\mathrm{d}r, \qquad \mathrm{mAP}=\frac{1}{C}\sum_{c=1}^{C}\mathrm{AP}_c. $$
AP@0.5 表示 IoU 阈值固定为 $0.5$。COCO 的 AP@[.5:.95] 会在 $0.50,0.55,\ldots,0.95$ 上求平均,更严格。NMS 是推理后处理;AP/mAP 是评估指标,二者不能互换。
▸衔接
检测给出的是矩形框,框里既有物体也有背景。很多应用(医学影像中肿瘤的轮廓、自动驾驶中可行驶的路面)需要知道每个像素属于什么。下一节把输出细化到像素级。
语义分割(Semantic Segmentation)
任务
语义分割对图像中的每个像素分类(道路、车辆、建筑、行人……),训练数据是逐像素着色的标签图。实例分割还要区分同类的不同个体,超出 CS230 作业范围。
最朴素的做法是对每个像素,取以它为中心的一块区域送入分类网络,但这需要做“像素数”次前向,相邻区域大量重复计算。
FCN
FCN(fully convolutional network,全卷积网络)只用卷积层:把分类网络的全连接层替换成等价的卷积层(见“全连接层可以写成卷积”),空间结构就能一直保留到输出。一次前向就能对所有像素分类。
但经过多次下采样,特征图已经很小。FCN 最后加入扩大空间的处理,把小特征图一下子放大回输入大小。这个放大用双线性插值,通过转置卷积(transposed convolution,也称去卷积、逆卷积)实现。
转置卷积
普通卷积让空间变小;转置卷积让空间变大。做法是:输入的每个元素乘以整个滤波器,结果“盖”到输出的对应位置上(步幅决定移动距离),重叠部分相加,最后去掉填充部分。例如 $2\times2$ 的输入、$3\times3$ 的滤波器、$p=1$、$s=2$,得到 $4\times4$ 的输出。
输出边长 $=(n-1)s-2p+f$(PyTorch 还可加 output_padding)。按上面“盖章再相加”的描述写成 NumPy,再与 ConvTranspose2d 对拍:
1 | def conv_transpose2d(x, k, s=2, p=1): |
这里 $(2-1)\cdot2-2+3=3$,PyTorch 给出的也是 $3\times 3$;要得到上文的 $4\times 4$,需加 output_padding=1(在输出的一侧多补一行一列)。
U-Net
▸U-Net
U-Net(Ronneberger et al., 2015)用于像素级分割:编码器下采样抓上下文,解码器上采样恢复空间,skip 把编码器的高分辨率特征在通道维拼到对应解码层。定位主要来自 skip,不是来自最底层语义。skip 是拼接,残差是相加。
U-Net 的结构像字母 U:
- 编码器(左半边):卷积 + 下采样,空间变小、通道变多,抓取“这里是什么”的上下文信息。
- 解码器(右半边):转置卷积上采样,空间变大、通道变少,恢复空间分辨率。
- 跳跃连接(skip connection):编码器第 $k$ 个下采样前的高分辨率特征,沿通道维拼接到解码器对应的上采样之后。解码器底层只有低分辨率的高级语义(知道“有一只猫”但不知道精确边界),跳跃连接补上了精细的空间细节(边缘在哪里)。
- 最后用 $1\times1$ 卷积把通道变为类别数,输出 $h\times w\times n_{\mathrm{classes}}$,每个像素取 argmax 得到分割图。
注意 skip 是通道维拼接,而非相加(与残差不同)。
两层深的小型 U-Net,结构与作业相同,只是更浅:
1 | def double_conv(c_in, c_out): |
输入边长须能被 $2^{\text{下采样次数}}$ 整除,否则上采样回来的尺寸比 skip 少一像素,torch.cat 报错。这就是作业里要求对称裁剪或 padding 的原因。
损失与评估
- 损失:逐像素交叉熵;类别不平衡时用加权或 Dice。
- 医学分割中正类像素很少,交叉熵会偏向背景。Dice 损失直接优化重叠:
$$ 1-\frac{2\sum_p \hat{y}_p y_p}{\sum_p \hat{y}_p+\sum_p y_p+\varepsilon}. $$
- 评估不能把 IoU 与像素准确率混用:后者会被大背景类主导。
- 上采样:转置卷积,或插值加 $3\times3$ 卷积。
- 作业重点:对称裁剪或 padding,使 skip 两端空间尺寸一致,否则无法
concatenate。
1 | def dice_loss(logits, target, eps=1e-6): |
常见的组合是 CrossEntropy + Dice:交叉熵提供稳定的逐像素梯度,Dice 直接对准重叠率,缓解背景占多数的问题。
▸例16 自动驾驶中的道路场景分割
基于 CNN 的 SegNet 对道路场景逐像素分割,能较高精度地识别出道路、建筑物、人行道、树木、车辆等。正确识别时刻变化的环境、自由往来的车辆和行人,是自动驾驶中最关键也最困难的技术之一。
▸衔接
检测与分割输出的是框和像素类别。人脸验证学的是嵌入空间里的距离,不再用固定 $K$ 类的 softmax。风格迁移甚至不训练网络,只把生成图当作像素变量来优化。这两件事都建立在卷积特征上。
人脸与风格(Face Recognition and Neural Style Transfer)
人脸验证学的是可比较的嵌入,而不是固定 $K$ 类的 softmax:同一人的两张图距离应小于阈值 $\tau$。风格迁移固定预训练 CNN,把生成图 $G$ 当作像素变量。内容损失比较某层特征图;风格损失比较 Gram 矩阵(Gram matrix),即把特征图展成通道 $\times$ 空间后做 $AA^{\top}$,刻画通道之间的相关,不锁定空间布局。
人脸验证与识别
▸Siamese 与 triplet
Siamese 网络:两个共享权重的 CNN 把图像映成同一嵌入空间。triplet loss(FaceNet, 2015)要求锚点离正例比离负例至少近一个间隔 $\alpha$。身份数目会变时,不必重训 $K$ 类 softmax,只要把新嵌入写入库。随机负例大多已经满足间隔,需要半困难负例。
两个任务
- 验证(verification):输入一张图和一个身份(ID),判断是不是这个人。一对一,例如刷脸门禁、手机解锁。
- 识别(recognition):库中有 $K$ 个人,输入一张图,判断是其中哪一个(或都不是)。一对多,难得多:若验证的准确率是 $99\%$,在 100 人的库中做识别,出错的机会约放大 100 倍。
- 二者共享嵌入,不共享决策。
一次学习
人脸识别的难点是一次学习(one-shot learning):公司员工每人往往只有一张照片,要据此识别本人。若当作 $K$ 类分类训练 softmax,每类只有一个样本,根本训练不好;而且每来一个新员工,$K$ 就变,要重新训练。
解决办法是学一个相似度函数:
$$ d(\text{img}_1,\text{img}_2)=\text{两张图的差异程度}. $$
若 $d\le\tau$ 判为同一人,否则不是。识别时把输入与库中每张照片比较,取 $d$ 最小者(若都大于 $\tau$ 则判为陌生人)。新员工入职只需把他的照片加入库,不必重新训练。
Siamese 网络
用同一个 CNN(共享权重)把两张图分别编码为向量 $f(x^{(i)})$ 和 $f(x^{(j)})$(例如 128 维),定义
$$ d\big(x^{(i)},x^{(j)}\big)=\big\|f(x^{(i)})-f(x^{(j)})\big\|_2^{2}. $$
训练目标:同一人的 $d$ 小,不同人的 $d$ 大。这就是度量学习(metric learning):直接学样本之间的距离。
Triplet loss
FaceNet 的 triplet loss 每次看三张图:锚点 $A$(anchor)、同一人的正例 $P$(positive)、另一个人的负例 $N$(negative)。希望
$$ \|f(A)-f(P)\|_2^{2}+\alpha\le\|f(A)-f(N)\|_2^{2}. $$
间隔 $\alpha>0$ 是必需的:若 $\alpha=0$,网络把所有图都编码成同一个向量(或零向量),不等式就以 $0\le 0$ 平凡成立。$\alpha$ 要求正负对的距离至少拉开一段。写成损失:
$$ \mathcal{L}(A,P,N)=\max\big(\|f(A)-f(P)\|_2^{2}-\|f(A)-f(N)\|_2^{2}+\alpha,\ 0\big), \qquad J=\sum_{i}\mathcal{L}\big(A^{(i)},P^{(i)},N^{(i)}\big). $$
- 训练集需要每个人有多张照片(例如 1000 人共 1 万张):每个锚点的正例来自同一身份的另一张图。部署时每人一张即可。
- 嵌入通常 $L_2$ 归一化到单位球面,消除尺度作弊。
- 三元组挖掘很关键。随机选 $A,P,N$ 时,绝大多数三元组已经满足不等式,损失为 0,梯度为 0,学不到东西。应选难的三元组,即 $d(A,P)\approx d(A,N)$ 的那些。
- 简单负例已满足间隔,损失为 0。
- 困难负例 $\|f(A)-f(N)\|<\|f(A)-f(P)\|$:往往是噪声或标注错。
- 半困难负例(semi-hard negative)位于二者之间:比正例远,但还没有远过 $\alpha$,梯度最有信息。
- 在线挖掘:在一个 mini-batch 内选;离线挖掘:周期性更新。
- 都要防止坍缩到所有嵌入为零(尺度任意时间隔仍可被满足),$L_2$ 归一化把嵌入钉在球面上。
1 | def triplet_loss(fA, fP, fN, alpha=0.2): |
PyTorch 中,常把编码网络的输出做 L2 归一化,并在 batch 内挑选半困难负例(semi-hard negative:比正例远、但仍落在间隔之内):
1 | import torch.nn.functional as F |
- 一个 batch 里每个身份至少要有 2 张图,否则没有正例。常见采样是每 batch 取 $P$ 个人、每人 $K$ 张(例如 $P=32$、$K=4$)。
- PyTorch 内置
nn.TripletMarginLoss(margin=0.2)用的是不平方的距离 $\lVert a-p\rVert_2$,与 FaceNet 公式差一个平方,间隔 $\alpha$ 的数值不能直接照搬。
当作二分类
另一种训练方式:把一对图的嵌入差输入逻辑回归,判断是否同一人:
$$ \hat{y}=\sigma\Big(\sum_{k=1}^{128}w_k\big|f(x^{(i)})_k-f(x^{(j)})_k\big|+b\Big). $$
也可以把 $|\cdot|$ 换成 $\chi^{2}$ 形式 $\frac{(f_k^{(i)}-f_k^{(j)})^{2}}{f_k^{(i)}+f_k^{(j)}}$。训练数据是成对的图,标签为“同一人 1 / 不同人 0”。二元监督也可以用对比损失(contrastive loss):同一人的两张图拉近,不同人的两张图推到间隔以外。
部署技巧:库中员工照片的嵌入可以预先算好存起来,来人时只需对新图跑一次 CNN。
阈值与错误率
- 验证时比较 $\|f(x)-f(x_{\mathrm{db}})\|$ 与阈值 $\tau$;$\tau$ 在验证集上用 FAR/FRR 或 EER 选择。
- 光照、姿态、年龄会造成嵌入漂移;部署采集协议须与训练分布对齐。
▸FAR、FRR 与 EER
假接受率(false accept rate, FAR)是不同人却被接受的比例;假拒绝率(false reject rate, FRR)是同一人却被拒绝的比例:
$$ \mathrm{FAR}=\frac{\text{false accepts}}{\text{impostor attempts}},\qquad \mathrm{FRR}=\frac{\text{false rejects}}{\text{genuine attempts}}. $$
距离阈值 $\tau$ 变大时,系统更容易接受,FAR 通常上升而 FRR 下降。等错误率(equal error rate, EER)是两条错误率相等处的值,越低越好。安全门禁通常不直接选 EER 阈值,而是在 FAR 必须低于某上限的约束下再压 FRR。
1 | def embed_and_verify(xa, xb, network, tau): |
神经风格迁移
▸风格迁移
神经风格迁移(Gatys et al., 2016)固定预训练 CNN 的权重,把生成图 $G$ 当作像素变量来优化。内容损失比较某层特征图,风格损失比较 Gram 矩阵(通道相关,不锁定空间布局)。梯度对 $G$ 回传,不更新 $W$。
任务
给定内容图 $C$(如一张照片)和风格图 $S$(如梵高的《星空》),生成一张新图 $G$:内容像 $C$,风格像 $S$。这篇论文(A Neural Algorithm of Artistic Style)一经发表就受到广泛关注。
关键在于:$G$ 是像素变量,不是网络权重;CNN(如 ImageNet 上预训练的 VGG)冻结不动,只用来提取特征。
代价函数
$$ J(G)=\alpha J_{\mathrm{content}}(C,G)+\beta J_{\mathrm{style}}(S,G). $$
$\alpha$ 越大越在意内容,$\beta$ 越大越在意风格。算法:随机初始化 $G$(或用内容图加噪声),然后对 $G$ 的像素做梯度下降 $G\leftarrow G-\frac{\partial J}{\partial G}$。
内容代价:选一个中间层 $l$(太浅则要求像素级相同,太深则只要求“有只狗”),比较两图在该层的激活:
$$ J_{\mathrm{content}}(C,G)=\frac{1}{2}\|a^{[l](C)}-a^{[l](G)}\|_F^{2}. $$
激活相近说明两图内容相似。
风格代价:“风格”被定义为同一层中不同通道激活之间的相关性。例如某通道检测竖条纹,另一通道检测橙色,两者经常同时出现,就说明这种风格里“竖条纹常是橙色的”。把第 $l$ 层激活 $a^{[l]}\in\mathbb{R}^{n_H\times n_W\times n_C}$ 展成 $A^{[l]}\in\mathbb{R}^{n_C\times(n_H n_W)}$,风格矩阵(Gram 矩阵)为
$$ G^{[l]}=A^{[l]}A^{[l]\top},\qquad G_{kk'}^{[l]}=\sum_{i=1}^{n_H}\sum_{j=1}^{n_W}a_{ijk}^{[l]}a_{ijk'}^{[l]}. $$
$G_{kk'}$ 是通道 $k$ 与 $k'$ 在所有位置上的乘积之和(未中心化的协方差)。Gram 矩阵对空间位置求和,所以不锁定空间布局,只刻画纹理统计。分别对 $S$ 和 $G$ 计算,比较:
$$ J_{\mathrm{style}}^{[l]}(S,G)=\frac{1}{(2n_Hn_Wn_C)^{2}}\big\|G^{[l](S)}-G^{[l](G)}\big\|_F^{2}. $$
归一化常数只影响尺度,可以被 $\beta$ 吸收(有的实现写成 $\frac{1}{2}\|\cdot\|_F^2$ 或 $\frac{1}{4n_C^2(n_Hn_W)^2}\|\cdot\|_F^2$)。用多层效果更好,浅层偏纹理、深层偏大结构:
$$ J=\alpha J_{\mathrm{content}}+\beta\sum_{l}\lambda_l J_{\mathrm{style}}^{[l]}. $$
- 对 $G$ 做梯度下降,可加 total variation 正则使图像平滑。
- 这是优化问题不是训练问题:每张新图都要从零迭代优化 $G$,与训练分类器的“epoch”不是同一件事。
1 | def gram_matrix(A): |
- 预训练 CNN 冻结,只对像素求 $\partial J/\partial G$。
- 迭代不够:风格未融合。$\beta/\alpha$ 过大:内容结构崩坏。
PyTorch 写法的关键只有一行:把生成图设成 requires_grad=True,并把它(而不是网络参数)交给优化器。
1 | vgg = models.vgg19(weights=models.VGG19_Weights.IMAGENET1K_V1).features.eval() |
vgg.eval() 不能省:VGG 本身没有 BN 和 Dropout,但换成带 BN 的骨干时,train() 模式会让特征随 batch 统计变化。
▸对照:验证、识别、分类、风格迁移
- $K$ 类 softmax:类别集合固定。
- 验证:一对一,比距离与 $\tau$。
- 识别:一对多,在库中找最近邻;库可增员而不重训头。
- 风格迁移:变量是像素 $G$,CNN 冻结。
▸衔接
卷积在空间上共享同一组核。序列数据(文本、语音、时间序列)的结构在时间轴上:下一部分的循环网络让 $W_{aa}$ 在每个时间步重复使用,正如卷积核在每个空间位置重复使用。
序列与语言
卷积在空间上共享权重;这一部分把共享换到时间轴上。文本、语音、音乐、时间序列都是序列数据,它们有两个图像没有的特点:长度可变,而且顺序有意义。
路线如下:
- 循环网络:每个时间步复用同一组权重,用隐状态记住历史;长程梯度会消失,于是引入 GRU、LSTM 的门。
- 词嵌入:把离散的词变成可比较的稠密向量,作为循环网络的输入。
- 注意力:编码器–解码器把整句压成一个向量,长句信息会丢;注意力让解码器每一步回看源句的所有位置。
- Transformer:完全去掉循环,只用注意力,序列顺序改由位置编码写入。
循环网络(Recurrent Neural Network)
动机
序列问题
很多任务的输入或输出是序列:
| 任务 | 输入 $x$ | 输出 $y$ |
|---|---|---|
| 语音识别 | 音频波形 | 文字序列 |
| 音乐生成 | 空(或一个风格编号) | 音符序列 |
| 情感分类 | 一句评论 | 1–5 星 |
| DNA 序列分析 | 碱基序列 | 每段是否编码蛋白质 |
| 机器翻译 | 一种语言的句子 | 另一种语言的句子 |
| 视频动作识别 | 帧序列 | 动作类别 |
| 命名实体识别 | 句子 | 每个词是否是人名 |
记号:$x^{\langle t\rangle}$ 表示序列的第 $t$ 个元素,$T_x$、$T_y$ 是输入、输出序列的长度;第 $i$ 个样本写作 $x^{(i)\langle t\rangle}$,不同样本长度 $T_x^{(i)}$ 可以不同。
▸例1 命名实体识别的数据表示
句子 “Harry Potter and Hermione Granger invented a new spell.” 有 $T_x=9$ 个词,标签 $y=(1,1,0,1,1,0,0,0,0)$ 标出哪些词属于人名。
每个词先用词表表示:取一个 10000 词的词表(实际常用 3 万到 5 万,大公司可达百万),“Harry” 若是第 4075 个词,就表示为第 4075 位为 1、其余为 0 的 one-hot 向量 $x^{\langle 1\rangle}\in\mathbb{R}^{10000}$。不在词表中的词用 <UNK>(unknown)表示。
为什么不用标准网络
把 9 个 one-hot 向量拼起来送进全连接网络,有两个问题:
- 长度不固定:不同句子的 $T_x$、$T_y$ 不同。补零到最大长度可以勉强处理,但并不优雅。
- 不能在位置之间共享特征:在第 1 个位置学到 “Harry 是人名”,不能自动用到第 5 个位置。这与全连接处理图像时的问题一样;卷积用共享核解决空间问题,循环网络用共享权重解决时间问题。此外,10000 维的输入乘以 $T_x$ 个位置,第一层参数也太多。
RNN 单元
▸RNN
循环网络在每个时间步复用同一组 $W_{aa},W_{ax}$,隐状态 $a^{\langle t\rangle}$ 概括到当前步为止的历史。参数量不随序列长度增长,因此能处理变长输入。计算必须按时间串行;长程梯度反复相乘后容易消失,后面用门控和注意力处理。
循环网络按时间顺序读输入:读第 $t$ 个词时,除了 $x^{\langle t\rangle}$,还把上一步的隐状态 $a^{\langle t-1\rangle}$ 一起输入,所以第 $t$ 步的预测能利用 $x^{\langle 1\rangle},\ldots,x^{\langle t\rangle}$ 的全部信息。前向传播为
$$ \begin{aligned} a^{\langle t\rangle} &= g\big(W_{aa}a^{\langle t-1\rangle}+W_{ax}x^{\langle t\rangle}+b_a\big),\\ \hat{y}^{\langle t\rangle} &= g_y\big(W_{ya}a^{\langle t\rangle}+b_y\big). \end{aligned} $$
- $g$ 常用 tanh(有时用 ReLU);$g_y$ 按任务选 sigmoid(二分类)或 softmax(多分类)。
- $a^{\langle 0\rangle}$ 通常为零向量。
- 参数 $W_{aa},W_{ax},W_{ya},b_a,b_y$ 不随 $t$ 改变,所有时间步共享。
- 下标的读法:$W_{ax}$ 乘以 $x$ 类的量,输出 $a$ 类的量。
简化记号:把两个矩阵横向拼成 $W_a=[W_{aa}\mid W_{ax}]$,把两个向量纵向拼成 $[a^{\langle t-1\rangle};x^{\langle t\rangle}]$,则
$$ a^{\langle t\rangle}=g\big(W_a[a^{\langle t-1\rangle};x^{\langle t\rangle}]+b_a\big),\qquad \hat{y}^{\langle t\rangle}=g\big(W_y a^{\langle t\rangle}+b_y\big). $$
例如 $n_a=100$、$n_x=10000$:$W_{aa}$ 为 $(100,100)$,$W_{ax}$ 为 $(100,10000)$,拼成 $W_a$ 为 $(100,10100)$。后面的 GRU、LSTM 都用这种写法。
局限:上式只用到了过去的信息。“He said, Teddy Roosevelt was a great President.” 与 “He said, Teddy bears are on sale!” 的前三个词完全相同,只看前面无法判断 Teddy 是不是人名,这需要后文的双向 RNN。
1 | def rnn_cell_forward(xt, a_prev, params): |
PyTorch 的 nn.RNN 计算同一个递推 $a^{\langle t\rangle}=\tanh(W_{ax}x^{\langle t\rangle}+b_{ih}+W_{aa}a^{\langle t-1\rangle}+b_{hh})$,只是把偏置拆成两个,并默认按 (T, m, n_x) 排布(batch_first=True 时为 (m, T, n_x))。把作业参数拷进去即可对拍:
1 | n_x, n_a, m, T = 3, 5, 4, 6 |
out 是每一步的隐状态 (m, T, n_a),输出层 $W_{ya}$ 要另外用 nn.Linear 接;h_T 只有最后一步,many-to-one 任务直接用它。
架构类型
按输入输出的长度关系分为五类:
| 类型 | 示意 | 例子 |
|---|---|---|
| one-to-one | $T_x=T_y=1$ | 普通神经网络 |
| one-to-many | $T_x=1$,$T_y>1$ | 音乐生成:从一个种子(或零输入)展开,每步输出作为下一步输入 |
| many-to-one | $T_x>1$,$T_y=1$ | 情感分类:只用最后一步 $a^{\langle T_x\rangle}$ 输出 |
| many-to-many,等长 | $T_x=T_y$ | 命名实体识别、词性标注:每步都有标签 |
| many-to-many,不等长 | $T_x\ne T_y$ | 机器翻译:编码器(encoder)先读完输入,解码器(decoder)再逐步输出 |
损失
每一步的损失按任务定义。例如命名实体识别每步是二分类,用逻辑回归损失:
$$ \mathcal{L}^{\langle t\rangle}\big(\hat{y}^{\langle t\rangle},y^{\langle t\rangle}\big)=-y^{\langle t\rangle}\log\hat{y}^{\langle t\rangle}-\big(1-y^{\langle t\rangle}\big)\log\big(1-\hat{y}^{\langle t\rangle}\big), \qquad \mathcal{L}=\sum_{t=1}^{T_y}\mathcal{L}^{\langle t\rangle}. $$
语言模型与采样
语言模型
语言模型给一个句子估计概率 $P(y^{\langle 1\rangle},\ldots,y^{\langle T_y\rangle})$。语音识别要用它在发音相同的候选间选择:“The apple and pair salad” 的概率约为 $3.2\times10^{-13}$,“The apple and pear salad” 约为 $5.7\times10^{-10}$,后者更可能是对的。机器翻译也需要它判断哪个译文更通顺。
训练:在大语料上分词(tokenize),把每个词映射为词表编号,句末加 <EOS>(end of sentence),未知词用 <UNK>。以 “Cats average 15 hours of sleep a day. <EOS>” 为例:
- 第 1 步输入 $x^{\langle 1\rangle}=\vec{0}$,$\hat{y}^{\langle 1\rangle}$ 是词表上的 softmax,预测第一个词是各个词的概率 $P(\text{cats})$;
- 第 2 步输入 $x^{\langle 2\rangle}=y^{\langle 1\rangle}$(真实的 “cats”),预测 $P(\,\cdot\mid\text{cats})$;
- 第 3 步输入 “average”,预测 $P(\,\cdot\mid\text{cats average})$;依此类推,直到预测出
<EOS>。
每步损失是 softmax 交叉熵 $\mathcal{L}^{\langle t\rangle}=-\sum_i y_i^{\langle t\rangle}\log\hat{y}_i^{\langle t\rangle}$,总损失为各步之和。训练好后,句子的概率由链式法则得到:
$$ P\big(y^{\langle 1\rangle},y^{\langle 2\rangle},y^{\langle 3\rangle}\big)=P\big(y^{\langle 1\rangle}\big)\,P\big(y^{\langle 2\rangle}\mid y^{\langle 1\rangle}\big)\,P\big(y^{\langle 3\rangle}\mid y^{\langle 1\rangle},y^{\langle 2\rangle}\big). $$
- 字符级语言模型:词表是字母、数字、标点,$\hat{y}^{\langle t\rangle}$ 是字符表上的 softmax。好处是没有
<UNK>;代价是序列长得多,长程依赖更难学,训练更贵。 - 训练:每步交叉熵。
困惑度
困惑度(perplexity, PPL)是平均负对数似然的指数。若有效词元数为 $N$,
$$
\mathrm{PPL}
=\exp\left(-\frac{1}{N}\sum_{t=1}^{N}
\log p(x_t\mid x_{ PPL 越低,模型给真实序列的平均概率越高。一个直观解释:若模型对每个词都均匀地给出 $1/|V|$,则 $\mathrm{PPL}=|V|$,可以理解为模型平均在多少个词之间“犹豫”。只有词元化、词表与计数方式相同时,两个 PPL 才可直接比较。 训练好的语言模型可以生成新序列,用来检查模型学到了什么: 时间反向传播(BPTT)就是把展开后的循环网络当成一个很深的前馈网络,从 $t=T$ 向 $t=1$ 回传梯度。$W_{aa}$ 在每个时间步是同一块矩阵,所以它的梯度是所有时刻贡献之和(与卷积核梯度对所有空间位置求和是一回事)。 tanh 的导数为 $1-\tanh^{2}$,单步反向为 $$
\mathrm{d}z^{\langle t\rangle}=\big(1-(a^{\langle t\rangle})^{2}\big)\odot\mathrm{d}a^{\langle t\rangle},\quad
\mathrm{d}W_{ax}\mathrel{+}=\mathrm{d}z^{\langle t\rangle}x^{\langle t\rangle\top},\quad
\mathrm{d}W_{aa}\mathrel{+}=\mathrm{d}z^{\langle t\rangle}a^{\langle t-1\rangle\top},\quad
\mathrm{d}a^{\langle t-1\rangle}=W_{aa}^{\top}\mathrm{d}z^{\langle t\rangle}.
$$ “The cat, which already ate an apple, a banana, …, was full.” 与 “The cats, which already ate …, were full.” 动词用 was 还是 were,取决于很多个词之前的主语是单数还是复数。普通 RNN 很难学到这种长距离依赖:第 $t$ 步的输出主要受附近几步影响。 原因与深层网络中的梯度消失相同。从第 $t$ 步回传到第 $k$ 步,要连乘 $$
\prod_{k} W_{aa}^{\top}\mathrm{diag}\big(1-(a^{\langle k\rangle})^{2}\big),
$$ 这导致: $$
g\leftarrow
\begin{cases}
g & \|g\|_2\le \tau,\\
\dfrac{\tau}{\|g\|_2}g & \|g\|_2>\tau.
\end{cases}
$$ 逐值裁剪会分别截断每个坐标,改变梯度方向;全局范数裁剪只统一缩放,保留方向。 GRU(Cho et al., 2014)用更新门 $\Gamma_u$ 和重置门 $\Gamma_r$ 控制写入。$\Gamma_u\approx 0$ 时直接拷贝旧状态,梯度可以沿时间传得更远。参数比 LSTM 少;作业实现其中一种即可。 门控循环单元(gated recurrent unit, GRU)引入一个记忆单元 $c$(GRU 中 $c^{\langle t\rangle}=a^{\langle t\rangle}$)。每一步先算一个候选值 $\tilde{c}^{\langle t\rangle}$,再用更新门 $\Gamma_u$ 决定是否用它覆盖旧记忆: $$
\begin{aligned}
\tilde{c}^{\langle t\rangle} &= \tanh\big(W_c[c^{\langle t-1\rangle},x^{\langle t\rangle}]+b_c\big),\\
\Gamma_u &= \sigma\big(W_u[c^{\langle t-1\rangle},x^{\langle t\rangle}]+b_u\big),\\
c^{\langle t\rangle} &= \Gamma_u\odot\tilde{c}^{\langle t\rangle}+(1-\Gamma_u)\odot c^{\langle t-1\rangle}.
\end{aligned}
$$ $\Gamma$ 是 sigmoid 输出,大多数时候非常接近 0 或 1。在例 2 中:读到 “cat” 时 $\Gamma_u\approx 1$,把 “主语是单数” 写入 $c$;之后一长串词 $\Gamma_u\approx 0$,$c^{\langle t\rangle}=c^{\langle t-1\rangle}$,记忆原样保留;到 “was” 时再读取。$\Gamma_u\approx 0$ 时 $c^{\langle t\rangle}\approx c^{\langle t-1\rangle}$,梯度也几乎原样传过,梯度消失大为缓解。$c,\tilde{c},\Gamma_u$ 维度相同,$\odot$ 为逐元素乘:每一维可以独立决定更新与否(有的维记单复数,有的维记话题)。 再加一个相关门(relevance gate,也称重置门)$\Gamma_r$,控制计算候选值时用多少旧记忆。用 $a$ 写出: $$
\begin{aligned}
\Gamma_u &= \sigma(W_u[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_u),\\
\Gamma_r &= \sigma(W_r[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_r),\\
\tilde{c}^{\langle t\rangle} &= \tanh\big(W_c[\Gamma_r\odot a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_c\big),\\
a^{\langle t\rangle} &= \Gamma_u\odot\tilde{c}^{\langle t\rangle}+(1-\Gamma_u)\odot a^{\langle t-1\rangle}.
\end{aligned}
$$ PyTorch 的 两种写法表达能力相近,但权重不能直接互拷。 LSTM(Hochreiter & Schmidhuber, 1997)另设细胞状态 $c^{\langle t\rangle}$,用遗忘、输入、输出三个门更新。$c$ 上主要是加法,长程依赖比朴素 RNN 稳定。作业要求能写出六式;常见错误是门的拼接顺序,以及下一门读的是 $c$ 还是 $a$。 长短期记忆网络(long short-term memory, LSTM)比 GRU 更早提出,也更通用。与 GRU 的区别: 记忆单元 $c^{\langle t\rangle}$ 与隐状态 $a^{\langle t\rangle}$ 分开,$a^{\langle t\rangle}\ne c^{\langle t\rangle}$; GRU 的 $\Gamma_u$ 与 $1-\Gamma_u$ 被拆成两个独立的门:遗忘门 $\Gamma_f$ 和输入门 $\Gamma_i$(Ng 课上记作更新门 $\Gamma_u$); 多一个输出门 $\Gamma_o$,决定暴露多少记忆。 增加记忆单元 $c^{\langle t\rangle}$。 三个门:遗忘 $\Gamma_f$、输入 $\Gamma_i$、输出 $\Gamma_o$。 $$
\begin{aligned}
\Gamma_f &= \sigma(W_f[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_f),\\
\Gamma_i &= \sigma(W_i[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_i),\\
\tilde{c}^{\langle t\rangle} &= \tanh(W_c[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_c),\\
c^{\langle t\rangle} &= \Gamma_f\odot c^{\langle t-1\rangle}+\Gamma_i\odot\tilde{c}^{\langle t\rangle},\\
\Gamma_o &= \sigma(W_o[a^{\langle t-1\rangle},x^{\langle t\rangle}]+b_o),\\
a^{\langle t\rangle} &= \Gamma_o\odot\tanh(c^{\langle t\rangle}).
\end{aligned}
$$ PyTorch 的 双向 RNN(bidirectional RNN, BRNN):分别跑正向和反向两条 RNN,正向从 $t=1$ 读到 $T_x$,反向从 $T_x$ 读到 1,每步把两边的隐状态拼起来做预测: $$
\hat{y}^{\langle t\rangle}=g\big(W_y[\overrightarrow{a}^{\langle t\rangle};\overleftarrow{a}^{\langle t\rangle}]+b_y\big).
$$ 于是第 $t$ 步的预测同时利用了过去和未来,能解决前面 “Teddy” 的歧义。单元可以是 RNN、GRU 或 LSTM,NLP 中 BLSTM 很常见。 深层 RNN:把多层 RNN 叠起来,下层的 $a^{\langle t\rangle}$ 当作上层的输入。第 $l$ 层第 $t$ 步: $$
a^{[l]\langle t\rangle}=g\Big(W_a^{[l]}\big[a^{[l]\langle t-1\rangle},a^{[l-1]\langle t\rangle}\big]+b_a^{[l]}\Big).
$$ 每层每个时间步都要计算,所以 RNN 叠 3 层就已经很深了(不像 CNN 动辄上百层)。有时在顶层 RNN 之上再接几层只在纵向连接、不在时间上连接的全连接层。 Teacher forcing:训练时解码器的输入是上一时刻的真值标签,不是模型自己的预测。收敛通常更快,但训练分布与推理分布不一致;推理时第一步出错会向后传播。 RNN 的输入 $x^{\langle t\rangle}$ 若是 one-hot,任意两个词的内积恒为 0,模型无法知道 “apple” 和 “orange” 相似。下一节用嵌入表 $E$ 把离散记号变成可比较的向量,再送进 RNN 或平均后分类。 词嵌入把离散词号换成 $d$ 维向量。one-hot 的内积恒为 0;稠密向量里相近词可以有较大余弦。word2vec(2013)用 Skip-gram 或 CBOW 训练,GloVe 拟合共现对数。大词表上的 softmax 用负采样近似。嵌入会带上语料中的偏见。 one-hot $o_j\in\mathbb{R}^{|V|}$ 把每个词看作孤立的符号:任意两个不同词的内积恒为 0,欧氏距离都相同。模型学会了 “I want a glass of orange juice”,遇到 “I want a glass of apple ___” 时无法推广,因为在 one-hot 下 apple 与 orange 的关系和 apple 与 king 的关系一样远。 改进方法是用一组特征描述每个词: 实际使用约 300 维。Apple 与 Orange 的向量非常接近,所以学到 “orange juice” 后很容易推广到 “apple juice”。 类比:$e_{\mathrm{man}}-e_{\mathrm{woman}}=(-2,-0.01,0.01,0.08)$,$e_{\mathrm{king}}-e_{\mathrm{queen}}=(-1.92,-0.02,0.01,0.01)$,两个差向量几乎相同,主要差在 Gender 维。所以“man 之于 woman 如同 king 之于 ?”可以通过找与 $e_{\mathrm{king}}-e_{\mathrm{man}}+e_{\mathrm{woman}}$ 最接近的词来回答。 学出来的嵌入的各个维度通常不像上表那样可解释,但相近词仍会聚在一起。常用 t-SNE 把 300 维嵌入降到 2 维画图观察:水果聚一团、数字聚一团、人物聚一团。t-SNE 是非线性映射,降维后类比关系的平行四边形一般不再保持。 迁移学习:在 10 亿到 1000 亿词的无标签语料上学嵌入(或直接下载预训练的),迁移到只有约 10 万词标注数据的新任务(如命名实体识别),可选地再在新任务上微调。下游数据越少越有帮助;在机器翻译、语言模型这类本身数据很多的任务上帮助较小。这与人脸识别中的“编码”(encoding)类似:人脸编码要对任意新图都能计算,词嵌入只针对固定词表。 Bengio 等的做法:用嵌入做语言模型,嵌入作为副产品被学出来。预测 “I want a glass of orange ___”:把前面 4 个词各自查表得 300 维嵌入,拼成 1200 维向量,送入隐层和 10000 维 softmax,预测下一个词。$E$、隐层和 softmax 的参数一起用反向传播训练。为了预测好下一个词,相似语境中的词(apple、orange)会被学到相似的嵌入。 上下文(context)可以有多种选法:前 4 个词;左右各 4 个词;只用前 1 个词;附近随机的 1 个词。若目的是学嵌入而不是做语言模型,简单的上下文就够用,这引出了 word2vec。 Skip-gram 从句子中随机取一个上下文词 $c$(如 orange),再在它前后一定窗口内随机取一个目标词 $t$(如 juice),构造一个监督学习问题:给定 $c$ 预测 $t$。模型为 $$
o_c\rightarrow E\rightarrow e_c\rightarrow\mathrm{softmax}\rightarrow\hat{y},\qquad
p(t\mid c)=\frac{\exp(\theta_t^{\top}e_c)}{\sum_{j=1}^{|V|}\exp(\theta_j^{\top}e_c)},
$$ 其中 $\theta_t$ 是输出 $t$ 对应的参数,损失为 $\mathcal{L}(\hat{y},y)=-\sum_i y_i\log\hat{y}_i$。这个任务本身很难做好,但目的是学到好的 $E$。 Skip-gram 精确目标:窗口半径 $c$,中心词 $w_t$, $$
\sum_{t}\sum_{\substack{-c\le j\le c\\ j\neq 0}}\log P(w_{t+j}\mid w_t),\qquad
P(w_O\mid w_I)=\frac{\exp(v_{w_O}^{\prime\top} v_{w_I})}{\sum_{w}\exp(v_w^{\prime\top} v_{w_I})}.
$$ 把问题改成二分类:给一对词 $(c,t)$,判断 $t$ 是否真的出现在 $c$ 附近。 从句子 “I want a glass of orange juice to go along with my cereal” 中取一个正样本,再从词表随机取 $k$ 个词作为负样本: 即使随机抽到的词碰巧出现在上下文中(如 of),也标为 0。小数据集取 $k=5$ 到 $20$,大数据集取 $k=2$ 到 $5$。 模型是逻辑回归: $$
P(y=1\mid c,t)=\sigma\big(\theta_t^{\top}e_c\big).
$$ 相当于有 $|V|$ 个二分类器,但每一步只训练其中 $k+1$ 个(1 个正例、$k$ 个负例),代价从 $O(|V|)$ 降到 $O(k)$。对一对 $(w_I,w_O)$ 与 $k$ 个噪声词做逻辑回归,目标为 $$
\log\sigma(v_{w_O}^{\prime\top}v_{w_I})+\sum_{i=1}^{k}\mathbb{E}_{w_i\sim P_n}[\log\sigma(-v_{w_i}^{\prime\top}v_{w_I})].
$$ 负样本的采样分布:按词频 $f(w)$ 采样会抽到太多 the、of;均匀采样又不能代表英文的词分布。经验折中是 $$
P_n(w_i)=\frac{f(w_i)^{3/4}}{\sum_{j=1}^{|V|}f(w_j)^{3/4}},
$$ 即 $P_n(w)\propto f(w)^{3/4}$:压低超高频词。 NumPy 实现一步负采样 SGD。对 $\mathcal{L}=-\log\sigma(\theta_t^{\top}e_c)-\sum_{i}\log\sigma(-\theta_{n_i}^{\top}e_c)$ 求导,与逻辑回归的 $a-y$ 形式一样: PyTorch 中,嵌入矩阵就是 下游任务加载预训练嵌入时,用 GloVe(Global Vectors for Word Representation)的完整目标为 $$
J=\sum_{i,j}f(X_{ij})
\left(w_i^{\top}\tilde{w}_j+b_i+\tilde{b}_j-\log X_{ij}\right)^2.
$$ $X_{ij}$ 是词 $j$ 出现在词 $i$ 上下文中的次数,$f(X_{ij})$ 降低极罕见与极高频共现对目标的支配。Skip-gram 直接做局部预测,GloVe 显式拟合全局共现统计。 $$
e_{\mathrm{king}}-e_{\mathrm{man}}+e_{\mathrm{woman}}\approx e_{\mathrm{queen}}.
$$ $$
\cos(u,v)=\frac{u^{\top}v}{\|u\|_2\,\|v\|_2},
$$ 类比题求 $\arg\max_w \cos\big(e_w,\ e_{\mathrm{king}}-e_{\mathrm{man}}+e_{\mathrm{woman}}\big)$,需要排除题中已出现的词。 情感分类的标注数据通常很少(几万到十万条),嵌入的迁移作用很大。 平均模型:把句中所有词的嵌入取平均(或求和),得到 300 维向量,接 softmax 输出 1–5 星。“The dessert is excellent” 可以正确分类,而且任意长度的句子都适用。 平均模型忽略词序。“Completely lacking in good taste, good service, and good ambience.” 有三个 good,平均后偏正面,实际是差评。 RNN 模型:把嵌入按顺序送入 many-to-one 的 LSTM,能处理“lacking … good”这类结构。由于嵌入来自大语料,训练集中没出现过的近义词(如用 absent 代替 lacking)也能推广。 情感分类可先把句中词向量平均后接逻辑回归,作为强基线。 再对比 LSTM 或 Transformer 是否真有增益。 Emojify 作业:句子平均嵌入送入 softmax,再换成 LSTM。 若平均嵌入已经够用,加 LSTM 的增益应在误差分析里写明(否定词、词序),否则是多余复杂度。 嵌入会编码语料中的社会偏见。例如在嵌入上做类比,可能得到 “Man : Computer Programmer = Woman : Homemaker”,“Father : Doctor = Mother : Nurse”。用于招聘或刑侦时必须单独审计。CS230 作业含词向量去偏: 哪些词“定义上”有性别,可以训练一个分类器判断;需要均衡的词对数量较少,可手工列出。 词嵌入把离散符号换成可比较的向量。下一步是输入、输出都是序列且长度不同的任务(翻译)。seq2seq 把整句压进编码器最后一个隐状态 $a^{\langle T_x\rangle}$;注意力让解码器每一步对源端各隐状态取加权和,不再依赖这一个向量。 注意力让解码器每一步对源端各隐状态加权求和,得到上下文向量。seq2seq 若只把整句压进最后一个隐状态 $a^{\langle T_x\rangle}$,长句前部容易丢失。Bahdanau 注意力按步读取源序列,不再依赖这一个向量。 编码器–解码器(Sutskever et al., 2014)先把源序列读完,再由解码器逐步生成目标序列,因此两端长度可以不同。整句若只压进最后一个隐状态,长句前部容易丢失。下一节的注意力按步读取源端各位置。 同样的结构可以用于图像描述(image captioning):把预训练 CNN(如去掉 softmax 的 AlexNet)当作编码器,输出 4096 维图像特征,再由 RNN 解码器生成句子。鱼书介绍的 NIC(Neural Image Caption)就是“深层 CNN + RNN”:CNN 提取图像特征,RNN 以该特征为初始值递归地生成文本,能为一张图生成 “A person riding a motorcycle on a dirt road.”,连“没有铺装的道路”都能正确描述。组合图像与自然语言等多种信息的处理称为多模态(multimodal)处理。 翻译模型的解码器与语言模型结构相同,区别在于初始状态不是 $\vec{0}$,而是编码器的输出。所以机器翻译是条件语言模型: $$
P\big(y^{\langle 1\rangle},\ldots,y^{\langle T_y\rangle}\mid x\big).
$$ 语言模型生成时随机采样;翻译时则希望找到最可能的译文: $$
\arg\max_{y^{\langle 1\rangle},\ldots,y^{\langle T_y\rangle}}P\big(y^{\langle 1\rangle},\ldots,y^{\langle T_y\rangle}\mid x\big).
$$ 贪心为什么不够:“Jane is visiting Africa in September.” 比 “Jane is going to be visiting Africa in September.” 更好,但在 “Jane is” 之后,“going” 在英语中比 “visiting” 常见,$P(\text{going}\mid x,\text{Jane is})$ 更大,贪心会选上它,走进更差的句子。而穷举所有句子又不可能(10000 词、10 个词长就有 $10000^{10}$ 种)。 束搜索(束宽 $B=3$ 为例): 概率连乘 $\prod_t P(y^{\langle t\rangle}\mid x,y^{\langle 1\rangle},\ldots,y^{\langle t-1\rangle})$ 中每一项都小于 1,乘多了会数值下溢,所以改为对数求和。但每多一个词就多一个负数,目标天然偏爱短句。比较路径时应除以长度惩罚(指数约 $0.7$),否则短句占优: $$
\mathrm{score}(y)=\frac{1}{T_y^{\alpha}}\sum_{t=1}^{T_y}\log P(y^{\langle t\rangle}\mid y^{\langle t-1\rangle},x).
$$ $\alpha=1$ 为完全按长度归一化,$\alpha=0$ 为不归一化,$\alpha$ 是可调的超参数。实践中对每个长度 $T_y=1,\ldots,30$ 各保留束内的最优,再用上式统一比较。 翻译效果不好时,要判断是 RNN 模型的错还是束搜索的错,以免盲目增大 $B$ 或盲目收集数据。 法语 “Jane visite l’Afrique en septembre.” 人工译文 $y^{*}$ = “Jane visits Africa in September.”,算法输出 $\hat{y}$ = “Jane visited Africa last September.”。用训练好的 RNN 分别计算 $P(y^{*}\mid x)$ 和 $P(\hat{y}\mid x)$: 用了长度归一化时,比较的应是归一化后的得分。对开发集上所有出错的句子逐一判断、统计比例:只有束搜索出错的比例高时,增大 $B$ 才值得。 翻译常有多个同样好的答案,不能用准确率评价。BLEU(bilingual evaluation understudy)用修正的 $n$-gram 精确率与短句惩罚衡量翻译,对同义改写不敏感,只是自动代理。 法语 “Le chat est sur le tapis.” 有两个参考译文:Reference 1 “The cat is on the mat.”,Reference 2 “There is a cat on the mat.” 一元组:机器输出 “the the the the the the the.” 共 7 个词,每个 the 都出现在参考中,普通精确率为 $7/7$,显然不合理。修正精确率把每个词的计数截断(clip)到它在单个参考译文中出现的最多次数:the 在 Reference 1 中出现 2 次,所以修正精确率为 $2/7$。 二元组:机器输出 “The cat the cat on the mat.” 的二元组为 修正二元组精确率 $p_2=4/6$。若输出与某个参考完全相同,各阶 $p_n$ 都是 1。 $$
p_n=\frac{\sum_{\mathrm{clip}}\mathrm{count}(\mathrm{ngram})}{\sum \mathrm{count}_{\mathrm{sys}}(\mathrm{ngram})},
$$ $$
\mathrm{BLEU}=\mathrm{BP}\cdot\exp\Big(\frac{1}{N}\sum_{n=1}^{N}\log p_n\Big).
$$ 注意力(Bahdanau et al., 2015):解码每一步用当前状态给源端各隐状态打分,softmax 后做加权和,得到上下文向量。源句不必压成单一向量 $a^{\langle T_x\rangle}$。作业实现 Bahdanau 即可。权重大不表示该位置具有因果关系。 人工翻译长句时,不会先把整句背下来再一口气译出,而是一段一段地看、一段一段地译。编码器–解码器却要求把整句记进一个向量:句子短时 BLEU 尚可,句子超过约 20 到 30 个词后 BLEU 明显下降。加入注意力后,BLEU 在长句上基本保持平稳。 编码器用双向 RNN(或 LSTM),源端第 $t'$ 步的特征为 $h^{\langle t'\rangle}=[\overrightarrow{a}^{\langle t'\rangle};\overleftarrow{a}^{\langle t'\rangle}]$(Ng 课上记作 $a^{\langle t'\rangle}$)。解码器是另一个单向 RNN,状态为 $s^{\langle t\rangle}$。生成第 $t$ 个词时: $$
e^{\langle t,t'\rangle}=v^{\top}\tanh\big(W_a[s^{\langle t-1\rangle};h^{\langle t'\rangle}]\big),
$$ $$
\alpha^{\langle t,t'\rangle}=\frac{\exp(e^{\langle t,t'\rangle})}{\sum_{k=1}^{T_x}\exp(e^{\langle t,k\rangle})},\qquad
c^{\langle t\rangle}=\sum_{t'=1}^{T_x}\alpha^{\langle t,t'\rangle}h^{\langle t'\rangle}.
$$ $\alpha^{\langle t,t'\rangle}$ 表示生成 $y^{\langle t\rangle}$ 时应对 $h^{\langle t'\rangle}$ 给予多少注意力,且 $\sum_{t'}\alpha^{\langle t,t'\rangle}=1$。 为什么 $e$ 要由 $s^{\langle t-1\rangle}$ 和 $h^{\langle t'\rangle}$ 决定:应该关注源句哪里,取决于已经译到哪了($s^{\langle t-1\rangle}$)以及源端各位置是什么内容($h^{\langle t'\rangle}$)。这个函数难以手写,所以用小网络学出来,与整个模型一起用梯度下降训练。 $\alpha^{\langle t,\cdot\rangle}$ 是源位置上的离散分布,$c^{\langle t\rangle}$ 是隐状态的期望。与硬对齐(每次只选一个源词)相比,软注意力可微。复杂度每解码步 $O(T_x d)$,总 $O(T_y T_x d)$。源或目标很长时这仍贵,但比让单一向量承担全部记忆要稳。 作业用注意力模型把各种人写的日期转成标准格式,例如 “Tuesday 09 Oct 1993” 或 “July 20th 1969” 转成 “1993-10-09” 或 “1969-07-20”。把 $\alpha^{\langle t,t'\rangle}$ 画成热力图,可以看到输出月份 “10” 时注意力集中在输入的 “Oct” 上,输出年份时集中在 “1993” 上。 语音识别的输入是音频(常先转为声谱图),输出是文字。10 秒音频按 100 Hz 采样特征有 1000 个输入步,而转写文字只有几十个字符,$T_x\gg T_y$ 且对齐未知。 触发词检测(trigger word detection)识别 “Alexa”、“Hey Siri” 这类唤醒词: 到这里注意力仍依附 RNN 编码器-解码器,时间维必须串行计算。下一节让 $Q,K,V$ 都来自同一序列,称为自注意力,从而去掉循环;顺序改由位置编码写入。 架构、多头与位置编码的展开见 Transformer论文精读。 Transformer(Vaswani et al., 2017)用自注意力代替循环:同一层里任意两个位置可以直接交互,训练可以对时间维并行。顺序不由递推产生,必须另加位置编码。复杂度 $O(T^{2}d)$。展开见精读笔记。 复杂度一路上升:RNN → GRU → LSTM,每个单元越来越复杂,但都是顺序处理:第 $t$ 步必须等第 $t-1$ 步算完,每个单元都是信息流的瓶颈。CNN 则可以并行处理所有位置。Transformer 把注意力的“按需读取”与 CNN 的“并行计算”结合起来: “Jane visite l’Afrique en septembre.” 中 “l’Afrique” 的表示不应是固定的:它在这里是旅行目的地,在别的句子里可能是历史话题或经济话题。自注意力给每个词 $x^{\langle i\rangle}$ 算三个向量: $$
q^{\langle i\rangle}=W^{Q}x^{\langle i\rangle},\qquad
k^{\langle i\rangle}=W^{K}x^{\langle i\rangle},\qquad
v^{\langle i\rangle}=W^{V}x^{\langle i\rangle}.
$$ 借用数据库检索来理解:查询(query)$q^{\langle 3\rangle}$ 相当于为 l’Afrique 提出的问题“那里发生了什么?”;每个词的键(key)$k^{\langle j\rangle}$ 用来和查询比对,$q^{\langle 3\rangle}\cdot k^{\langle 1\rangle}$ 衡量 Jane 对这个问题有多相关(“访问”这个词可能最相关);值(value)$v^{\langle j\rangle}$ 是被取出的内容。对内积做 softmax,再对值加权求和: $$
A\big(q^{\langle 3\rangle},K,V\big)=\sum_{j}\frac{\exp\big(q^{\langle 3\rangle}\cdot k^{\langle j\rangle}\big)}{\sum_{l}\exp\big(q^{\langle 3\rangle}\cdot k^{\langle l\rangle}\big)}\,v^{\langle j\rangle}.
$$ 结构与 Bahdanau 注意力相同(打分 → softmax → 加权和),区别在于打分用内积,而且查询、键、值都来自同一序列。 把所有位置的 $q,k,v$ 按行堆成矩阵,一次算完: $$
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)V.
$$ $Q,K\in\mathbb{R}^{T\times d_k}$,$V\in\mathbb{R}^{T\times d_v}$。不除 $\sqrt{d_k}$ 时,点积方差约为 $d_k$,softmax 进入饱和,梯度消失。除以 $\sqrt{d_k}$ 使尺度与 $d_k$ 无关(若 $q,k$ 各分量独立、均值 0、方差 1,则 $q\cdot k=\sum_{i=1}^{d_k}q_ik_i$ 的方差为 $d_k$)。 因果掩码与 padding 掩码的构造,以及与 PyTorch 内置实现的对拍。注意 PyTorch 的布尔 只有因果掩码时,可以直接写 一次自注意力只能问一个问题(“那里发生了什么?”)。多头注意力用 $h$ 组不同的 $W_i^{Q},W_i^{K},W_i^{V}$ 问 $h$ 个问题(“什么时候?”“谁?”……),每组称为一个头(head)。 $$
\mathrm{head}_i=\mathrm{Attention}(QW_i^Q, KW_i^K, VW_i^V),
$$ $$
\mathrm{MultiHead}=\mathrm{Concat}(\mathrm{head}_1,\ldots,\mathrm{head}_h)W^O.
$$ PyTorch 的模块版本: $$
\mathrm{FFN}(x)=\max(0, xW_1+b_1)W_2+b_2.
$$ $$
\begin{aligned}
z &= \mathrm{LayerNorm}\big(x+\mathrm{MultiHead}(x,x,x)\big),\\
y &= \mathrm{LayerNorm}\big(z+\mathrm{FFN}(z)\big).
\end{aligned}
$$ 三类注意力的 $Q,K,V$ 来源不同: 原始 Transformer 常取前馈隐藏宽度 $d_{\mathrm{ff}}=4d_{\mathrm{model}}$。忽略偏置时,一层 FFN 的参数量为 $$
d_{\mathrm{model}}d_{\mathrm{ff}}
+d_{\mathrm{ff}}d_{\mathrm{model}}
=2d_{\mathrm{model}}d_{\mathrm{ff}}
\approx 8d_{\mathrm{model}}^{2}.
$$ 现代架构的倍率可以不是 $4$,考试应按题目给出的 $d_{\mathrm{ff}}$ 计算。Pre-LN 把 LayerNorm 放在子层之前,深层梯度通常更稳定;Post-LN 放在残差相加之后,是原论文结构。 LayerNorm 对最后一个特征维: $$
\mu=\frac{1}{d}\sum_{j=1}^{d}x_j,\qquad
\sigma^{2}=\frac{1}{d}\sum_{j}(x_j-\mu)^{2},\qquad
\mathrm{LN}(x)=\gamma\odot\frac{x-\mu}{\sqrt{\sigma^{2}+\varepsilon}}+\beta.
$$ PyTorch 的编码器块,写成 Pre-LN 形式(现代实现的默认);把两处 内置的 自注意力与输入的排列可交换,必须把位置写进表示。原论文把正弦、余弦加在嵌入上;后来常见可学习嵌入、相对偏置和 RoPE。序列长于训练长度时,正弦编码通常比绝对可学习嵌入更容易外推。 $$
\mathrm{PE}(pos,2i)=\sin\big(pos/10000^{2i/d}\big),\qquad
\mathrm{PE}(pos,2i+1)=\cos\big(pos/10000^{2i/d}\big).
$$ Transformer 在 token 序列上做前向。课堂扩展转到输入空间:对抗样本沿 $\nabla_x J$ 上升,使分类出错;生成器沿判别器给出的方向下降,用来采样。二者都对输入 $x$ 求梯度,不再只更新权重 $W$。 Coursera 五门课之外,CS230 课堂还讲了下面这些专题(按 2025 Autumn 的讲次排列): Lecture 2 的出发点是:模型 = 架构 + 参数。架构是选定的计算形式(逻辑回归、浅层网络、CNN……),参数是其中的 $W,b$。训练时,输入经过模型得到输出,与标签算出损失,再由梯度更新参数。在这个闭环里,可以改动的不只是参数,还有: 课上每个案例都按同一组问题来定:要什么数据、要多少?输入是什么?输出是什么?用什么架构?用什么损失、怎么训练? 这组问题的答案常常不是推导出来的,而是靠“类似项目的经验”和“拿人做实验”快速得到。 猫分类器扩展成“猫 / 狗 / 长颈鹿”时,权重从 $(n_x,1)$ 变成 $(n_x,3)$,每列对应一个类别。标签有三种写法: 图像里可能同时出现多个类别时,one-hot 本身就写不出正确标签,必须用 multi-hot。 网络中间层输出的向量称为编码(encoding):浅层检测边缘,再往上组合出眼睛、耳朵,再往上才是整张脸。课上区分了两个词:任何向量表示都可以叫编码;当向量之间的距离有含义(同一个人的两张照片距离近,不同人的距离远)时,才称为嵌入(embedding)。 见“项目策略 · 数据划分”中的例 3a。这个热身题要记住两点: 输入分辨率还要和硬件、迭代速度一起权衡:分辨率越高,每次实验越慢,一年内能做的实验次数就越少。 问题:给一段 10 秒音频,检测其中有没有说出 “activate”。 语音助手通常不是一个模型,而是一串由轻到重的模型,以节省能耗: 数据要覆盖什么: 触发词本身也要选好:常用词会让设备频繁误唤醒,课上说 “activate” 其实是个坏选择。音频的采样率不必自己推:找一个处理人声的开源项目,沿用它的超参数即可。 标签怎么定:课上做了一个人的实验。 对人更容易,对模型也更容易。方案一标起来省事,但模型可能需要多约 $1000$ 倍的数据才能学会,而方案二的标注成本远没有高出 $1000$ 倍,所以选方案二。它还能缓解冷启动:只有几千条手工数据时,方案一可能什么都学不到。 类别不平衡:10 秒里只有很短一段是 $1$,全预测 $0$ 也有 $99\%$ 以上的准确率。工程上的做法是在触发词结束后连续多帧标 1,让正负标签更平衡。 输出、架构与损失:每个时间步一个 sigmoid(“序列化的 sigmoid”),每步算二元交叉熵再求和;架构用 RNN,课上幻灯片给出的结构是多层 GRU、每层后接 BatchNorm,编程作业里最前面还有一层一维卷积(详见“序列与语言 · 语音识别与触发词”)。 数据怎么造:项目成败的关键在于数据收集策略,其次才是架构搜索与调参。 课上几个人拿手机在校园里录了约 3 小时,就合成出了数百万条训练样本:设有 1000 条正词、1 万条负词、无限多的背景噪声,组合数非常大。但合成数据只用于训练;test 要尽可能真实,需要手工录制和标注,好在 test 比 train 小得多。 问题:学校想在食堂、健身房、游泳馆刷学生卡时,用人脸确认刷卡的人就是卡的主人。 最简单的方案是逐像素比较两张图,距离小于阈值就放行。它很快失效:光照不同、留了胡子、证件照过时,像素距离都会很大。 课上的方案:用一个深度网络把每张脸编码成向量(课上用 128 维),比较向量距离。数据库里预先存好每个学生的编码;刷卡时只对新照片跑一次网络,与卡主的编码比距离,例如距离 $0.4$ 小于阈值就判 $1$。 于是训练样本是三元组:锚点 $A$、同一个人的正例 $P$、另一个人的负例 $N$。损失为 $$
\mathcal{L}=\max\Big(\big\lVert \mathrm{Enc}(A)-\mathrm{Enc}(P)\big\rVert_2^{2}-\big\lVert \mathrm{Enc}(A)-\mathrm{Enc}(N)\big\rVert_2^{2}+\alpha,\ 0\Big).
$$ 负例只在训练时用到;部署时只有“新照片”和“库里的编码”,不需要负例。三元组如何挑选、FaceNet 的细节,见“卷积与视觉 · 人脸验证与识别”。 同一个编码网络,换一个用法就能完成另外两个任务: 问题:给一张内容图和一张风格图,生成一张“内容像前者、风格像后者”的图。 完整的公式与实现见“卷积与视觉 · 神经风格迁移”。 课程中关于医疗的一讲(嘉宾 Pranav Rajpurkar)用几个斯坦福的项目说明:把上面的决策流程搬到医疗场景时,多出了哪些问题。 这些项目共同的经验: 上面四个案例都是监督学习:昼夜要人标 $0/1$,触发词要知道词的位置,人脸验证要知道哪些照片属于同一个人。标注很贵。如果只有大量“野生”的、没有标签的人脸照片,怎样训练出一个好的编码网络? 思路是让数据自己提供监督信号。把一张狗的照片旋转 $90^\circ$,人仍然认得出这是同一只狗;遮掉一张脸的左半边或右半边,剩下的部分仍属于同一个人。于是: 这类方法称为对比学习(contrastive learning),代表工作是 SimCLR。与 FaceNet(2015)相比,它不再需要人工构造的身份三元组,只需要“同一张图的两个变体”这样的正样本对。不需要标注,所以可以在数十亿张无标签图片上预训练,难点主要在算力。这样训出来的模型,即使训练时从没定义过“人脸验证”这个任务,学到的表示也能区分不同的人脸。 SimCLR 的损失称为 NT-Xent(normalized temperature-scaled cross entropy)。一个 batch 有 $N$ 张图、$2N$ 个变体;对变体 $i$,它的另一个变体 $j$ 是正例,其余 $2N-2$ 个是负例: $$
\ell_{i}=-\log\frac{\exp(\mathrm{sim}(z_i,z_j)/\tau)}{\sum_{k\neq i}\exp(\mathrm{sim}(z_i,z_k)/\tau)},\qquad
\mathrm{sim}(u,v)=\frac{u^{\top}v}{\lVert u\rVert\,\lVert v\rVert}.
$$ 它就是一个 $2N-1$ 类的 softmax 分类:在所有其他变体中认出“自己的另一半”。 文本上的自监督是 GPT 的核心:预测下一个词(next token prediction)。从网上抓来的句子本身就是标签,不需要人工标注。课上用几个填空说明,单单这一个目标,就逼着模型学会了很多从没被单独教过的东西: 这种从简单目标、大规模数据中出现的、没被显式教过的能力,称为涌现行为(emergent behavior)。后面强化学习里,智能体学出设计者没想到的策略(例如 AlphaGo),也是同一个现象。 同样的“遮掉一部分再让模型补全”可以用到别的模态: 要把文本和图像连到同一个向量空间,就需要成对的数据,例如图片配说明文字。这些配对不是专门为训练而标的,而是世界上自然同时出现的(社交网络上的图片配文)。这种学习称为弱监督(weakly supervised learning)。 课上学生找出的自然配对还有: Meta 的 ImageBind 进一步指出,不需要每两种模态之间都有配对:多数模态都能通过图像(或文本)连起来,例如热成像与图像配对,图像又与文本配对,于是热成像也间接和文本对齐。结果是所有模态被“绑”进同一个嵌入空间:输入文字 “drums”,可以检索到鼓声的音频和鼓的图片;输入一段狗叫声加一张海滩图,可以检索到“海滩上的狗”。 Lecture 3 由 Ng 主讲,以一个门禁人脸识别系统为例:员工刷卡后,系统再确认刷卡的人就是卡的主人,防止有人捡到或偷到卡就能进门。典型流程是: 人脸识别常用的结构是孪生网络(Siamese network):输入两张图,输出是否同一个人。这样每个新用户只需拍几张注册照,不必为每户人家重新训练一个网络。 课上的问题是:一家三人创业公司的 CTO,被律师告知不能从网上下载人脸数据,该怎么收集?花多久才开始训练? Ng 的原则是速度。他认为执行速度是创业公司(以及大公司内部的小型创新项目)能否成功的最强预测因素之一,所以倾向于选择能在一两天内拿到数据的办法,哪怕数据更少、质量更差: 理由是:事先很难知道数据里有什么问题,也很难知道哪部分数据有价值。Ng 讲过一个例子:有位 CEO 花了上亿美元收购一家公司,只为得到它的数据,事后却问 Ng 这些数据怎么变现。越早拿到数据、训出模型、看到它错在哪里,就越早知道数据该怎么改。 例外是做过很多次的同类项目:凭经验或文献已经知道,比如某种人脸识别系统至少要 5 万张图才有希望,就可以提前投入去收集。对第一次做的问题,优先保证迭代速度。 基于 LLM API 的应用也一样:提示词的效果事先无法预测,因为没人看过模型的训练数据,与其长时间琢磨,不如直接试,看到问题再改。安全性也是如此:先在沙盒里构建并反复探测系统,找出它会在哪里说出不当的话,测试充分之前不放给真实用户。 模型效果不好时,有两条路: 例如误差分析发现系统认不出戴帽子的人,就专门补充戴帽子的数据。不分青红皂白地“收集更多数据”通常低效:长发、短发、胡子、围巾、眼镜、侧脸……可补的子类太多,不先建系统、看错在哪,就无从决定该补哪一类。前沿大模型也不是“什么数据都抓”,而是找出值得投入的子类别。例如要提高写代码的能力,就专门构造高质量的代码数据,而不是更多随意的网络聊天。 数据质量同样重要:编辑过、有见地的书籍文章,比随意的网络聊天更适合训练语言模型;清晰对焦的人脸,比模糊的人脸更有用。 Ng 的回答是:重要,但没有多数人想的那么重要。10–15 年前,模型小、参数少,人们担心无关数据会“分散”模型的容量,所以执着于训练与测试同分布。今天网络足够大时,加入一些相关性不强的数据(只要不是错误的数据),通常不会有害,甚至略有帮助。例如在人脸数据里加入长相与真人差别很大的卡通人物,大概率无害。帮多少仍要靠实验。 他的类比是:学弹钢琴并不会让人做 AI 变差,因为大脑足够大。这与福尔摩斯的“阁楼理论”(脑容量有限,学新东西就得忘掉旧东西)相反,后者只在模型很小时才成立。 这一条与项目策略中“dev/test 必须与部署同分布”并不矛盾:放宽的是训练集,dev/test 仍要对准部署分布。 模型训好后,还有大量软件工程工作:把模型放到云端或本地服务器上,接收图片、返回“开不开门”。 实际系统往往不能把摄像头视频 24 小时、每秒 30 帧地传到云端逐帧识别,太贵也太慢。家门口的画面大部分时间只是一面墙,什么都没发生。常见做法是在前面加一级视觉活动检测(visual activity detection, VAD):一个低成本、低功耗的模块,先判断画面里有没有人,有人才把图片发给更重的人脸识别网络。VAD 有两种实现: 课上学生提出了各种组合(先用方案一过滤再接方案二、先用一后换二)。Ng 的做法仍然是先做最快的:先上方案一,部署出去看它在哪里失败。实际经验是,方案一确实不够好,最后会换成方案二;但先做方案一能更早发现问题,例如: VAD 与识别网络最好都能在边缘(edge,即设备本地)运行;只是每分钟上传几张图,则放在云端也没问题。 模型精度多少才算好?最好有一个参照水平,通常是人类水平(见“项目策略 · 人类水平”)。受控环境下,现在的人脸识别系统已经比大多数人更会判断两张照片是不是同一个人;推荐电影、书籍这类连人都做不好的任务,就很难确定参照水平。 模型在训练集、测试集上都很好,部署后却因为世界变了而失效: 更多例子: 简单模型更抗漂移。VAD 方案一只有一个参数 $\varepsilon$(变化像素的比例),夏天大家都戴墨镜,变化像素的比例也不会变多少,所以它很稳健。有成千上万个参数的神经网络,若训练时没人戴墨镜,就更可能过拟合到“不戴墨镜”,分布一变就得更新。 怎么监控: 发现漂移后的维护:收集能代表新分布的数据,刷新训练集,更新模型。 Ng 见过不少工程师认为“测试集上做得很好,工作就完成了”,而产品负责人的反馈是“系统不能用”。他的建议是:把自己的工作定义为做出真正能用的系统。测试集表现好、实际表现差时,应当追查原因并修正,常见原因就是数据分布已经改变,需要更新训练数据。这对应项目策略里的正交化目标“让数字对部署有意义”。 部署后的输入会自然漂移,也可能被人故意改动。下一节的对抗样本就是后者:对输入 $x$ 求梯度,构造人眼看不出、却能让模型出错的扰动;同一套“对输入求梯度”的工具,也能用来生成新数据。 对抗样本在输入上加很小的扰动,分类器就会以高置信度出错。生成模型学习 $P(x)$ 或 $P(x\mid y)$,用来采样,而不是只输出标签。二者都对 $x$ 求梯度,不再只更新 $W$。内容来自 2025 Autumn Lecture 4;Coursera C1–C5 没有对应编程作业。 FGSM(Goodfellow et al., 2015)沿 $\mathrm{sign}(\nabla_x J)$ 对输入走一小步,得到扰动很小、分类却错的 $x_{\mathrm{adv}}$。PGD 是同一方向上的多步投影。对抗训练把 $x_{\mathrm{adv}}$ 加入训练集。只报告 FGSM 准确率会高估稳健性。 Goodfellow 等的经典例子:一张被 GoogLeNet 以 $57.7\%$ 置信度识别为熊猫的图像,加上 $\varepsilon=0.007$ 倍的符号梯度噪声后,人眼看不出任何区别,模型却以 $99.3\%$ 的置信度判为长臂猿。 对抗样本(adversarial example)对安全敏感的系统是现实威胁:人脸门禁、自动驾驶的路标识别、内容审核都可能被精心构造的输入欺骗。 线性分类器 $w^{\top}x$ 在高维中对沿 $w$ 方向的小扰动敏感。取扰动 $\eta=\varepsilon\,\mathrm{sign}(w)$,每个分量的绝对值都不超过 $\varepsilon$($\|\eta\|_\infty=\varepsilon$),但 $$
w^{\top}(x+\eta)=w^{\top}x+\varepsilon\|w\|_1.
$$ 若 $w$ 有 $n$ 维、每维平均大小为 $m$,输出改变约 $\varepsilon mn$:每个像素只改一点点,但 $n$ 个像素的改变同方向累加,维度越高,越容易跨过决策面。神经网络中大量使用 ReLU 这类分段线性的单元,局部表现得很像线性模型,所以同样脆弱。 把 $w$ 换成损失对输入的梯度,就得到快速梯度符号法(fast gradient sign method, FGSM): $$
x_{\mathrm{adv}}=x+\varepsilon\,\mathrm{sign}(\nabla_x J(\theta,x,y)).
$$ $\varepsilon$ 很小(图像上常对应每个像素几级灰度)即可跨过决策面。注意这里固定参数 $\theta$,对输入求梯度并沿上升方向走,与训练时沿下降方向更新 $\theta$ 正好相反。迭代 FGSM / PGD(projected gradient descent)在 $\ell_{\infty}$ 球内多步投影: $$
x^{k+1}=\Pi_{\mathcal{B}_{\varepsilon}(x)}\big(x^{k}+\alpha\,\mathrm{sign}(\nabla_x J)\big).
$$ 投影 $\Pi$ 把每步结果裁回 $[x-\varepsilon,x+\varepsilon]$ 内,保证扰动始终足够小。 PyTorch 中 $\nabla_x J$ 由 autograd 直接给出:对输入设 对抗训练就是把内层 max 换成 PGD,外层照常训练:每个 batch 先 课上用更一般的形式统一各种攻击:固定网络参数,把输入当作变量,设计一个关于输入的损失再做梯度下降。例如想让一张猫的图被判成鬣蜥(iguana),同时看起来仍是猫: $$
x^{\ast}=\arg\min_{x}\ \underbrace{\big\lVert\hat y(x)-y_{\mathrm{iguana}}\big\rVert_2^2}_{\text{判成目标类}}+\lambda\underbrace{\big\lVert x-x_{\mathrm{cat}}\big\rVert_2^2}_{\text{离原图近}}.
$$ 第一项把预测推向目标类,第二项把图像约束在原图附近;$\lambda$ 越大,扰动越不可见,攻击越难成功。FGSM、PGD 是这个思路在 $\ell_\infty$ 约束下的快速近似。只保留第一项、从随机噪声出发,得到的是一张人看来毫无意义、网络却以高置信度判为鬣蜥的图:网络的决策区域远大于自然图像所在的区域。 对抗样本不只存在于像素层面: 这些攻击都要在优化目标里对一族变换取期望(随机旋转、缩放、光照,称为 expectation over transformation),使扰动在各种拍摄条件下都有效。它们说明对抗稳健性是自动驾驶、人脸门禁等安全攸关系统必须单独测试的指标。 $$
\min_{\theta}\ \mathbb{E}_{(x,y)}\Big[\max_{\|\eta\|_\infty\le\varepsilon}J(\theta,x+\eta,y)\Big].
$$ 生成模型学习 $P(x)$,用来采样,不是只输出标签。VAE(2014)最大化 $\log p(x)$ 的 ELBO,重参数化让采样可微。GAN(2014)让生成器与判别器对打,采样快,训练不稳,似然不好算。扩散模型先加噪再学去噪,训练稳,采样步数多。课堂要能对上谱系,不必推完 SDE。 之前的问题都是监督学习(supervised learning):数据集以“输入 + 标签”成对给出。生成模型只拿到大量样本(比如一堆卧室照片),没有标签,要学的是数据本身的分布 $P(x)$,这属于无监督学习(unsupervised learning)。学会之后,从 $P(x)$ 中采样就得到训练集中不存在的新样本。 自回归:$P(x)=\prod_t P(x_t\mid x_{ VAE:编码器 $q(z\mid x)$,解码器 $p(x\mid z)$,最大化 ELBO(evidence lower bound) GAN:生成器 $G(z)$ 与判别器 $D(x)$。原目标 扩散:逐步加噪到高斯,再学逐步去噪。训练稳定,采样步数多。课堂以直觉与应用为主,不要求推导全部 SDE。 条件生成(text-to-image、语音 vocoder)把 $y$ 注入归一化层或注意力。 评估用 FID、IS、人工偏好,不要只用训练损失。 $$
\log p(x)=\mathrm{KL}(q\|p(z\mid x))+\mathbb{E}_{q}[\log p(x\mid z)]-\mathrm{KL}(q(z\mid x)\|p(z)).
$$ $$
\frac{1}{2}\sum_j\big(\mu_j^{2}+\sigma_j^{2}-\log\sigma_j^{2}-1\big).
$$ 两项的含义:重构项要求从 $z$ 解码回来的样本像原图;KL 项要求各样本的 $q(z\mid x)$ 都接近标准正态,使隐空间连续、规整。训练好后,从 $\mathcal{N}(0,I)$ 采样 $z$ 送入解码器即可生成新样本。 PyTorch 版 VAE(MNIST,输入展平为 784 维、像素在 $[0,1]$)。编码器输出 $\mu$ 与 $\log\sigma^2$ 而不是 $\sigma$,这样网络输出无需约束为正;重构项取伯努利似然,即逐像素 BCE: 若写成 GAN(generative adversarial network)由两个网络组成: 两者以竞争的方式学习:生成器学到越来越精妙的“作假技术”,判别器成长为越来越精准的“鉴定师”,切磋到最后,生成器可能画出足以乱真的图像。 DCGAN(Deep Convolutional GAN)用大量卧室照片训练后,可以从零生成新的卧室图像。这些图像看上去像真照片,但训练集中并不存在,是谁都没有见过的新图。DCGAN 的生成器和判别器都是卷积网络:生成器用转置卷积把噪声向量逐步放大成图像,判别器是普通的分类 CNN。 最优判别器:固定 $G$,对每个 $x$ 最大化 $p_{\mathrm{data}}(x)\log D(x)+p_g(x)\log(1-D(x))$。对 $D$ 求导令其为零,得 $$
D^{\ast}(x)=\frac{p_{\mathrm{data}}(x)}{p_{\mathrm{data}}(x)+p_g(x)}.
$$ 代回目标,$G$ 最小化的是 $-\log 4+2\,\mathrm{JS}(p_{\mathrm{data}}\|p_g)$。JS 散度非负,当且仅当 $p_g=p_{\mathrm{data}}$ 时取到全局最小值 $-\log 4$,此时 $D^{\ast}\equiv\frac{1}{2}$:判别器完全分不出真假。 非饱和损失:训练初期生成器很差,$D(G(z))\approx 0$,此时 $\log(1-D(G(z)))$ 在 $0$ 附近非常平坦,梯度几乎为零,生成器学不动。改为最大化 $\log D(G(z))$(等价于最小化 $-\log D(G(z))$),它在 $D(G(z))\approx0$ 处梯度很大,最优点不变,但早期学得快。 一步 GAN 训练(非饱和损失)。判别器输出 logits,用 训练技巧(课上与 DCGAN、Salimans et al. 2016 的经验): 隐空间算术。DCGAN 论文发现,生成器的输入 $z$ 空间具有类似词嵌入的线性结构。取若干张“戴眼镜的男人”“不戴眼镜的男人”“不戴眼镜的女人”对应的 $z$,各自求平均后做 $$
z_{\text{戴眼镜的男人}}-z_{\text{男人}}+z_{\text{女人}}\approx z_{\text{戴眼镜的女人}},
$$ 送入生成器,得到的确实是戴眼镜的女人。在两个 $z$ 之间线性插值,生成的图像也平滑过渡,说明生成器学到的是连续的语义结构,而不是记住训练图片。 图像到图像的翻译: $$
\mathcal L_{\mathrm{cyc}}=\mathbb E_x\lVert F(G(x))-x\rVert_1+\mathbb E_y\lVert G(F(y))-y\rVert_1,
$$ 要求“马 → 斑马 → 马”回到原图,防止生成器随便输出一张与输入无关的斑马; DDPM 的训练步只有几行:随机取 $t$,用闭式一步加噪,让网络回归噪声。 Fréchet Inception Distance(FID)把真实图像与生成图像映射到 Inception 特征,分别拟合高斯,再比较均值与协方差: $$
\mathrm{FID}
=\|\mu_r-\mu_g\|_2^{2}
+\operatorname{tr}\left(
\Sigma_r+\Sigma_g
-2(\Sigma_r\Sigma_g)^{1/2}\right).
$$ FID 越低越好,同时反映样本质量与多样性,但依赖特征提取器、样本数和预处理协议。 Inception Score(IS)看单张图的类别分布是否尖锐,以及全体样本的边缘类别分布是否多样: $$
\mathrm{IS}
=\exp\left(
\mathbb{E}_{x}
D_{\mathrm{KL}}\big(p(y\mid x)\|p(y)\big)\right).
$$ IS 越高越好,但不直接与真实数据比较,也会受 Inception 类别空间限制。两者都不能代替人工偏好与任务指标。 对抗与生成仍假设标签或判别信号存在。强化学习去掉固定的 $(x,y)$:环境给奖励,网络近似价值 $Q$ 或策略 $\pi$。策略章里的偏差、方差和分布不匹配,在这里分别变成函数近似偏差、回报方差,以及仿真环境与真实环境不一致。 强化学习没有固定的 $(x,y)$,数据由当前策略与环境交互产生。DQN(2015)用网络拟合 $Q$,经验回放降低样本相关,目标网络稳定 TD 目标。PPO 直接优化策略,并用裁剪限制一次更新的幅度。探索不足时学习曲线长期为零,不一定是实现写错。 人学骑自行车不是靠老师逐个动作纠正,而是在不断尝试中自己摸索。让计算机在试错中自主学习,就是强化学习(reinforcement learning)。它与监督学习的区别在于:监督学习的每个输入都有“老师”给出的正确答案;强化学习只有事后的、往往延迟的奖励。 基本框架:智能体(agent)根据环境(environment)的状态选择动作(action),动作改变环境,智能体获得奖励(reward)。目标是学到一个行动方针(策略),使得到的奖励总和最大。 奖励往往不是即时明确的。在《超级马里奥兄弟》中,向右走一步能得多少奖励并不确定,要从游戏得分(硬币、消灭的敌人)或游戏结束这类明确指标反推出“预期奖励”。这也是强化学习比监督学习难的原因:一个动作的好坏可能要很多步之后才显现(信用分配问题,credit assignment)。 强化学习里没有固定的 $(x,y)$。智能体与环境交互,观察到状态 $s$、采取动作 $a$、得到奖励 $r$,目标是最大化期望回报 $G_t=\sum_{k=0}^{\infty}\gamma^{k} r_{t+k}$。深度网络用来近似策略 $\pi(a\mid s)$ 或价值 $Q(s,a)$。对应 2025 Autumn Lecture 5。 折扣因子 $\gamma\in[0,1)$ 让越远的奖励越不重要:一方面未来不确定,另一方面保证无限长的和收敛。若每步奖励都是 1,$G=\sum_k\gamma^{k}=\frac{1}{1-\gamma}$,$\gamma=0.99$ 时约为 100,可以理解为智能体大约“看” 100 步远。 取 $\gamma=0.9$。 $$
V^{\pi}(s)=\mathbb{E}_{a\sim\pi,s'}[r+\gamma V^{\pi}(s')].
$$ 为什么围棋要用强化学习。课上先问:能不能把围棋当监督学习做?输入是棋盘局面,标签是职业棋手下的下一步。这有三个问题: 真正关心的标签是延迟的:最后赢(1)还是输(0)。强化学习就是从这种延迟信号中学长期策略。 一排 5 个格子。从状态 2 出发,每步只能向左或向右走一格。状态 1 是普通垃圾桶(到达得 $+2$,终止),状态 5 是回收桶(到达得 $+10$,终止),状态 4 有一块巧克力(到达得 $+1$)。最多走 3 步,防止一直吃巧克力。 取 $\gamma=0.9$,用 Bellman 方程 $Q^{\ast}(s,a)=r+\gamma\max_{a'}Q^{\ast}(s',a')$ 从终点往回推。终止状态之后没有价值,$Q^{\ast}(1,\cdot)=Q^{\ast}(5,\cdot)=0$。 每行取最大值就是最优策略:一路向右,路过巧克力,最后进回收桶,回报 $0+0.9\cdot1+0.81\cdot10=9$,等于 $Q^{\ast}(2,\text{右})$。若 $\gamma$ 很小(例如 $0.1$),$Q(2,\text{右})=0.1\cdot(1+0.1\cdot10)=0.2<2$,最优策略变成直接扔进普通桶:$\gamma$ 是问题定义的一部分,改变它会改变最优策略。 状态和动作都很少时,可以用一张表存所有 $Q(s,a)$,用 Bellman 方程反复更新(Q 学习)。但游戏画面的状态数是天文数字,表存不下,于是用神经网络近似:输入状态 $s$,输出每个动作的 $Q$ 值。 $$
y_t=r_t+\gamma(1-d_t)\max_{a'}Q(s_{t+1},a';\theta^{-}),
\qquad
\delta_t=y_t-Q(s_t,a_t;\theta).
$$ $d_t=1$ 表示终止,后续价值必须置零。DQN 最小化 $\delta_t^{2}$ 或 Huber loss。目标网络参数 $\theta^{-}$ 暂时固定,避免预测值与目标同时快速移动。这相当于一个回归问题,只是“标签” $y_t$ 由网络自己估计出来。 以往让计算机学玩游戏,要先把游戏状态(角色位置等)人工提取出来交给模型。DQN 的输入只有游戏画面:把连续 4 帧画面(灰度化、缩小到 $84\times84$,叠成 $84\times84\times4$,4 帧可以体现运动方向)送入 CNN,输出游戏手柄每个动作(摇杆移动、按钮按下与否)的 $Q$ 值。 因此不必针对每个游戏改设置:同一个网络结构学会了《吃豆人》等许多 Atari 游戏,并在很多游戏中超过了人类水平。 课上以 Breakout(打砖块)为例,把 DQN 落地要定的几件事逐个列出: DQN 算法要点: PyTorch 版 DQN 的核心:回放缓冲区、$\varepsilon$-greedy、一步 TD 更新和目标网络同步。 DQN 先学价值再导出策略;策略梯度直接参数化策略 $\pi_\theta(a\mid s)$(例如网络输出动作上的 softmax),沿提高期望回报的方向更新 $\theta$。 REINFORCE: $$
\nabla_{\theta}J=\mathbb{E}_{\pi_{\theta}}\big[\nabla_{\theta}\log\pi_{\theta}(a\mid s)\,G_t\big].
$$ 直观含义:回报高的轨迹,提高其中各动作的概率;回报低的,降低其概率。形式上就像把 $G_t$ 当作样本权重的交叉熵。 $$
L^{\mathrm{CLIP}}=\mathbb{E}\big[\min\big(\rho\hat{A},\,\mathrm{clip}(\rho,1-\varepsilon,1+\varepsilon)\hat{A}\big)\big],
$$ $$
\rho=\frac{\pi_{\theta}(a\mid s)}{\pi_{\theta_{\mathrm{old}}}(a\mid s)}.
$$ REINFORCE 与 PPO 裁剪目标的 PyTorch 写法。 探索为什么难:Montezuma’s Revenge。DQN 在大多数 Atari 游戏上超过人类,却在《蒙特祖玛的复仇》上几乎得零分。这个游戏要先下梯子、跳过骷髅、拿到钥匙,才第一次得分;靠 $\varepsilon$-greedy 随机按键,几乎不可能碰巧完成这一长串动作,于是奖励永远是 0,网络什么也学不到。人一眼就知道“钥匙有用、骷髅危险、梯子能爬”,这些先验知识正是智能体缺的。课上提到的解决方向: 模仿学习。最简单的是行为克隆(behavior cloning):把专家的 $(s,a)$ 对当监督数据,训练 $\pi(a\mid s)$。问题是误差累积:策略一旦走偏一点,就进入专家从没去过的状态,那里没有训练数据,于是越偏越远。DAgger 让专家在策略自己走到的状态上补标注;GAIL(Ho & Ermon, 2016)用 GAN 的思路,判别器区分“专家轨迹”与“策略轨迹”,策略学着让判别器分不出来。RLHF 的第一步 SFT 本质上就是对人类示范做行为克隆。 DQN 与 PPO 对照(Lecture 5 的总结表): 课上最后提到的进阶方向:树搜索(AlphaGo 的蒙特卡洛树搜索,在决策时向前模拟多步)、策略梯度、元学习(meta-learning:任务分布相似时,从一族任务中学会“如何快速学新任务”,不必每次从零训练)。 AlphaGo 击败围棋世界冠军,内部同时用到深度学习和强化学习:先学习约 3000 万个职业棋手的棋谱局面(监督学习,得到初始策略),再不停地自我对弈积累经验(强化学习),并用价值网络评估局面、配合蒙特卡洛树搜索选点。AlphaGo 与 DQN 都出自 Google DeepMind。 2025 Autumn Lecture 5 把语言模型训练分成以下阶段。 $$
\mathcal{L}_{\mathrm{RM}}
=-\log\sigma\big(r_{\phi}(x,y_{\mathrm{chosen}})
-r_{\phi}(x,y_{\mathrm{rejected}})\big).
$$ $$
\max_{\theta}
\mathbb{E}_{y\sim\pi_{\theta}(\cdot\mid x)}
\left[r_{\phi}(x,y)
-\beta\log\frac{\pi_{\theta}(y\mid x)}
{\pi_{\mathrm{ref}}(y\mid x)}\right].
$$ PPO 的旧策略(old policy)$\pi_{\theta_{\mathrm{old}}}$ 用于构造裁剪概率比;RLHF 的参考策略(reference policy)$\pi_{\mathrm{ref}}$ 用于 KL 约束。二者角色不同,不能混成同一个分布。 奖励黑客(reward hacking)指策略利用奖励模型漏洞得到高分,却没有真正提高人类偏好。KL 太弱会漂移,太强则几乎不离开 SFT 模型。 在 RLHF 中,“状态”是提示加已生成的词,“动作”是下一个词,“奖励”只在整段回答结束时由奖励模型给出:这正是上文说的稀疏、延迟奖励。 为什么用成对比较,而不是直接打分。让标注者给一个回答打 1 到 10 分,不同人的尺度差别很大、同一人前后也不一致;判断“A 和 B 哪个更好”要稳定得多。奖励模型的损失来自 Bradley–Terry 模型:假设人类偏好 A 胜过 B 的概率为 $$
P(y_A\succ y_B\mid x)=\sigma\big(r(x,y_A)-r(x,y_B)\big),
$$ 对偏好数据做最大似然,就是上面的 $-\log\sigma(r_{\mathrm{chosen}}-r_{\mathrm{rejected}})$。它就是一个二分类交叉熵,logit 是两个回答的分数差,所以奖励只有差值有意义,整体加一个常数不影响。 DPO(direct preference optimization,Rafailov et al., 2023)是课后常见的延伸:对上面带 KL 约束的目标求最优策略,可以解出 $r(x,y)=\beta\log\frac{\pi^{\ast}(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)}+\text{常数}$。把它代回 Bradley–Terry 损失,奖励模型和强化学习两步合并成一个直接对策略的分类损失: $$
\mathcal L_{\mathrm{DPO}}=-\log\sigma\Big(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\mathrm{ref}}(y_w\mid x)}-\beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\mathrm{ref}}(y_l\mid x)}\Big),
$$ $y_w$、$y_l$ 是偏好和不偏好的回答。不需要单独训练奖励模型,也不需要在训练中采样,实现上只是监督学习。代价是只能利用已有的偏好数据,不能像 PPO 那样在新生成的回答上继续探索。 强化学习的数据由当前策略与环境交互产生。LLM 应用层相反:骨干已经预训练,调整的是提示、检索与工具,也就是条件 $x$ 怎么拼。评估仍按任务拆开,不能只报一个笼统的主观质量分数。 CS230 每学期都有一讲由 Ng 讲怎样读论文、怎样规划职业(2018 Autumn Lecture 8;2025 Autumn 排在 Lecture 6 / 9,课前可选读 Dropout 与 DenseNet 两篇论文)。课上会现场给几分钟,让学生按下面的方法读 DenseNet。 想快速进入一个新方向(例如语音识别)时: 读多少的粗略参考: 不要从第一个字读到最后一个字,而是分几遍读,先读信息密度高的部分,难的部分留到后面: 读完后用四个问题检查自己: 要真正理解一个算法: 职业上,Ng 推荐 T 型(T-shaped)的知识结构: 只有广度、没有深度,或者只在一个方向很深、对其他方向毫无了解,都不如 T 型。招聘方看重的是有深度的作品,不是项目数量。 骨干已经是预训练好的 $P(y\mid x)$ 时,产品效果往往取决于提示、检索、工具和评估,而不是再训一个网络。对应 2025 Autumn Lecture 8。 可调的手段按代价从低到高排列: 选择哪一种,应由误差分析决定,而不是默认从最贵的开始。 课上把提示工程称为“第一道优化”,因为它最便宜、迭代最快。从基础到进阶依次是: 1. 写清楚。“总结这篇文档”对模型来说缺了三样信息:文档是什么类型、要多长、给谁看。改成“用 5 条要点总结这篇 10 页的可再生能源论文,面向政策制定者,突出关键发现及其政策含义”,同时规定了类型、受众、格式和重点。 2. 零样本与少样本。零样本只给指令;少样本先给几个“输入 → 输出”示范,再给待处理的输入。课上的例子:判断 “The product is fine, but I was expecting more.” 的情感,零样本输出 Neutral;给出“It’s okay, but I wish it had more features. → Negative”等示范后,输出变成 Negative。示范定义了标注标准,模型按示范的标准判断,而不是按它自己的默认理解。 3. 思维链(chain-of-thought, CoT;Wei et al., 2022)。要求模型“一步步思考,不要跳步”,或者直接把步骤写出来: 第 1 步:找出论文最重要的三个发现;第 2 步:说明每个发现对政策的影响;第 3 步:写出 5 条要点,每条对应一个发现及其政策含义。 模型每生成一个词,计算量是固定的。让它先写出中间推理,相当于给难题分配了更多计算,算术、逻辑和多步推理题的准确率明显提高。 4. 提示链(prompt chaining)。与思维链不同,提示链是多次调用:把复杂任务拆成几个提示,前一个的输出作为后一个的输入。课上的例子是回复一封客户投诉: 比起一个大提示一步写完,提示链的每一步都可以单独检查、单独改进:回复不好时,可以先看是问题提取错了还是行文差,这与误差分析中“把流水线拆成组件、逐个看误差来源”的思路相同。 5. 提示模板。带占位符的固定结构,例如“为 [受众] 用 [格式] 总结以下文本:[文本]”。模板让同一类请求的提示一致,便于批量测试和版本管理。 6. 测试提示。像测试代码一样测试提示:准备一组测试用例,对每个提示版本打分(PromptFoo 等工具),用数字而不是印象决定换不换。打分可以是规则(是否包含关键字段),也可以用另一个 LLM 当评审(见“评估”一节)。 课上还引用了 BCG 的一项研究:咨询顾问在 AI 能力范围内的任务上使用 AI,效率和质量都显著提高;但在 AI 能力范围之外的任务上,使用 AI 的人反而比不用的人正确率低 19 个百分点。使用方式分两类:半人马(centaur)把任务切开,一部分交给 AI、一部分自己做;赛博格(cyborg)把 AI 融入每一步,持续交互。关键是知道任务落在 AI 能力边界的哪一侧。 RAG(Lewis et al., 2020)先检索 $k$ 段文档,再在这些证据上生成,不更新骨干权重。检索库可以更新事实;检索失败时生成仍可能流畅地编造,因此召回率要单独测。LoRA(2021)在线性层上加低秩 $\Delta W=BA$,适合改风格和格式;事实过时时应改检索库。 模型的知识截止于训练数据,私有文档也不在其中,直接问容易编造(幻觉)。RAG 把“记住事实”的负担交给可更新的检索库。 RAG 流水线可以写成与模型无关的步骤: 课上的定义:AI 智能体(AI agent)是一个自主的 AI 系统,利用上下文、记忆和工具进行推理并采取行动,完成复杂的多步任务。 RAG 与智能体的区别,课上用退款的例子说明: 组成部分(以课上的旅行预订智能体为例): 一次任务的执行流程:规划(把“订 12 月 15–20 日去巴黎的机票酒店并安排行程”拆成查航班、查酒店、生成景点、与用户确认、付款五步)→ 执行(按步骤调用工具、汇总结果)→ 与用户确认→ 完成动作(支付)→ 写入记忆。 智能体软件与传统软件的区别: 最后一行是最大的工程难点,这也是智能体系统必须有一套评估集、每次改动都回归测试的原因。 多智能体系统。把一个大智能体拆成多个专门的智能体,再由一个编排者(orchestrator)协调。课上的例子是智能家居:温控、照明、安防、能源管理、娱乐、通知六个智能体,各管一摊。组织方式有扁平、层级、顺序、并行几种。与单个智能体相比: 代价是协调开销和更多的调用成本。智能体之间如何分工,课上的说法是“像经理一样思考”(think like a manager):先想清楚岗位怎么划分,再决定每个岗位需要什么工具。 一个最小的工具调用循环(与具体模型无关, 课上对微调的态度是“谨慎使用”(proceed with caution),理由有三: 值得微调的情形:任务需要反复输出高精度、固定风格的结果(法律文书、科学解释),或者通用模型在某个领域的专有语言上一直表现不好。其他情况先把提示、提示链和 RAG 用到头。 课上把智能体系统的评估(evals)分成两类: LLM 评审便宜、可以大规模跑,但有已知偏差:偏好排在前面的回答(位置偏差)、偏好更长的回答(长度偏差)、偏好与自己风格相近的回答。常用对策是交换两个回答的顺序各评一次、在评分细则中明确长度不加分,并定期抽一部分与人工评分对比,确认二者一致。 误差分析时,还要区分客观错误(查错了订单号、调错了工具)和主观偏好(用户想要直飞而系统推荐了转机):前者要修流程或工具,后者要补记忆或改提示里的默认偏好。 这一讲最后,Kian 给了几条对未来的个人看法: 应用层调整的是条件 $x$。内部分析检查模型依据哪些特征做判断,以及某个子群是否被总体准确率掩盖。这些量用来决定下一实验,而不是写完报告再补说明。 可解释性要回答网络依据哪些特征做判断,以及失败能否定位到某一层、某类样本。工具包括学习曲线、切片指标、显著性和 Grad-CAM。这些量用来决定下一实验,不是写完报告再补的说明。对应 Lecture 10。 可用工具: 学习曲线:训练与 dev 损失、指标同图,区分欠拟合、过拟合、优化发散。 混淆矩阵(confusion matrix)与切片:按光照、语言、设备切片,避免总体准确率掩盖子群失败。 显著性 / Grad-CAM:$\partial y_c/\partial x$ 或特征图层的加权,检查模型是否盯着物体而非水印。 显著图可被输入变换愚弄,只能当假设生成器。 最近邻嵌入:把验证样本嵌到表示空间,看错例是否与另一类混叠。 消融(ablation):去掉增强、正则或某一数据源,量化贡献。 注意力权重、某神经元的最大化图都不是因果证明。 可解释性服务于误差分析与安全审查:决定下一周改数据还是改模型。 下面把 Lecture 10 中的几种方法逐个展开。 积分梯度(integrated gradients,Sundararajan et al., 2017)。显著图只看输入点处的梯度,有一个缺陷:网络在某个特征上已经饱和时(例如“大象鼻子”这个特征已经足够强,再强一点分数也不变),该处梯度接近 $0$,显著图会说这个特征不重要,实际上它最重要。积分梯度从一张基线图 $x'$(通常是全黑图)沿直线走到 $x$,把一路上的梯度累加: $$
\mathrm{IG}_i(x)=(x_i-x_i')\int_0^1\frac{\partial y_c\big(x'+t(x-x')\big)}{\partial x_i}\,\mathrm dt.
$$ 它满足完备性:所有像素的归因之和等于 $y_c(x)-y_c(x')$,即分数从基线到原图的总变化被完整分配到各个像素上,显著图没有这个性质。实际计算时用 $20$ 到 $300$ 个点做黎曼和。 数据集搜索(dataset search)。想知道某一层的第 $k$ 个通道在“找”什么,就把整个数据集过一遍,记录每张图在这个通道上的最大激活,取激活最大的前几张图看它们的共同点。再利用感受野,只截出对应的图像块,比看整张图更精确:某个通道的前 9 个图块全是狗脸,它大概就是“狗脸检测器”。它只需要前向,最简单,但只能看到数据集中已有的模式。 反卷积可视化(deconvnet,Zeiler & Fergus, 2014)。目标是把某个激活“追溯”回像素空间,看输入中是哪些像素让它亮起来。做法是保留这一个激活、把同层其他激活置零,然后把网络反过来走: 最终得到的图像显示出这个神经元“看到”的结构。Zeiler 和 Fergus 正是用它发现 AlexNet 第一层有失效的滤波器,调整步幅和核大小后得到了 ZFNet,赢下 ILSVRC 2013。 DeepDream(Mordvintsev et al., 2015)。思路与类别模型可视化相同,都是对输入做梯度上升;区别在于目标不是某个类别的分数,而是某一层激活的整体强度: $$
x\leftarrow x+\alpha\,\frac{\nabla_x L}{\lVert\nabla_x L\rVert},\qquad L=\frac12\big\lVert a^{[l]}(x)\big\rVert_2^2.
$$ 网络在这张图中“隐约看到”的东西会被放大:浅层放大纹理和笔触,深层放大眼睛、狗脸等物体部件。从一张真实照片出发,就得到那种满是狗脸和眼睛的迷幻图像。课上把它作为“网络学到了什么”的直观演示,而不是严格的解释工具。 几种方法的对比: Grad-CAM(Selvaraju et al., 2017)用 $\partial y_c/\partial A^{k}$ 对卷积特征图加权,得到该类别的热力图。它只提供假设:模型可能依据哪些区域。热力图对输入变换不稳定,需要再用遮挡或切片核对。 先说 CAM(class activation map,Zhou et al., 2016)。全连接层把空间信息打乱了,很难追溯回某个位置。CAM 要求网络末端是“最后一层卷积 → 全局平均池化(GAP)→ 一个全连接层”:最后一层特征图 $A^{k}$($k=1,\dots,K$)先在空间上取平均得到 $K$ 维向量,再乘全连接权重 $w^{c}_k$ 得到类别分数 $$
y_c=\sum_k w^{c}_k\cdot\frac1Z\sum_{i,j}A^{k}_{ij}=\frac1Z\sum_{i,j}\underbrace{\sum_k w^{c}_kA^{k}_{ij}}_{M_c(i,j)}.
$$ 求和可以交换顺序,于是类别分数等于热力图 $M_c=\sum_k w^{c}_kA^{k}$ 的空间平均:$M_c(i,j)$ 直接给出位置 $(i,j)$ 对类别 $c$ 贡献了多少。这就是课上说的“GAP 让信息更容易追溯回局部”。缺点是必须改网络结构并重新训练。 Grad-CAM 去掉了这个限制。最后一个卷积层的特征图既保留了空间位置,又已经包含高级语义。Grad-CAM 对任意结构的网络、卷积特征图 $A^{k}$ 与类别分数 $y_c$: $$
\alpha_k=\frac{1}{Z}\sum_{i,j}\frac{\partial y_c}{\partial A^{k}_{ij}},\qquad
L_{\mathrm{CAM}}=\mathrm{ReLU}\Big(\sum_k \alpha_k A^{k}\Big).
$$ $\alpha_k$ 是梯度在空间上的全局平均($Z$ 为空间位置数),表示第 $k$ 个通道对类别 $c$ 有多重要。对上面 CAM 的结构,$\partial y_c/\partial A^{k}_{ij}=w^{c}_k/Z$,所以 $\alpha_k=w^{c}_k/Z$,Grad-CAM 恰好退化为(差一个常数的)CAM:Grad-CAM 是 CAM 对任意网络的推广。 用 forward hook 截取特征图 $A$,用 用的是 softmax 之前的分数 $y_c$ 而不是概率:概率还受其他类别影响,梯度会被抵消。 遮挡实验的对照写法:用灰色方块滑过图像,记录 $y_c$ 的下降。 Lecture 10 的后半部分把同样的问题(模型内部在发生什么)搬到 Transformer 与 LLM 上。图像上的工具大多仍然适用,另外多了几样。 注意力图。每个注意力头的权重矩阵 $A=\mathrm{softmax}(QK^\top/\sqrt{d_k})$ 本身就是一张“第 $i$ 个词在看哪些词”的热力图(见 Transformer 一章)。翻译模型中能看到近似对角线的对齐;有些头专门把代词指向它指代的名词,有些头只看前一个词。注意事项与 Grad-CAM 一样:注意力权重大不等于这个词对输出的因果贡献大(Jain & Wallace, 2019),要配合遮挡词或替换词的实验检验。 探针(probing)。在冻结的中间层表示 $h^{[l]}$ 上训练一个很小的线性分类器,预测某个属性(词性、句法深度、“这句话是否真实”)。线性探针准确率高,说明这个信息以线性可读的形式存在于第 $l$ 层。逐层画出探针准确率,能看到浅层编码词法、中层编码句法、深层编码语义的趋势,与 CNN 的“边缘 → 纹理 → 部件”对应。 稀疏自编码器(sparse autoencoder,SAE)。单个神经元往往同时响应好几种不相关的概念(多义性,polysemanticity),直接看神经元很难解释。SAE 把 $h$ 重构为一个过完备、稀疏的特征组合: $$
f=\mathrm{ReLU}(W_e h+b_e),\qquad \hat h=W_d f,\qquad L=\lVert h-\hat h\rVert^2+\lambda\lVert f\rVert_1.
$$ $f$ 的维度远大于 $h$,但每次只有少数分量非零,每个分量往往对应一个可以命名的概念(例如“金门大桥”“代码中的 bug”)。把某个特征强行调大,模型的输出会随之偏向该概念,可以借此检验这个特征的作用。 规模定律(scaling laws,Kaplan et al., 2020;Hoffmann et al., 2022)。测试损失与参数量 $N$、数据量 $D$、计算量 $C$ 近似成幂律: $$
L(N)\approx\Big(\frac{N_c}{N}\Big)^{\alpha_N},\qquad L(D)\approx\Big(\frac{D_c}{D}\Big)^{\alpha_D},
$$ 在双对数坐标下是直线。这和“项目策略”一章的学习曲线是同一个工具:小规模实验拟合出直线,外推到大规模,决定钱花在更大的模型上还是更多的数据上。Chinchilla 的结论是,给定计算量时参数与 token 应同比例增长(约每个参数 20 个 token),此前很多大模型参数过多、训练数据不足。 基准与污染。MMLU、GSM8K、HumanEval 等基准衡量的是“模型在这批题上的表现”,有两个常见陷阱: 轨迹(traces)。对智能体系统,“内部”还包括每一步的提示、工具调用与返回结果。逐步读 trace,定位是哪一步出的错(检索没找到、工具参数错、推理错),与对 CNN 的误差表做切片是同一种思路。 MoE 路由。混合专家模型(mixture of experts)每个 token 只交给少数几个专家子网络处理。统计每个专家被选中的频率,可以看到有的专家专门处理代码、有的专门处理标点;如果大部分 token 都涌向少数专家(负载不均),训练时要加负载均衡损失。 学习曲线诊断: 训练损失不降:学习率、bug、标签错、初始化爆炸。 训练损失降、训练指标差:损失与指标不对齐(例如用 Acc 看交叉熵任务的阈值问题)。 训练好、dev 差且同分布:方差。 训练-训练 dev 好、真实 dev 差:不匹配。 损失出现 NaN:溢出、未裁剪、学习率过大、除零。 内部分析服务于误差分析:决定下一周改数据还是改模型。 期中若问“下一步做什么”,答案必须引用上述某一种曲线或误差表,而不是报层名。 内部分析给出可引用的曲线与误差表。下一章先把 Coursera 编程作业对回公式,再进入自选项目。Coursera 作业数据集不能直接充当项目。 每周编程与测验在 Coursera 的 Deep Learning Specialization,截止日期以 Syllabus 为准,不是 Coursera 默认周历。2025 Autumn:每周二 11:00 a.m. PST 之后算迟交。下面按作业写出核心函数与对拍检查,不照抄 notebook 题面。 Coursera Quiz 与英文短答必须能口述以下结论。 记号与课程一致:样本数是 $m$,特征矩阵 $X\in\mathbb{R}^{n_x\times m}$。标签 $y\in\{0,1\}$。迟交共 $10$ 天,单份最多 $3$ 天。 每份作业先在纸上写出 shape,再写代码。自动评分最常见的失败是 函数必须写在指定单元格内。笔记用于理解,不能整段贴进 Coursera。项目禁止把作业猫图或恐龙名字当新数据。 题在问什么。 先算一个数。单像素三通道 $x=(0.2,0.8,0.4)$,$w=(1,-1,0.5)$,$b=0$。$z=0.2-0.8+0.2= -0.4$,$a=\sigma(-0.4)\approx 0.401$。若 $y=1$,损失 $-\log 0.401\approx 0.91$,梯度 $dw=(0.401-1)x$。 向量化:$A=\sigma(w^{\top}X+b)$,$\mathrm{d}w=\frac1m X(A-Y)^{\top}$,$\mathrm{d}b=\frac1m\sum(A-Y)$。零初始化合法,因为没有隐层。图像必须先 要交的答案:训练准确率接近 $99\%$、测试大约 $70\%$ 量级(线性模型对猫图有上限)、学习曲线下降。 平面分类。花瓣形二维点,单隐层 $\tanh$ + 输出 sigmoid。隐单元太少(例如 $1$)画不出花瓣;太多且无正则会绕噪声。 逐步深层。第 $\ell$ 层:$Z^{[\ell]}=W^{[\ell]}A^{[\ell-1]}+b^{[\ell]}$,隐层 ReLU,输出 sigmoid。$W^{[\ell]}$ 的 shape 是 $(n^{[\ell]}, n^{[\ell-1]})$。He 初始化:$W\sim\mathcal{N}(0,2/n^{[\ell-1]})$。反向:输出 $\mathrm{d}Z^{[L]}=A^{[L]}-Y$。ReLU 的 $\mathrm{d}Z$ 在 $Z\le 0$ 处置零。 要交的答案:平面图决策边界、$L$ 层前向 / 反向通过单元测试、应用作业的 train / test 准确率。 初始化。全零:隐层对称,每个单元学同一函数。过大高斯:ReLU 网络的激活与梯度可能爆炸并数值溢出;sigmoid / tanh 则进入饱和区。He 对 ReLU,Xavier 对 $\tanh$。 $L_2$。代价加 $\frac{\lambda}{2m}\sum_\ell\|W^{[\ell]}\|_F^{2}$。梯度 $\mathrm{d}W$ 多一项 $\frac{\lambda}{m}W$。偏置不加。 Dropout。前向 $A\leftarrow A\odot D/\mathrm{keep}$,$D\sim\mathrm{Bernoulli}(\mathrm{keep})$。反向必须用同一 $D$,再除 $\mathrm{keep}$。测试阶段关掉 Dropout。 梯度检查。$\frac{J(\theta+\varepsilon)-J(\theta-\varepsilon)}{2\varepsilon}$ 与解析梯度的相对误差应 $<10^{-7}$。Dropout 与 BatchNorm 的随机性会毁掉检查,必须先关掉。 要交的答案:三种初始化的损失曲线、有 / 无 $L_2$ 与 Dropout 的决策边界、梯度检查相对误差。 mini-batch 把 $m$ 换成批大小。Momentum:$v\leftarrow\beta v+(1-\beta)\mathrm{d}\theta$,$\theta\leftarrow\theta-\alpha v$。RMSprop 用 $\mathrm{d}\theta^{2}$ 的指数平均做分母。Adam 两者都要做偏差修正: $$
\hat v_t=\frac{v_t}{1-\beta_1^{t}},\qquad
\hat s_t=\frac{s_t}{1-\beta_2^{t}},\qquad
\theta\leftarrow\theta-\alpha\frac{\hat v_t}{\sqrt{\hat s_t}+\varepsilon}.
$$ $t$ 从 $1$ 起算。漏掉偏差修正,前几步会过小。作业常用 $\beta_1=0.9$,$\beta_2=0.999$,$\varepsilon=10^{-8}$。 TensorFlow 作业只要求用 要交的答案:三种优化器的损失曲线、Adam 通常最快到低损失。 $$
n_{\mathrm{out}}=\Big\lfloor\frac{n_{\mathrm{in}}+2p-f}{s}\Big\rfloor+1.
$$ 例:$n=8$、$f=3$、$p=1$、$s=2$,输出 $4$。多通道:$W$ 的 shape 要交的答案:逐步卷积的单元测试、残差块图、迁移学习准确率。 YOLO。每格预测边界框与类别。过滤:置信度阈值,再非极大值抑制(non-max suppression, NMS),IoU 超过阈值的重叠框只留分数最高的。 风格迁移。内容损失用深层特征 $\|a_C-a_G\|^{2}$。风格损失用 Gram 矩阵 $G=aa^{\top}$ 的差。总损失 $\alpha\ell_{\mathrm{content}}+\beta\ell_{\mathrm{style}}$。优化的是生成图像像素,不是网络权。 人脸。验证是一次比较两张图的编码距离;识别是在库里找最近邻。三元组损失:$\|f(A)-f(P)\|^{2}+m\le\|f(A)-f(N)\|^{2}$。 U-Net。编码器下采样,解码器上采样,同分辨率的特征按通道拼接。分割输出每像素一个类。 要交的答案:NMS 后的框、风格图、编码距离阈值、U-Net 分割叠加图。 $$
a^{\langle t\rangle}=\tanh(W_{aa}a^{\langle t-1\rangle}+W_{ax}x^{\langle t\rangle}+b_a),\qquad
y^{\langle t\rangle}=\mathrm{softmax}(W_{ya}a^{\langle t\rangle}+b_y).
$$ 权在时间上共享。恐龙作业是字符级:输入一个前缀,输出下一个字符的分布。Jazz LSTM 把忘门 / 输入门 / 输出门按笔记逐步实现。 词向量去偏。把性别方向 $g$ 从职业词里减掉投影:$e\leftarrow e-(e\cdot \hat g)\hat g$。中性词应靠近,成对词关于 $g$ 对称。 Emojify。句子词向量平均后接 softmax,或改 LSTM。平均袋会丢掉词序: 注意力翻译。对齐分数 $e_{t,t'}=\tanh$ 或加性注意力,再 $\alpha_{t,t'}=\mathrm{softmax}_{t'}(e_{t,\cdot})$,上下文 $c_t=\sum_{t'}\alpha_{t,t'}h_{t'}$。$\alpha$ 对 $t'$ 求和必须为 $1$。 触发词。频谱图进一维卷积或 RNN,输出每帧是否在唤醒词上。类别极不平衡,正帧要加权。 Transformer。$Q=XW_Q$,$K=XW_K$,$V=XW_V$, $$
\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\Big(\frac{QK^{\top}}{\sqrt{d_k}}\Big)V.
$$ 多头把 $d_{\mathrm{model}}$ 切开再拼回。位置编码加在嵌入上。作业用 TensorFlow 搭编码器块,不是从零写反向。 要交的答案:RNN 单元测试、一段恐龙名、去偏前后的余弦表、注意力对齐图、触发词 F1、Transformer 的一次前向 shape。 作业按 Coursera 周组织。下一章把同一套模块接到自选数据:先基线,再误差表。Coursera 的数据集不能直接当作项目数据。 CS230 的主交付物是可复现的深度学习项目,不能把 Coursera 作业改个标题再交。时间线(2025 Autumn)是提案、中期、期末报告与海报。选题之后先约定指标和划分,跑通基线,再按误差表迭代。 提案模板(应对应 Section 1/2 的检查项): 问题一句话:输入、输出、谁用、错误代价。 数据:来源、许可、规模、正负比、划分方式、是否与部署同分布。 指标:一个优化指标 + 满意度约束。 基线:非深度学习或最浅网络的数字目标。 方法:为何该架构匹配该输入结构(网格 / 序列 / 图)。 算力:一次实验多久、计划实验次数。 风险与备选:数据不够时如何降级任务。 里程碑应包含:可复现的训练命令、基线表、至少 50-100 个错误样本的标注表、一张学习曲线。 最终报告写清负结果:哪些改动没有提升。 海报突出问题、数据、指标、误差分析驱动的一次关键改进,而不是层数列表。 与其他课合并时,CS230 部分必须能单独拆出:深度模型、训练曲线、与非深度基线的比较。 只交一个软件演示而没有误差分解,不符合课程评分。 常见失败:选题过大(“做通用自动驾驶”)、自采数据到中期仍无标签、用 test 调参、不固定 seed、把 Coursera 作业数据集改个标题当项目。 先做小、做完、再加范围。 复现检查: 代码仓库含 表格同时列出基线、本方法、消融(无增强 / 无预训练 / 无注意力)。 图的坐标轴有单位;学习曲线含 train 与 dev。 伦理:医疗与人脸数据的许可、是否可识别个人、是否只在聚合层面报告。 公开数据集起点(仍须自己钉指标与划分): 选用数据集后第一件事是统计标签分布与缺损,而不是先下预训练权重。 评分通常看:问题是否清楚、方法是否匹配数据、实验是否可复现、误差分析是否驱动迭代、写作是否诚实。 模型更大或损失更低本身不加分。 项目需检查拟合训练、拟合 dev 与拟合部署。复习章汇总公式与误差归因,两者都要能独立写出来。 $$
\begin{aligned}
\text{拟合训练} &\leftarrow \text{容量、优化、初始化},\\
\text{拟合开发} &\leftarrow \text{正则、数据、分布对齐},\\
\text{拟合部署} &\leftarrow \text{dev/test 是否与部署同分布}.
\end{aligned}
$$ 逻辑回归与 $L$ 层网络:shape、BCE 与 $A-Y$、反向缓存。 正则与优化:偏差-方差、Dropout、$L_2$、Adam 偏差修正、BatchNorm 推理统计。 策略:单一指标、人类水平、误差上限、不匹配。 CNN:尺寸公式、残差、YOLO+NMS、triplet、Gram 矩阵。 序列:BPTT、LSTM 门、注意力期望、$\mathrm{softmax}(QK^{\top}/\sqrt{d_k})$。 课堂扩展:FGSM、GAN/VAE/扩散、DQN/PPO、RAG 与切片评估。 期末闭卷通常覆盖前半:前向反向、超参数、策略案例、卷积尺寸。 编程作业覆盖实现细节。 项目覆盖能否把上述方法用到自选数据上。 英文题目首先看动作词(command verb),再看限制条件。 各章需要能从英文直接还原的核心词如下。 Why is scaling $\gamma$ and shifting $\beta$ applied after normalization? 标准化本身会限制表示只能保持零均值和单位方差。Learnable scale and shift restore the representational capacity of the layer. Is it always a good strategy to train with a large batch size? Why or why not? No. A large batch gives a lower-variance gradient estimate and better hardware utilization, but uses more memory, performs fewer updates per epoch, and may require retuning the learning rate. Which statement about Xavier initialization is false: “the variance remains unchanged throughout training”? 该陈述错误。Xavier controls variance only at initialization; subsequent parameter updates can change it. Why can a $1\times1$ convolution reduce channels without changing spatial dimensions? At every spatial location, it applies a learned linear combination across input channels. With stride $1$ and zero padding, height and width stay unchanged, while the number of filters sets the output channels. Why is KL divergence not a distance metric? It is generally asymmetric and does not satisfy the triangle inequality, even though it is non-negative. What happens if all hidden-layer weights are initialized to the same constant? All neurons produce the same output, receive the same gradient, and remain identical after every update. Random initialization is needed for symmetry breaking. 默写清单(与作业/期中对齐): $A^{[l]}$ 与 $W^{[l]}$ 的 shape; sigmoid/softmax 配交叉熵时 $\mathrm{d}Z=A-Y$。 He:$\mathrm{Var}=2/n^{[l-1]}$;Xavier:$2/(n_{\mathrm{in}}+n_{\mathrm{out}})$。 inverted dropout 训练除以 $p$,推理不丢弃。 Adam 的 $t$ 从 1 计,两个矩都要偏差修正。 BatchNorm 训练用 batch 统计,推理用 running average;$\gamma,\beta$ 可学习。 $n'=\lfloor(n+2p-f)/s\rfloor+1$;same 且 $s=1$ 时 $p=(f-1)/2$。 ResNet:$y=F(x)+x$;triplet:$\max(\|f_A-f_P\|^{2}-\|f_A-f_N\|^{2}+\alpha,0)$。 LSTM 六式;注意力 $\alpha=\mathrm{softmax}(e)$,$c=\sum\alpha h$。 $\mathrm{Attention}(Q,K,V)=\mathrm{softmax}(QK^{\top}/\sqrt{d_k})V$;因果掩码。 策略:单一优化指标、dev=部署分布、误差表算上限。 不能只背公式。 实现题会要求指出 shape 错误、忘记转置、推理期仍开 Dropout、或把 train 统计用在 BatchNorm 评估。 策略题会给一张误差表,要求选出下一实验并给出百分点上限。 Conda lock、container digest:固定 CUDA、驱动与 Python。只写“TensorFlow 2”不能复现 BatchNorm 与 GPU kernel 差异。 工具选择取决于输入张量约定、是否需要自定义反向、部署延迟和许可证。 论文、权重版本、预处理与随机种子应同时记录。 只写模型 zoo 里的名字,实验无法复现。采样
np.random.choice);<EOS> 或达到最大长度。若不希望出现 <UNK>,采到时就重采。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20def sample_char_model(params, seed_idx, ix_to_char, n_chars, rng, temperature=1.0):
"""从训练好的字符 RNN 采样一段文本。"""
n_a = params["Waa"].shape[0]
n_x = params["Wax"].shape[1]
a = np.zeros((n_a, 1))
x = np.zeros((n_x, 1))
x[seed_idx] = 1.0
out = [ix_to_char[seed_idx]]
for _ in range(n_chars):
a, y, _ = rnn_cell_forward(x, a, params)
logits = np.log(np.clip(y.ravel(), 1e-12, 1.0)) / temperature
p = np.exp(logits - logits.max())
p /= p.sum()
idx = int(rng.choice(n_x, p=p))
out.append(ix_to_char[idx])
x = np.zeros((n_x, 1))
x[idx] = 1.0
if ix_to_char[idx] == "\n":
break
return "".join(out)
BPTT(backpropagation through time)
时间反向传播
1
2
3
4
5
6
7
8
9
10
11def rnn_cell_backward(da_next, cache):
"""单步 BPTT。da_next 含本步输出误差与未来回传。"""
a_next, a_prev, xt, params = cache
Wax, Waa, Wya = params["Wax"], params["Waa"], params["Wya"]
dtanh = (1.0 - a_next ** 2) * da_next
dWax = dtanh @ xt.T
dWaa = dtanh @ a_prev.T
dba = dtanh.sum(axis=1, keepdims=True)
dxt = Wax.T @ dtanh
da_prev = Waa.T @ dtanh
return {"dWax": dWax, "dWaa": dWaa, "dba": dba}, dxt, da_prev
dWax, dWaa 求和(权值共享)。da_prev 传入前一步。梯度消失与爆炸
▸例2 长程依赖
1
2
3
4def clip_gradients(grads, max_value=5.0):
for k in grads:
np.clip(grads[k], -max_value, max_value, out=grads[k])
return grads
GRU
▸GRU
简化的 GRU
完整的 GRU
1
2
3
4
5
6
7
8def gru_cell_forward(xt, a_prev, params):
"""xt: (n_x, m), a_prev: (n_a, m);每个 W 为 (n_a, n_a + n_x)。"""
concat = np.vstack([a_prev, xt])
gu = sigmoid(params["Wu"] @ concat + params["bu"]) # 更新门
gr = sigmoid(params["Wr"] @ concat + params["br"]) # 相关门
cct = np.tanh(params["Wc"] @ np.vstack([gr * a_prev, xt]) + params["bc"])
a_next = gu * cct + (1.0 - gu) * a_prev
return a_next, (a_prev, xt, gu, gr, cct)nn.GRU 有两处与上式不同,对拍时要注意:
h = (1 - z) * n + z * h_prev,即 PyTorch 的 $z$ 对应这里的 $1-\Gamma_u$;LSTM
▸LSTM
1
2
3
4
5
6
7
8
9
def lstm_cell_forward(xt, a_prev, c_prev, params):
concat = np.vstack([a_prev, xt])
gf = sigmoid(params["Wf"] @ concat + params["bf"])
gi = sigmoid(params["Wi"] @ concat + params["bi"])
go = sigmoid(params["Wo"] @ concat + params["bo"])
cct = np.tanh(params["Wc"] @ concat + params["bc"])
c_next = gf * c_prev + gi * cct
a_next = go * np.tanh(c_next)
return a_next, c_next, (a_next, c_next, a_prev, c_prev, concat, gf, gi, go, cct, xt)nn.LSTM 把四组权重竖着拼成一个 (4·n_a, n_x) 的 weight_ih 和一个 (4·n_a, n_a) 的 weight_hh,顺序是输入门、遗忘门、候选、输出门(i, f, g, o):1
2
3
4
5
6
7
8
9
10
11
12
13def lstm_params_to_torch(params, n_x, n_a):
"""把作业的 Wf/Wi/Wc/Wo(作用于 [a; x])拆成 PyTorch 的 ih / hh 两块。"""
order = ["Wi", "Wf", "Wc", "Wo"] # PyTorch 的门顺序
W = np.vstack([params[k] for k in order]) # (4 n_a, n_a + n_x)
b = np.vstack([params["b" + k[1:]] for k in order])[:, 0]
return W[:, n_a:], W[:, :n_a], b # weight_ih, weight_hh, bias
lstm = nn.LSTM(input_size=n_x, hidden_size=n_a, num_layers=2,
batch_first=True, bidirectional=True, dropout=0.2)
x = torch.randn(m, T, n_x)
out, (h_n, c_n) = lstm(x)
print(out.shape) # (m, T, 2·n_a):每步把正向、反向隐状态拼接
print(h_n.shape) # (num_layers·2, m, n_a)
bidirectional=True 就是上文的 BRNN,num_layers=2 就是深层 RNN;dropout 只加在层与层之间。nn.utils.rnn.pack_padded_sequence 包装,否则补齐的 <pad> 也会更新隐状态。lstm.bias_ih_l0.data[n_a:2 * n_a].fill_(1.0)。门的作用对照
门
作用
使用者
更新门 / 输入门 $\Gamma_u$
新候选写入多少
GRU、LSTM
相关门 $\Gamma_r$
计算候选时用多少旧状态
GRU
遗忘门 $\Gamma_f$
旧记忆保留多少
LSTM
输出门 $\Gamma_o$
记忆暴露多少到 $a$
LSTM
反向与比较
双向与深层 RNN
Teacher forcing 与生成评估
▸Teacher forcing
▸衔接
词嵌入(Word Embeddings)
▸词嵌入
从 one-hot 到特征表示
▸例3 特征化的词表示
特征
Man
Woman
King
Queen
Apple
Orange
Gender
$-1$
$1$
$-0.95$
$0.97$
$0.00$
$0.01$
Royal
$0.01$
$0.02$
$0.93$
$0.95$
$-0.01$
$0.00$
Age
$0.03$
$0.02$
$0.70$
$0.69$
$0.03$
$-0.02$
Food
$0.09$
$0.01$
$0.02$
$0.01$
$0.95$
$0.97$
嵌入矩阵
Embedding 层)。学习嵌入
神经语言模型
Skip-gram
负采样
▸例4 负采样的训练样本
上下文 $c$
词 $t$
标签 $y$
orange
juice
1
orange
king
0
orange
book
0
orange
the
0
orange
of
0
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def neg_sampling_step(E, Theta, c, t, word_freq, k=5, lr=0.025, rng=None):
"""E, Theta: (|V|, d) 输入/输出嵌入;c, t: 上下文词与目标词下标。"""
rng = rng or np.random.default_rng()
p = word_freq ** 0.75
p = p / p.sum()
negs = rng.choice(len(p), size=k, p=p) # 负样本按 f^{3/4} 抽
ids = np.concatenate([[t], negs]) # 1 个正例 + k 个负例
labels = np.array([1.0] + [0.0] * k)
e_c = E[c] # (d,)
scores = Theta[ids] @ e_c # (k+1,)
g = sigmoid(scores) - labels # 每个二分类器的 a - y
loss = -np.log(sigmoid(scores[0])) - np.log(sigmoid(-scores[1:])).sum()
grad_e = g @ Theta[ids] # 对 e_c 的梯度
np.subtract.at(Theta, ids, lr * g[:, None] * e_c) # 负样本可能重复,用 at 累加
E[c] -= lr * grad_e
return lossnn.Embedding:前向是按下标查行,等价于 one-hot 乘 $E$,但不用真的构造 one-hot。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16class SkipGramNS(nn.Module):
def __init__(self, V, d=300):
super().__init__()
self.inp = nn.Embedding(V, d) # E:查 e_c
self.out = nn.Embedding(V, d) # Θ:查 θ_t
nn.init.uniform_(self.inp.weight, -0.5 / d, 0.5 / d)
nn.init.zeros_(self.out.weight)
def forward(self, c, t, negs): # c, t: (B,);negs: (B, k)
e = self.inp(c) # (B, d)
pos = (self.out(t) * e).sum(-1) # (B,)
neg = torch.bmm(self.out(negs), e.unsqueeze(-1)).squeeze(-1) # (B, k)
return -(F.logsigmoid(pos) + F.logsigmoid(-neg).sum(-1)).mean()
E = nn.Embedding(10000, 300)
print(E(torch.tensor([6257])).shape) # (1, 300):第 6257 个词(orange)的嵌入nn.Embedding.from_pretrained(weights, freeze=True);下游数据很少时冻结,较多时可以 freeze=False 一起微调。GloVe
相似度与类比
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15def cosine(u, v, eps=1e-12):
return float(u @ v / (np.linalg.norm(u) * np.linalg.norm(v) + eps))
def analogy(e, a, b, c, words):
"""解 a:b :: c:? 即 argmax cos(e[w], e[b]-e[a]+e[c])。"""
target = e[b] - e[a] + e[c]
best, best_s = None, -1.0
banned = {a, b, c}
for w in words:
if w in banned:
continue
s = cosine(e[w], target)
if s > best_s:
best, best_s = w, s
return best, best_s情感分类
去偏
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def neutralize(e, gender_dir):
"""去掉 e 在性别方向上的分量。"""
g = gender_dir / np.linalg.norm(gender_dir)
return e - (e @ g) * g
def equalize(e1, e2, gender_dir):
"""让成对词到性别方向的距离对称。"""
g = gender_dir / np.linalg.norm(gender_dir)
mu = (e1 + e2) / 2.0
mu_b = (mu @ g) * g
mu_orth = mu - mu_b
e1_orth = e1 - (e1 @ g) * g
e2_orth = e2 - (e2 @ g) * g
e1_new = mu_orth + np.sqrt(np.abs(1 - np.sum(mu_orth ** 2))) * (e1_orth / np.linalg.norm(e1_orth))
e2_new = mu_orth + np.sqrt(np.abs(1 - np.sum(mu_orth ** 2))) * (e2_orth / np.linalg.norm(e2_orth))
return e1_new, e2_new
king-queen 类比不应崩溃。▸衔接
注意力(Attention)
Seq2seq
▸Seq2seq
编码器–解码器
<EOS> 定界。条件语言模型
贪心与束搜索
<EOS>。
长度归一化
1
2
3
4
5
6
7
8
9
10
11
12def beam_search_step(prev_live, logp_step, beam_width):
"""prev_live: list[(seq_tuple, logprob)];logp_step[i] 为第 i 条活路在词表上的 log softmax。"""
cand = []
for i, (seq, lp) in enumerate(prev_live):
topk = np.argpartition(logp_step[i], -beam_width)[-beam_width:]
for tok in topk:
cand.append((seq + (int(tok),), lp + float(logp_step[i, tok])))
cand.sort(key=lambda x: x[1], reverse=True)
return cand[:beam_width]
def length_norm(logprob, length, alpha=0.7):
return logprob / (((5 + length) / 6) ** alpha)束搜索的误差分析
▸例5 RNN 的错还是束搜索的错
BLEU
▸例6 修正精确率
二元组
输出中次数
截断后次数
the cat
2
1
cat the
1
0
cat on
1
1
on the
1
1
the mat
1
1
Bahdanau 注意力
▸注意力
长句问题
计算
3. $s^{\langle t\rangle}$ 由解码器在 $[c^{\langle t\rangle}; y^{\langle t-1\rangle}]$ 上更新,再输出 $y^{\langle t\rangle}$。
▸注意力是期望
▸例7 日期格式翻译(作业)
1
2
3
4
5
6
7
8
9
10
11
12
13def bahdanau_attention(s_prev, H, Wa, va):
"""s_prev: (n_s, m), H: (n_h, m, T_x)。返回 context (n_h, m) 与 alpha (T_x, m)。"""
n_h, m, T_x = H.shape
s_exp = np.repeat(s_prev[:, :, None], T_x, axis=2)
concat = np.concatenate([s_exp, H], axis=0)
n_cat = concat.shape[0]
e = np.tanh(np.einsum("ij,jmt->imt", Wa, concat))
scores = np.einsum("i,imt->mt", va.ravel(), e)
scores -= scores.max(axis=1, keepdims=True)
alpha = np.exp(scores)
alpha /= alpha.sum(axis=1, keepdims=True)
context = np.einsum("mt,hmt->hm", alpha, H)
return context, alpha.TLuong 注意力与训练细节
语音识别与触发词
语音识别与 CTC
ttt_h_eee___ ___qqq__ 折叠为 “the q”。- c c - a - t 折叠为 cat。目标概率是所有能折叠成该标签序列的路径概率之和,不是只选一条对齐。前向后向动态规划(forward-backward dynamic programming)避免枚举指数级路径。触发词检测
▸衔接
Transformer
▸Transformer
动机
Scaled dot-product
自注意力的直觉
矩阵形式
1
2
3
4
5
6
7
8
9
10def scaled_dot_product_attention(Q, K, V, mask=None, eps=1e-9):
"""Q,K,V: (..., T, d)。mask 中 0 表示禁止位置。"""
d_k = Q.shape[-1]
scores = Q @ np.swapaxes(K, -1, -2) / np.sqrt(d_k)
if mask is not None:
scores = np.where(mask == 0, -1e9, scores)
scores = scores - scores.max(axis=-1, keepdims=True)
weights = np.exp(scores)
weights = weights / (weights.sum(axis=-1, keepdims=True) + eps)
return weights @ V, weightsattn_mask 中 True 表示允许,与上面“0 表示禁止”一致:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18def causal_mask(T):
return np.tril(np.ones((T, T))) # 下三角:位置 t 只看 t' <= t
def padding_mask(lengths, T):
"""lengths: (m,) 每句真实长度。返回 (m, 1, T),pad 位置为 0。"""
return (np.arange(T)[None, :] < np.asarray(lengths)[:, None])[:, None, :].astype(float)
T, d = 5, 8
rng = np.random.default_rng(0)
Q, K, V = (rng.standard_normal((2, T, d)) for _ in range(3))
mask = causal_mask(T)[None] * padding_mask([5, 3], T) # 两种掩码逻辑与
out_np, w = scaled_dot_product_attention(Q, K, V, mask)
out_t = F.scaled_dot_product_attention(
torch.tensor(Q), torch.tensor(K), torch.tensor(V),
attn_mask=torch.tensor(mask, dtype=torch.bool))
print(np.abs(out_np - out_t.numpy()).max()) # 约 2e-9:来自 NumPy 版分母上的 eps
print(np.round(w[1, 4], 2)) # 第 2 句第 5 个位置只把权重分给前 3 个真实词F.scaled_dot_product_attention(q, k, v, is_causal=True),它会在支持的 GPU 上自动调用 FlashAttention 等融合内核。多头
1
2
3
4
5
6
7
8
9
10
11
12def multi_head_attention(x, Wq, Wk, Wv, Wo, h, mask=None):
"""x: (m, T, d);W*: (d, d)。一次投射后拆成 h 个头。"""
m, T, d = x.shape
d_k = d // h
def split(Z): # (m, T, d) -> (m, h, T, d_k)
return Z.reshape(m, T, h, d_k).transpose(0, 2, 1, 3)
Q, K, V = split(x @ Wq), split(x @ Wk), split(x @ Wv)
if mask is not None:
mask = mask[:, None] # 在头维上广播
heads, weights = scaled_dot_product_attention(Q, K, V, mask) # (m, h, T, d_k)
concat = heads.transpose(0, 2, 1, 3).reshape(m, T, d) # 拼回 (m, T, d)
return concat @ Wo, weights1
2
3
4
5mha = nn.MultiheadAttention(embed_dim=512, num_heads=8, batch_first=True)
x = torch.randn(2, 10, 512)
causal = torch.triu(torch.ones(10, 10, dtype=torch.bool), diagonal=1) # True = 禁止!
out, attn = mha(x, x, x, attn_mask=causal, key_padding_mask=None)
print(out.shape, attn.shape) # (2, 10, 512),(2, 10, 10):默认对头取平均nn.MultiheadAttention 的布尔掩码约定与 F.scaled_dot_product_attention 相反:这里 True 表示“禁止看”。混用这两个接口时,最常见的 bug 就是掩码取反。块结构
<SOS> 开始,把已经生成的词作为输入;第一个多头注意力用已生成的词产生 $Q$、$K$、$V$;第二个多头注意力的 $Q$ 来自解码器,$K$、$V$ 来自编码器输出;最后经线性层和 softmax 预测下一个词。
LayerNorm
掩码
1
2
3
4
5
6
7
8
9
10
11
12
13def layer_norm(x, gamma, beta, eps=1e-6):
"""x: (..., d)。"""
mu = x.mean(axis=-1, keepdims=True)
var = x.var(axis=-1, keepdims=True)
return gamma * (x - mu) / np.sqrt(var + eps) + beta
def transformer_block(x, Wq, Wk, Wv, Wo, W1, W2, gamma1, beta1, gamma2, beta2, mask=None):
"""单层编码器:MHA + 残差 LN + FFN + 残差 LN。x: (T, d)。"""
Q, K, V = x @ Wq, x @ Wk, x @ Wv
attn, _ = scaled_dot_product_attention(Q, K, V, mask)
h = layer_norm(x + attn @ Wo, gamma1, beta1)
ff = np.maximum(h @ W1, 0.0) @ W2
return layer_norm(h + ff, gamma2, beta2)
swapaxes:头与时间维缠在一起,梯度检查失败。self.ln*(x) 挪到残差相加之后就是原论文的 Post-LN:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17class EncoderBlock(nn.Module):
def __init__(self, d=512, h=8, d_ff=2048, p=0.1):
super().__init__()
self.ln1, self.ln2 = nn.LayerNorm(d), nn.LayerNorm(d)
self.attn = nn.MultiheadAttention(d, h, dropout=p, batch_first=True)
self.ffn = nn.Sequential(nn.Linear(d, d_ff), nn.ReLU(), nn.Dropout(p), nn.Linear(d_ff, d))
self.drop = nn.Dropout(p)
def forward(self, x, pad_mask=None): # pad_mask: (m, T),True = pad
h = self.ln1(x)
a, _ = self.attn(h, h, h, key_padding_mask=pad_mask, need_weights=False)
x = x + self.drop(a) # 残差 1
x = x + self.drop(self.ffn(self.ln2(x))) # 残差 2
return x
blk = EncoderBlock()
print(sum(p.numel() for p in blk.ffn.parameters())) # 2·512·2048 + 2048 + 512 = 2099712 ≈ 8d²nn.TransformerEncoderLayer(d, h, d_ff, batch_first=True, norm_first=True) 与上面等价;norm_first=False 为 Post-LN。位置编码
▸位置编码
1
2
3
4
5
6
7
8
9
10
11def positional_encoding(T, d):
pos = np.arange(T)[:, None]
i = np.arange(d)[None, :]
angle = pos / (10000 ** (2 * (i // 2) / d))
pe = np.zeros((T, d))
pe[:, 0::2] = np.sin(angle[:, 0::2])
pe[:, 1::2] = np.cos(angle[:, 1::2])
return pe
def causal_mask(T):
return np.tril(np.ones((T, T)))▸复杂度对比
训练与推理
▸例8 掩码错误
▸对照:RNN、注意力、Transformer
▸衔接
课堂扩展
决策案例(Case Studies)
一个项目要定的几件事
▸多分类与多标签的输出编码
▸编码与嵌入
昼夜分类
触发词检测
人脸验证、识别与聚类
风格迁移
$$
\mathcal{L}=\big\lVert \mathrm{Content}_C-\mathrm{Content}_G\big\rVert+\big\lVert \mathrm{Style}_S-\mathrm{Style}_G\big\rVert,
$$
其中 $G$ 是生成图,$C$ 是内容图,$S$ 是风格图;▸四个案例的共同点
AI 与医疗
自监督与弱监督(Self- and Weakly Supervised Learning)
为什么需要
对比学习
1
2
3
4
5
6
7
8
9
10
11
12def nt_xent(z1, z2, tau=0.5):
"""z1, z2: (N, d),同一批图的两组增强变体经编码器 + 投影头的输出。"""
N = z1.size(0)
z = F.normalize(torch.cat([z1, z2]), dim=1) # (2N, d),余弦相似度 = 点积
sim = z @ z.T / tau # (2N, 2N)
sim.fill_diagonal_(float("-inf")) # 排除 k = i
target = torch.cat([torch.arange(N, 2 * N), torch.arange(0, N)]) # i 的正例下标
return F.cross_entropy(sim, target)
# 训练一步:
# x1, x2 = augment(x), augment(x)
# loss = nt_xent(proj(encoder(x1)), proj(encoder(x2)))
proj,只用 encoder 的输出做线性分类(linear probe)或微调。预测下一个词
句子
模型被迫学到的
I poured myself a cup of ___(tea / coffee / water)
能“倒”的是液体,而且要装得进杯子;tea 与 coffee 出现在相似语境里,所以表示相近
The capital of France is ___
事实性知识
She unlocked her phone using her ___(face / fingerprint / password)
语义:这几样都能用来解锁
The cat chased the ___(mouse / ball / dog)
概率性推理:多个答案都合理,各有频率
If it’s raining, I should bring an ___
条件与推断
弱监督与多模态
▸本讲出现的几个概念
项目全周期(Full Cycle of a DL Project)
流程
数据:先快,再好
数据不是一整块
▸训练数据一定要和测试同分布吗
部署
方案
做法
优点
缺点
一:非机器学习
与一秒前相比,RGB 变化超过阈值的像素若超过 $10\%$,就认为有动静
几行 Python,20 分钟写完;只有一个参数 $\varepsilon$
树叶晃动、路过的车、邻居的猫都会触发
二:小神经网络
训练一个很小的网络,只判断画面里有没有人
更准
要数据、要训练,至少花几个小时
监控与维护
▸工作是做出能用的系统,不只是测试集上的高分
▸衔接
对抗与生成(Adversarial and Generative Models)
对抗样本
▸FGSM
现象
▸例1 熊猫与长臂猿
为什么高维线性模型脆弱
FGSM 与 PGD
1
2
3
4def fgsm(x, grad_x, eps):
"""grad_x = dJ/dx,与 x 同形。像素若在 [0,1] 则裁剪。"""
x_adv = x + eps * np.sign(grad_x)
return np.clip(x_adv, 0.0, 1.0)requires_grad,模型参数保持不动。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29def fgsm_torch(model, x, y, eps):
model.eval() # 攻击时用推理态的 BN / Dropout
x = x.clone().detach().requires_grad_(True)
loss = F.cross_entropy(model(x), y)
grad_x, = torch.autograd.grad(loss, x) # 只对输入求导,不污染参数的 .grad
return (x + eps * grad_x.sign()).clamp(0, 1).detach()
def pgd_torch(model, x, y, eps=8/255, alpha=2/255, steps=10, random_start=True):
model.eval()
x_adv = x.clone().detach()
if random_start: # 在 ε 球内随机起点,攻击更强
x_adv = (x_adv + torch.empty_like(x).uniform_(-eps, eps)).clamp(0, 1)
for _ in range(steps):
x_adv.requires_grad_(True)
loss = F.cross_entropy(model(x_adv), y)
grad, = torch.autograd.grad(loss, x_adv)
x_adv = x_adv.detach() + alpha * grad.sign()
x_adv = torch.min(torch.max(x_adv, x - eps), x + eps).clamp(0, 1) # 投影 Π
return x_adv.detach()
def robust_accuracy(model, loader, attack, **kw):
correct = total = 0
for x, y in loader:
with torch.enable_grad(): # 攻击本身需要梯度
x_adv = attack(model, x, y, **kw)
correct += (model(x_adv).argmax(1) == y).sum().item()
total += y.numel()
return correct / totalx_adv = pgd_torch(model, x, y),再 model.train(),对 F.cross_entropy(model(x_adv), y) 做一步优化。把攻击写成优化问题
物理世界中的攻击
防御
生成模型
▸VAE、GAN、扩散
监督与无监督
四条谱系
$$
\mathbb{E}_{q}[\log p(x\mid z)]-\mathrm{KL}(q(z\mid x)\|p(z)).
$$
重参数化 $z=\mu+\sigma\odot\varepsilon$,$\varepsilon\sim\mathcal{N}(0,I)$,使采样路径可微。
$$
\min_G\max_D \mathbb{E}_{x}[\log D(x)]+\mathbb{E}_{z}[\log(1-D(G(z)))].
$$
训练不稳定:模式崩溃、梯度消失。WGAN 等用不同距离缓解。似然不可直接得。VAE
▸VAE 的 ELBO
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22def vae_elbo(x, mu, logvar, decoder_logpx, kl_weight=1.0):
"""返回要最大化的 ELBO;decoder_logpx 是 log p(x|z) 的像素和。"""
recon = decoder_logpx.mean()
kl = 0.5 * np.mean(np.sum(mu ** 2 + np.exp(logvar) - logvar - 1.0, axis=1))
return recon - kl_weight * kl
def vae_loss(x, mu, logvar, decoder_logpx, kl_weight=1.0):
"""优化器最小化负 ELBO。"""
return -vae_elbo(x, mu, logvar, decoder_logpx, kl_weight)
def reparameterize(mu, logvar, rng):
eps = rng.normal(size=mu.shape)
return mu + np.exp(0.5 * logvar) * eps
def pgd_linf(x, loss_grad_fn, eps, alpha, steps):
"""loss_grad_fn(x_adv) 返回 dJ/dx。"""
x_adv = x.copy()
for _ in range(steps):
g = loss_grad_fn(x_adv)
x_adv = np.clip(x_adv + alpha * np.sign(g), x - eps, x + eps)
x_adv = np.clip(x_adv, 0.0, 1.0)
return x_adv1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22class VAE(nn.Module):
def __init__(self, d_in=784, d_h=400, d_z=20):
super().__init__()
self.enc = nn.Sequential(nn.Linear(d_in, d_h), nn.ReLU())
self.mu, self.logvar = nn.Linear(d_h, d_z), nn.Linear(d_h, d_z)
self.dec = nn.Sequential(nn.Linear(d_z, d_h), nn.ReLU(), nn.Linear(d_h, d_in))
def forward(self, x):
h = self.enc(x)
mu, logvar = self.mu(h), self.logvar(h)
z = mu + torch.exp(0.5 * logvar) * torch.randn_like(mu) # 重参数化:随机性只在 ε
return self.dec(z), mu, logvar # dec 输出 logits
def vae_loss_torch(logits, x, mu, logvar, beta=1.0):
recon = F.binary_cross_entropy_with_logits(logits, x, reduction="sum") / x.size(0)
kl = 0.5 * (mu.pow(2) + logvar.exp() - logvar - 1).sum(1).mean()
return recon + beta * kl # = 负 ELBO
def vae_sample(model, n=16, d_z=20):
z = torch.randn(n, d_z) # 从先验 N(0, I) 采样
return torch.sigmoid(model.dec(z)).view(n, 1, 28, 28)z = torch.normal(mu, std),采样操作不可导,梯度无法传回编码器;重参数化把随机性移到与参数无关的 $\varepsilon$ 上。GAN
▸例2 DCGAN 生成卧室(鱼书 8.5.2 节)
BCEWithLogitsLoss 数值更稳:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16bce = nn.BCEWithLogitsLoss()
def gan_step(G, D, opt_G, opt_D, x_real, d_z=100):
m = x_real.size(0)
ones, zeros = torch.ones(m, 1), torch.zeros(m, 1)
# 1) 更新 D:最大化 log D(x) + log(1 - D(G(z)))
z = torch.randn(m, d_z)
x_fake = G(z)
loss_D = bce(D(x_real), ones) + bce(D(x_fake.detach()), zeros) # detach:不更新 G
opt_D.zero_grad(); loss_D.backward(); opt_D.step()
# 2) 更新 G:非饱和,最小化 -log D(G(z)),即把假图标成 1
loss_G = bce(D(x_fake), ones)
opt_G.zero_grad(); loss_G.backward(); opt_G.step()
return loss_D.item(), loss_G.item()
x_fake.detach() 不能省:否则判别器的损失会把梯度传进生成器。loss_G = -bce(D(x_fake), zeros),即最小化 $\log(1-D(G(z)))$;在 $D(G(z))\approx0$ 时梯度几乎为零。
GAN 的有趣性质与应用
扩散模型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22T = 1000
betas = torch.linspace(1e-4, 0.02, T)
alpha_bar = torch.cumprod(1 - betas, dim=0) # \bar{α}_t
def diffusion_loss(eps_model, x0):
m = x0.size(0)
t = torch.randint(0, T, (m,))
eps = torch.randn_like(x0)
ab = alpha_bar[t].view(m, *([1] * (x0.dim() - 1))) # 广播到图像形状
x_t = ab.sqrt() * x0 + (1 - ab).sqrt() * eps # 闭式加噪
return F.mse_loss(eps_model(x_t, t), eps)
def ddpm_sample(eps_model, shape):
x = torch.randn(shape) # x_T ~ N(0, I)
for t in reversed(range(T)): # 串行 T 步:采样慢的根源
tt = torch.full((shape[0],), t)
a, ab = 1 - betas[t], alpha_bar[t]
x = (x - betas[t] / (1 - ab).sqrt() * eps_model(x, tt)) / a.sqrt()
if t > 0:
x = x + betas[t].sqrt() * torch.randn_like(x)
return x生成评估
▸生成评估(generative evaluation)
▸对照:对 $x$ 的两种梯度
▸评估
▸衔接
强化学习(Reinforcement Learning)
▸DQN 与 PPO
基本框架
回报与价值
▸例3 折扣回报
DQN
从 Q 表到 Q 网络
▸课上的玩具问题:“回收是好事”(Recycling is good)
状态
1
2
3
4
5
含义
普通桶(终止)
起点
空
巧克力
回收桶(终止)
到达的奖励
$+2$
$0$
$0$
$+1$
$+10$
状态 \ 动作
左
右
1
0
0
2
2
9
3
8.1
10
4
9
10
5
0
0
1
2
3
4
5
6
7
8
9
10
11
12
13def q_value_iteration(n_states=5, rewards={1: 2, 4: 1, 5: 10}, terminal={1, 5}, gamma=0.9, iters=50):
Q = np.zeros((n_states + 1, 2)) # 下标 1..5;动作 0=左,1=右
for _ in range(iters):
for s in range(1, n_states + 1):
if s in terminal:
continue
for a, s2 in enumerate([s - 1, s + 1]):
future = 0.0 if s2 in terminal else Q[s2].max()
Q[s, a] = rewards.get(s2, 0) + gamma * future
return Q[1:]
print(q_value_iteration()) # [[0,0],[2,9],[8.1,10],[9,10],[0,0]]
print(q_value_iteration(gamma=0.1)[1]) # [2, 0.2]:γ 小时向左更好
▸例4 DQN 玩 Atari(鱼书 8.5.4 节)
terminal 标记游戏结束。终止时 TD 目标只有 $r$,没有 $\gamma\max Q(s',\cdot)$,否则网络会给“游戏已结束”的状态估出虚假的未来价值;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def discounted_returns(rewards, gamma=0.99):
"""rewards: 一条轨迹上的 r_0,...,r_{T-1}。"""
G, out = 0.0, []
for r in reversed(rewards):
G = r + gamma * G
out.append(G)
return np.array(out[::-1])
def reinforce_loss(log_probs, returns):
"""最大化期望回报等价于最小化 -log pi * G。"""
returns = (returns - returns.mean()) / (returns.std() + 1e-8)
return -np.sum(log_probs * returns)
def dqn_td_target(r, done, q_next, gamma=0.99):
"""r, done, q_next: (batch,)。目标网络给出 q_next = max_a Q(s',a; theta-)。"""
return r + gamma * (1.0 - done) * q_next1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import copy, random
from collections import deque
class ReplayBuffer:
def __init__(self, capacity=100_000):
self.buf = deque(maxlen=capacity) # 满了自动丢最旧的转移
def push(self, s, a, r, s2, done):
self.buf.append((s, a, r, s2, done))
def sample(self, batch_size):
s, a, r, s2, d = zip(*random.sample(self.buf, batch_size))
f = lambda v, dt=torch.float32: torch.as_tensor(np.array(v), dtype=dt)
return f(s), f(a, torch.long), f(r), f(s2), f(d)
def select_action(q_net, s, eps, n_actions):
if random.random() < eps:
return random.randrange(n_actions) # 探索
with torch.no_grad():
return q_net(torch.as_tensor(s, dtype=torch.float32)[None]).argmax(1).item()
def dqn_update(q_net, target_net, opt, buffer, batch_size=32, gamma=0.99):
s, a, r, s2, done = buffer.sample(batch_size)
q_sa = q_net(s).gather(1, a[:, None]).squeeze(1) # 只取实际执行动作的 Q
with torch.no_grad(): # 目标不回传梯度
q_next = target_net(s2).max(1).values
y = r + gamma * (1 - done) * q_next
loss = F.smooth_l1_loss(q_sa, y) # Huber loss
opt.zero_grad(); loss.backward()
nn.utils.clip_grad_norm_(q_net.parameters(), 10.0)
opt.step()
return loss.item()
q_net = nn.Sequential(nn.Linear(4, 128), nn.ReLU(), nn.Linear(128, 2)) # CartPole:4 维状态,2 个动作
target_net = copy.deepcopy(q_net).requires_grad_(False)
# 训练循环中每 C 步:target_net.load_state_dict(q_net.state_dict())
gather 只取出执行过的动作 $a_t$ 那一列:其他动作没有观测到奖励,不能产生损失。a2 = q_net(s2).argmax(1, keepdim=True),q_next = target_net(s2).gather(1, a2).squeeze(1)。在线网络选动作、目标网络评估,缓解 $\max$ 带来的高估。策略梯度
Categorical.log_prob 给出 $\log\pi_\theta(a\mid s)$,梯度由 autograd 完成:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28from torch.distributions import Categorical
def run_episode(policy, env):
"""policy(s) 输出动作 logits;env 为 gymnasium 风格接口。"""
s, _ = env.reset()
log_probs, rewards, done = [], [], False
while not done:
dist = Categorical(logits=policy(torch.as_tensor(s, dtype=torch.float32)))
a = dist.sample()
log_probs.append(dist.log_prob(a))
s, r, terminated, truncated, _ = env.step(a.item())
rewards.append(r)
done = terminated or truncated
return torch.stack(log_probs), rewards
def reinforce_step(policy, opt, env, gamma=0.99):
log_probs, rewards = run_episode(policy, env)
G = torch.as_tensor(discounted_returns(rewards, gamma), dtype=torch.float32)
G = (G - G.mean()) / (G.std() + 1e-8) # 标准化:相当于减去基线
loss = -(log_probs * G).sum()
opt.zero_grad(); loss.backward(); opt.step()
return sum(rewards)
def ppo_clip_loss(new_logp, old_logp, adv, clip_eps=0.2):
ratio = torch.exp(new_logp - old_logp.detach()) # ρ,用 log 差保证数值稳定
unclipped = ratio * adv
clipped = ratio.clamp(1 - clip_eps, 1 + clip_eps) * adv
return -torch.min(unclipped, clipped).mean() # 最大化 L^CLIPG 只是权重,不能对它求导;discounted_returns 在 NumPy 里算出来,天然不带梯度。若用 critic 的 $V(s)$ 作基线,优势要写成 adv = (G - V).detach(),critic 另用 F.mse_loss(V, G) 训练。探索与奖励设计
DQN
PPO
学什么
价值 $Q(s,a)$,策略是 $\arg\max_a Q$
直接学策略 $\pi_\theta(a\mid s)$
动作空间
离散
离散与连续都行
目标
回归 Bellman 目标
裁剪的代理目标,限制每次更新幅度
数据
离策略(off-policy),经验回放反复用旧数据
在策略(on-policy),每轮用当前策略新采的数据
探索
$\varepsilon$-greedy
随机策略本身带探索,可加熵奖励
稳定性
依赖目标网络与回放
通常更稳,靠裁剪与优势函数
典型应用
Atari
机器人控制、RLHF
▸奖励设计
▸例5 AlphaGo
RLHF
▸RLHF 流程(reinforcement learning from human feedback)
1
2
3def reward_model_loss(r_chosen, r_rejected):
"""r_*: (B,) 奖励模型对同一提示的两个回答打的分。"""
return -F.logsigmoid(r_chosen - r_rejected).mean()▸对照:监督、对抗、RL
▸衔接
读论文与职业(Reading Papers and Career Advice)
怎样读一个领域
读过的论文数
大致水平
$5$–$20$ 篇
对领域有基本了解,能实现、应用一些算法,但还不足以做前沿研究
$50$–$100$ 篇
对领域有很好的理解,足以开始做前沿研究
怎样读一篇
长期习惯与知识结构
LLM 应用(LLM Applications)
应用层
提示
RAG
▸RAG 与 LoRA
1
2
3
4
5
6
7
8
9
10
11
12
13def retrieve(query_vec, doc_vecs, k=5):
"""doc_vecs: (n_doc, d),已 L2 归一化时内积即余弦。"""
scores = doc_vecs @ query_vec
idx = np.argpartition(-scores, kth=min(k, len(scores) - 1))[:k]
idx = idx[np.argsort(-scores[idx])]
return idx, scores[idx]
def build_rag_prompt(question, chunks, idx):
evidence = "\n".join(f"[{i}] {chunks[j]}" for i, j in enumerate(idx, 1))
return (
"只根据下列证据回答。若证据不足,明确写出不知道。\n"
f"{evidence}\n问题:{question}\n回答:"
)工具与安全
智能体
传统软件
智能体软件
输入输出
结构化、强类型
自由文本,需要动态理解
逻辑
确定性规则,可重复
概率推理,结果不完全可预测
开发方式
写函数、写流程
设计提示、组合链与工具
维护
改一处很少影响无关功能
改一个提示可能悄悄弄坏其他流程
测试
给定输入有确定输出
需要反复、探索式地测试
llm 是任意返回文本的函数):1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import json
TOOLS = {
"get_order": lambda order_id: {"order_id": order_id, "days_since_purchase": 12},
"refund_policy": lambda: {"window_days": 30},
}
def run_agent(llm, user_msg, max_steps=5):
history = [{"role": "system", "content":
"可用工具: get_order(order_id), refund_policy()。"
"需要调用工具时只输出 JSON: {\"tool\": 名称, \"args\": {...}};否则直接回答。"},
{"role": "user", "content": user_msg}]
for _ in range(max_steps): # 步数上限:防止无限循环
reply = llm(history)
try:
call = json.loads(reply)
except json.JSONDecodeError:
return reply # 不是工具调用,就是最终回答
if not isinstance(call, dict) or "tool" not in call:
return reply
if call["tool"] not in TOOLS: # 校验:不执行未知工具
history.append({"role": "user", "content": f"未知工具 {call.get('tool')}"})
continue
result = TOOLS[call["tool"]](**call.get("args", {}))
history += [{"role": "assistant", "content": reply},
{"role": "user", "content": f"工具结果: {json.dumps(result, ensure_ascii=False)}"}]
return "超过最大步数,转人工处理。"history 就是这次任务的 trace:每一步模型说了什么、调了什么工具、拿到什么结果。智能体出错时,调试靠的就是逐步读 trace。LoRA
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21class LoRALinear(nn.Module):
"""包住一个已训练好的 nn.Linear:h = W x + (α/r) B A x。"""
def __init__(self, base: nn.Linear, r=8, alpha=16):
super().__init__()
self.base = base.requires_grad_(False) # 冻结 W 与 b
self.A = nn.Parameter(torch.randn(r, base.in_features) / r)
self.B = nn.Parameter(torch.zeros(base.out_features, r)) # B=0:初始时 ΔW=0,不改变原模型
self.scale = alpha / r
def forward(self, x):
return self.base(x) + (x @ self.A.T @ self.B.T) * self.scale
def merge(self):
"""部署时把 ΔW 合并进 W,推理零额外开销。"""
self.base.weight += self.scale * self.B @ self.A
return self.base
layer = LoRALinear(nn.Linear(4096, 4096), r=8)
trainable = sum(p.numel() for p in layer.parameters() if p.requires_grad)
print(trainable, trainable / 4096 ** 2) # 65536,约 0.0039
peft 库:LoraConfig(r=8, lora_alpha=16, target_modules=["q_proj", "v_proj"]) 指定只在注意力的 $W^Q,W^V$ 上加 LoRA。评估
1
2
3
4
5
6
7
8
9
10
11
12
13
14JUDGE_PROMPT = """角色:评审。根据评分细则给回答打 1-5 分,只输出 JSON {{"score": 整数, "reason": 字符串}}。
细则:1) 是否依据提供的证据 2) 是否回答了问题 3) 语气是否专业。回答长度本身不加分。
问题:{question}
回答:{answer}"""
def judge_pairwise(llm, question, a, b):
"""交换顺序各评一次,抵消位置偏差;两次结论不一致时记为平局。"""
ask = lambda x, y: llm(f"问题:{question}\n回答 1:{x}\n回答 2:{y}\n哪个更好?只输出 1 或 2。").strip()
first, second = ask(a, b), ask(b, a)
if first == "1" and second == "2":
return "a"
if first == "2" and second == "1":
return "b"
return "tie"
▸对照:改权重还是改上下文
▸注入与评估
▸衔接
内部分析
目的
显著性与遮挡
1
2
3
4
5
6
7
8
9
10def integrated_gradients(model, x, c, baseline=None, steps=64):
"""x: (1, 3, H, W)。返回与 x 同形的归因图。"""
model.eval()
baseline = torch.zeros_like(x) if baseline is None else baseline
t = torch.linspace(0, 1, steps).view(-1, 1, 1, 1)
path = (baseline + t * (x - baseline)).requires_grad_(True) # (steps, 3, H, W)
grads, = torch.autograd.grad(model(path)[:, c].sum(), path)
return (x - baseline) * grads.mean(0, keepdim=True) # 梯度沿路径平均再乘位移
# 完备性检查:ig.sum() ≈ model(x)[0, c] - model(baseline)[0, c],steps 越大越接近
1
2
3
4
5
6
7
8
9def deep_dream(model_upto_layer, x, steps=20, lr=0.01):
"""model_upto_layer: 截到目标层为止的子网络;x: (1, 3, H, W),已归一化。"""
x = x.clone().requires_grad_(True)
for _ in range(steps):
loss = 0.5 * model_upto_layer(x).pow(2).sum()
g, = torch.autograd.grad(loss, x)
with torch.no_grad():
x += lr * g / (g.abs().mean() + 1e-8) # 归一化步长,避免梯度尺度随层变化
return x.detach()
方法
回答的问题
需要梯度
代价
显著图
哪些像素对类别分数影响大
是
一次反向
积分梯度
同上,且归因之和等于分数变化
是
几十次反向
遮挡敏感度
遮住哪里分数下降
否
很多次前向
CAM / Grad-CAM
类别依据图中哪些区域
Grad-CAM 需要
一次反向
类别模型可视化
模型心中的“典型第 $c$ 类”长什么样
是
迭代优化
数据集搜索
某个神经元对哪些真实图像响应最强
否
遍历数据集
反卷积
某个激活由哪些像素引起
反向结构
一次反向
DeepDream
某层在图中“看到”了什么
是
迭代优化
Grad-CAM
▸Grad-CAM
torch.autograd.grad 求 $\partial y_c/\partial A$:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18def grad_cam(model, layer, x, target_class=None):
"""model: 分类网络;layer: 最后一个卷积块(如 resnet.layer4);x: (1, 3, H, W)。"""
model.eval()
store = {}
handle = layer.register_forward_hook(lambda m, inp, out: store.__setitem__("A", out))
logits = model(x)
handle.remove()
c = logits.argmax(1).item() if target_class is None else target_class
A = store["A"] # (1, K, h, w)
grads, = torch.autograd.grad(logits[0, c], A) # ∂y_c/∂A
alpha = grads.mean(dim=(2, 3), keepdim=True) # 空间全局平均 → (1, K, 1, 1)
cam = F.relu((alpha * A).sum(1, keepdim=True)) # (1, 1, h, w)
cam = F.interpolate(cam, size=x.shape[-2:], mode="bilinear", align_corners=False)
cam = (cam - cam.min()) / (cam.max() - cam.min() + 1e-8) # 归一化到 [0,1] 便于叠加显示
return cam[0, 0].detach(), c
# m = torchvision.models.resnet18(weights="IMAGENET1K_V1")
# heat, cls = grad_cam(m, m.layer4, img_tensor)1
2
3
4
5
6
7
8
9
10
11
12
13
def occlusion_map(model, x, c, patch=16, stride=8, fill=0.0):
_, _, H, W = x.shape
base = model(x)[0, c].item()
rows = []
for i in range(0, H - patch + 1, stride):
row = []
for j in range(0, W - patch + 1, stride):
x_occ = x.clone()
x_occ[..., i:i + patch, j:j + patch] = fill
row.append(base - model(x_occ)[0, c].item()) # 下降越多,区域越重要
rows.append(row)
return torch.tensor(rows)
大模型内部
1
2
3
4
5# 取出每层每个头的注意力:HuggingFace 模型加 output_attentions=True
# out = model(**tok("The animal didn't cross the street because it was tired", return_tensors="pt"),
# output_attentions=True)
# att = out.attentions[layer][0, head] # (T, T),第 i 行是第 i 个词对所有词的权重
# att[tokens.index("it")].topk(3) # "it" 最关注的 3 个词1
2
3
4
5
6
7
8
9def fit_power_law(N, L):
"""在 log-log 空间做线性回归:log L = a - alpha * log N。"""
alpha, a = np.polyfit(np.log(N), np.log(L), 1)
return -alpha, np.exp(a)
N = np.array([1e6, 1e7, 1e8, 1e9])
L = 5.0 * N ** -0.076 # 构造数据,指数取 Kaplan 报告的 alpha_N 量级
alpha, c = fit_power_law(N, L)
print(round(alpha, 3), round(c * (1e10) ** -alpha, 3)) # 0.076 ,外推到 1e10 参数的损失 0.869
切片与学习曲线
1
2
3
4
5
6
7
8
9
10
11def confusion_and_slices(y_true, y_pred, slice_ids):
"""slice_ids 如设备型号。返回总体混淆与各切片准确率。"""
k = int(max(y_true.max(), y_pred.max()) + 1)
cm = np.zeros((k, k), dtype=int)
for t, p in zip(y_true, y_pred):
cm[t, p] += 1
acc = {}
for s in np.unique(slice_ids):
m = slice_ids == s
acc[str(s)] = float((y_true[m] == y_pred[m]).mean()) if m.any() else None
return cm, acc
▸对照:解释与因果
▸衔接
作业(Assignments)
安排
周
模块
编程作业
L2
C1M1 / C1M2
Python Basics with Numpy(可选)、Logistic Regression with a neural network mindset
L3
C1M3 / C1M4
Planar data classification、Building your Deep Neural Network: step by step、Deep Neural Network Application
L4
C2M1 / C2M2
Initialization、Regularization、Gradient Checking、Optimization
L5
C2M3 / C3
Tensorflow
L6
C4M1 / C4M2
Convolutional Model step by step / application、Residual Networks、Transfer Learning with MobileNet
L7
C4M3 / C4M4
YOLO、Neural Style Transfer、Face Recognition、U-Net
L8
C5M1
RNN step by step、Dinosaur Island、Jazz LSTM
L9
C5M2 / C5M3
Word Vectors Debiasing、Emojify、NMT Attention、Trigger Word
L10
C5M4
Transformers Architecture with Tensorflow
测验
▸读法
(n_x, m) 与 (m, n_x) 对调,或 keepdims 丢了。
作业
易错点
逻辑回归
$X$ 是 $(12288, m)$;像素先
/255
深层网
缓存必须按层存 $A,W,b$;反向用前向的激活
正则
$L_2$ 只加 $\|W\|^{2}$,不加 $\|b\|^{2}$;Dropout 正向反向共用同一掩码
卷积
输出空间尺寸 $\lfloor(n+2p-f)/s\rfloor+1$
RNN
时间步循环在 $T_x$ 上,权跨步共享
注意力
$\alpha$ 对编码器时间求和为 $1$
▸对拍与荣誉守则
C1 浅层与深层
▸逻辑回归猫分类
(64,64,3) 图像展成 $12288$ 维列向量,学 $w,b$,输出 $P(y=1\mid x)$。/255,训练与测试用同一 reshape 顺序。学习率 $0.005$、$2000$ 步是该作业的常见能下降起点。1
2
3
4
5
6
7
8
9
10def propagate(w, b, X, Y, eps=1e-12):
"""X: (n_x, m), Y: (1, m), w: (n_x, 1)。返回代价与梯度。"""
m = X.shape[1]
A = 1.0 / (1.0 + np.exp(-(w.T @ X + b))) # (1, m)
A = np.clip(A, eps, 1.0 - eps)
cost = float(-(Y * np.log(A) + (1 - Y) * np.log(1 - A)).sum() / m)
dZ = A - Y
dw = (X @ dZ.T) / m # (n_x, 1)
db = float(dZ.sum() / m)
return cost, dw, db
▸平面数据与 $L$ 层网络
db 必须 keepdims=True。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21def linear_forward(A_prev, W, b):
# A_prev: (n_prev, m), W: (n, n_prev), b: (n, 1)
Z = W @ A_prev + b
return Z, (A_prev, W, b)
def relu(Z):
return np.maximum(0.0, Z), Z # 反向需要 Z 才能知道哪边是 0
def L_model_forward(X, parameters):
"""parameters 含 W1,b1,...,WL,bL。返回 AL 与 caches。"""
caches = []
A = X
L = len(parameters) // 2
for ell in range(1, L):
Z, lin = linear_forward(A, parameters[f"W{ell}"], parameters[f"b{ell}"])
A, act = relu(Z)
caches.append((lin, act))
ZL, lin = linear_forward(A, parameters[f"W{L}"], parameters[f"b{L}"])
AL = 1.0 / (1.0 + np.exp(-ZL))
caches.append((lin, ZL))
return AL, caches
C2 正则与优化
▸初始化、正则、梯度检查
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def compute_cost_with_regularization(AL, Y, parameters, lambd, eps=1e-12):
m = Y.shape[1]
AL = np.clip(AL, eps, 1.0 - eps)
cross = -(Y * np.log(AL) + (1 - Y) * np.log(1 - AL)).sum() / m
l2 = 0.0
for k, W in parameters.items():
if k.startswith("W"):
l2 += np.sum(W ** 2)
return float(cross + (lambd / (2.0 * m)) * l2)
def backward_relu_dropout(dA, cache, D, keep):
# cache 是前向 ReLU 的 Z;D 必须是前向那张掩码
Z = cache
dZ = np.array(dA, copy=True)
dZ[Z <= 0] = 0
dZ = (dZ * D) / keep
return dZ
▸Momentum / RMSprop / Adam
tf.Variable、GradientTape 与 optimizer.apply_gradients 复现同一逻辑,不要手写数值循环去“绕过”框架。
C4 卷积、残差、检测
▸卷积尺寸与前向
(f, f, n_C_prev, n_C)。池化没有要学的权,MaxPool 反向只把梯度送回 argmax 位置。残差块:$a_{\mathrm{out}}=\mathrm{ReLU}(F(a)+W_s a)$,捷径维数不对时 $W_s$ 是 $1\times 1$ 卷积。MobileNet 冻住卷积核,只训顶部分类头。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17def conv_forward(A_prev, W, b, hparams):
"""A_prev: (m, n_H, n_W, n_C_prev)。返回 Z 与 cache。"""
(m, n_H, n_W, n_C_prev) = A_prev.shape
(f, f, _, n_C) = W.shape
stride, pad = hparams["stride"], hparams["pad"]
n_H_out = (n_H + 2 * pad - f) // stride + 1
n_W_out = (n_W + 2 * pad - f) // stride + 1
A_pad = np.pad(A_prev, ((0, 0), (pad, pad), (pad, pad), (0, 0)))
Z = np.zeros((m, n_H_out, n_W_out, n_C))
for i in range(m):
for h in range(n_H_out):
for w in range(n_W_out):
for c in range(n_C):
hs, ws = h * stride, w * stride
window = A_pad[i, hs:hs + f, ws:ws + f, :]
Z[i, h, w, c] = np.sum(window * W[:, :, :, c]) + float(b[:, :, :, c])
return Z, (A_prev, W, b, hparams)
▸YOLO、风格、人脸、U-Net
C5 序列与 Transformer
▸RNN 一步
not good 与 good 可能撞车。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25def softmax(Z):
# 减最大值,避免 exp 溢出
Z = Z - Z.max(axis=0, keepdims=True)
e = np.exp(Z)
return e / e.sum(axis=0, keepdims=True)
def rnn_cell_forward(xt, a_prev, parameters):
"""xt: (n_x, m);a_prev: (n_a, m)。权跨时间共享。"""
Wax, Waa, Wya = parameters["Wax"], parameters["Waa"], parameters["Wya"]
ba, by = parameters["ba"], parameters["by"]
a_next = np.tanh(Waa @ a_prev + Wax @ xt + ba)
yt_pred = softmax(Wya @ a_next + by)
return a_next, yt_pred, (a_next, a_prev, xt, parameters)
def rnn_forward(x, a0, parameters):
# x: (n_x, m, T_x)。沿时间把隐状态传下去
n_x, m, T_x = x.shape
n_y = parameters["Wya"].shape[0]
a, y_pred = a0, np.zeros((n_y, m, T_x))
caches = []
for t in range(T_x):
a, yt, cache = rnn_cell_forward(x[:, :, t], a, parameters)
y_pred[:, :, t] = yt
caches.append(cache)
return y_pred, a, caches
▸衔接
项目(Project)
要求
▸例4 可执行的项目循环
requirements 或 lock 文件、随机种子、数据下载或划分脚本。
▸项目失败模式
▸衔接
复习(Review)
英文
▸公开试卷风格的英文问法
dW = dZ @ A_prev.T / m。▸三条失败轴
参考文献(References)
课程
优化与正则
卷积与检测
序列与注意力
对抗、生成与强化学习
工具(Tools)
数值与框架
training= 对 Dropout 与 BatchNorm 的切换。训练配套
视觉与检测
语言与检索
环境